前言
昨天在技术讨论群里,有个同学抛出了这样一个问题,大概意思是:他的计算引擎在每次处理一批数据(10万条)的时候,在将这10万条数据写入到数据库前,需要去查询Redis,确认是否都需要写入数据库,如果Redis有某些记录的信息,那么这些记录就不需要再次写入数据库。但是这样一来就需要将每条数据去Redis进行查询比对,以确保该数据是否存在,因此有10万次查询。于是该同学说这样非常的不合理,我不知道他当时指的是这个程序的设计不合理,还是这个10万次Redis查询本身不合理。
梳理其逻辑
从这个同学的描述来看,可以将这个程序的大概逻辑画成如下的流程图:
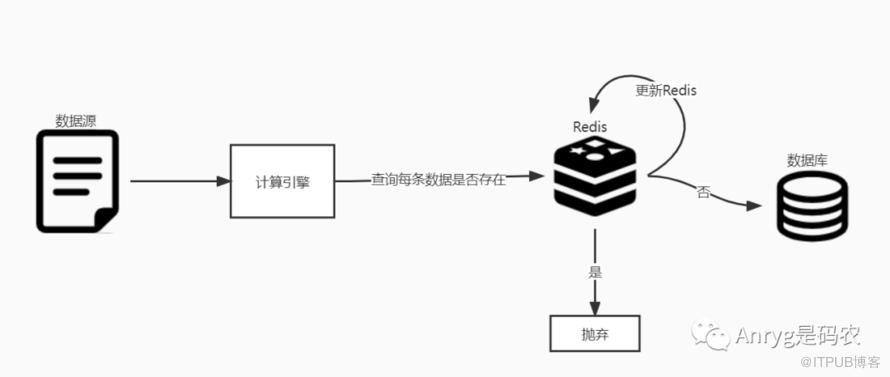
这个图中来看,为了数据避免写入数据库的重复,10万条数据就需要先从Redis查询10万次,如果该数据存在,则直接抛弃,如果不存在则写入到数据库,同时更新Redis。
这个时候有同学说,何必这么麻烦,每次写入时候直接查数据库不就行了吗?不需要Redis。听上去好像也可以,但是这种情况只适用于数据量小的时候,IO强度不高的情况下,如果数据量一大,这个方案是一定行不通的。
试想,每批数据处理都是10万的量,那过不了多久,你的数据库的存量数据将会是一个非常庞大的数字,比如过亿,这个时候如果你还是用这种直接查询数据库的方案,对数据库的【侵入性】太大,那你的数据库可能还没有来得及对外提供服务,就先被自己搞崩了。
这个时候,合理的加入一个【中间层】显得尤为重要。也应对了软件设计中的那句老话:没有一个软件设计问题是加入一个中间层解决不了的。
从大数据场景来说,这个架构设计是没有问题的,但是在程序的实现上需要注意一些地方。
Redis的合理设计
既然Redis的使用在这里必不可少,那么如何合理的使用它则成为了这个程序设计的关键。
很多同学可能觉得说,这个简单,我把数据每次写入到数据库后,再往Redis写一份不就完了吗?好像是可以,但是过于简单粗暴,因为你把原始数据【原封不动】的写入到Redis,那就意味着Redis的存储空间占用跟后面的数据库是一样的了,这个显然不合理,内存空间多贵啊。
怎么办?每次只存每条数据的key值到Redis?是一种思路,这样Redis的空间占用会大幅降低,但我认为还不是最优方案。
最优方案应该是设计一个Redis的布隆过滤器,既能有效减少Redis的存储空间,又没有过多降低其查询效率。
那么如何实现Redis的布隆过滤器?
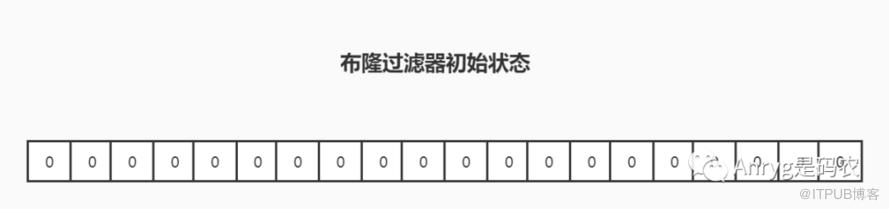
先来看看布隆过滤器的工作原理,本质是一个存储bit位的数组结构,既然是bit位,那么里面的内容就是0或者1,且每个位置只占用一个bit的大小,这样对比我们传统的存字符串或者数值,存储空间上要节省不少。

最简单的实现方式
就是每条数据写入时,取每条数据的唯一key(没有可以自己设计一个),然后将其通过一个特定的hash函数取hash值,再用该hash值与这个布隆过滤器的数组长度取模,最后落到这个数组对应的bit位上,将该bit位置为1。
这样,但凡你之前在数据库已经存在的数据,会在布隆过滤器这里的对应位置的bit位为1,如果不存在就为0。
好像这样就解决了问题,但是这里其实隐藏了一个【hash碰撞】的隐患,因为随着你后续数据量写入的持续增多,你hash碰撞的概率会持续增加(不同的key值对应的hash值相同的概率会持续增大)。 对于第1种方法来说,效果有限,这个只能尽量减少hash值跟布隆过滤器长度取模之后碰撞的概率,但是无法减少key通过hash函数得到相同hash值的概率。
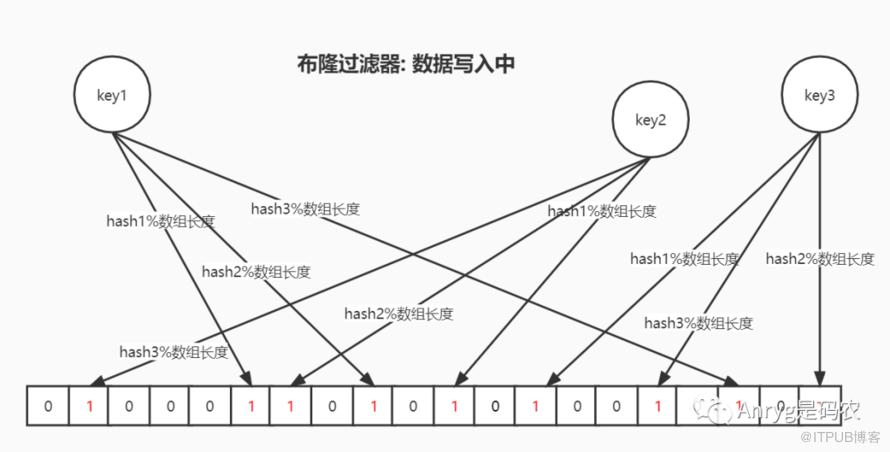
而第2种方法则可以有效避免这一点,比如每个key值在写入布隆过滤器时,经过3个hash函数分别取hash值,再跟布隆过滤器的数组长度取模,如下图所示:
优化后的实现方式
这样一来,每个key在写入时,需要判断或者修改3个bit位。在判断该key是否存在时,需要比对这3个bit位是否同时都为1,只要有一个为0,则说明该key之前不存在。 但是如果都为1呢,其实也不能100%说明该key就一定存在,因为有可能存在某些key即便经过3个不同hash函数的取值,也可能值都一样,这个时候就需要到数据库中进一步判断(没有别的办法了)。 但是有一点,设置的hash函数越多,hash碰撞的概率一定是越低的,但是同时也意味着你的效率越低,因此在程序设计时,需要你根据业务需求做出合理的取舍。
其他一些注意和优化的点
第一:在处理这个业务逻辑时,需要考虑一个比较重要的点就是事务性。因为你每次在数据写入数据库后一定要更新Redis(或者先更新Redis再写数据库),这两个动作一定要么都成功,要么都失败,否则容易造成数据的不一致。try { } catch (Exception e){ }
第二:因为每次查询的数量太大,在对Redis进行通信时,一定要注意连接的管理。我曾在团队小伙伴的代码里发现过,每处理一条数据都会建立一个新的连接(差点把我肺气炸),因为是分布式处理,因此你每一个executor中至少会维持一个连接,那么这个连接就不要释放了,维持直到该进程结束。
第三:可以考虑针对这个业务单独使用一个独立的Redis实例,跟其他业务分开,这样避免了因为该业务高频的Redis查询可能导致的Redis崩溃而影响其他业务。 第四:如果现在无法做到第三点,那么可以考虑每次在查询Redis之前,先将Redis要查询的整个数据读到你的进程中,用适当的数据结构来存放(一般都是map),然后在你的进程里查询,这样对Redis就没有任何侵入性了。
结语
——
软件设计中,很多棘手的问题都可以通过增加一个中间层来解决,如果一个不够,那就用两个。但是这个只是【战略】层面的胜利,如果想要你的设计真正高效的解决实际问题,里面还有很多【战术】层面的细节需要注意,上面这个栗子就是战略上没有问题,但是如果战术上实现不好,那么也只能徒劳。
如果你觉得我讲的东西还凑合,欢迎找我交流探讨...
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

