上篇文章为了验证 Spark 任务需要的内存,跟单个 partition 的数据量大小,以及数据计算逻辑复杂度有关,整个测试过程花了我4天时间,但从阅读量来看呢,就还,Emm... 容我先桑心一会。
上次的测试案例中,有个最大的特点,就是把 MySQL 作为数据源的时候,无论数据量多大,Spark 默认都只有一个分区。

这也就导致了每次数据量增加时,需要分配给 Spark 单个 partition 的内存越来越大,而隔壁的 HDFS,不管数据量增加到多大,Spark 却都可以淡定的保证内存一直不变。
因为当 HDFS 作为数据源时,无论多大的数据量,都会默认把它都切成一个个 128m 的数据块,这样就导致进入 Spark 的单个partition 数据量都很小。
这个时候肯定有同学会问:既然是这样的话,那 Spark 在读取 MySQL 的时候,如果直接扩展默认的分区为多个,这样需要的内存不就少些了吗?
这个想法到底靠不靠谱呢?
这篇文章,我们就一起来验证一下。
0. 解题思路
如果要把 Spark 读取 MySQL 时默认的1个分区,扩展到多个分区,Spark 能提供的最简单解决办法,目前为止有两个。
一个是利用「coalesce」算子:根据源码的解释,它能够在修改默认分区数量的同时,还能尽量避免数据的 shuffle,是我们这次测试的首选;
另一个是利用「repartition」算子:是 Spark 用来修改默认数据分区的传统方法。
那么接下来,我们用这两种方法,来分别试一试。
1. 利用「coalesce」算子
因为目前为止,Spark 读取 MySQL,只能以 jdbc 的方式,所以这个「coalesce」算子的使用,就只能这样:
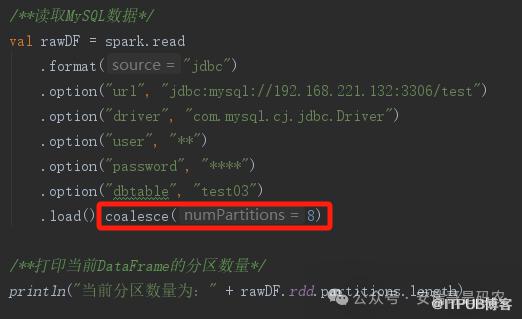
按理说,这样应该就可以把原本只有1个 partition 的数据,给拆成了 8 个 partition 了吧(当前 MySQL 表有1600w+条数据)。
但是,从我的实测结果来看,人家貌似根本不吃这一套,从分区打印信息来看
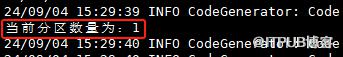
丝毫没有变化,一点面子都不给。
也就是说,想利用「coalesce」改变 MySQL 数据分区的想法,落空了。
2. 利用「repartition」算子
同样的,把上面的「coalesce」给换成「repartition」就可以了:
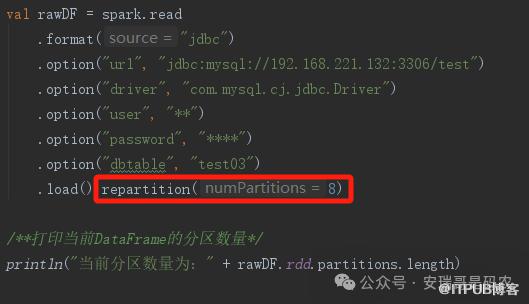
这一次,从程序打印的分区数量来看,确实是生效了。
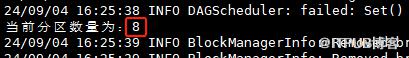
但是,付出的代价却是「惨痛」的。
当前 MySQL 的 1600w+ 数据量,是由之前 2 个 1G 的数据文件写进去的,在不尝试改变分区数之前,Spark 对它进行读取、运算时,对 executor 内存的设置只需要 2G。
--executor-memory 2g
然鹅,当我这次把分区数调整为 8 之后,你猜怎么着?
这 2G 的 executor 内存完全不够用(跑一段时间后就 OOM),后面我就只能逐渐增加这个内存大小。
直到把这个 executor 的内存,从开始的 2G,给逐渐加到 14G(就这么以一次1G的幅度试出来的)
--executor-memory 14g
人家才能跑成功。
关键是,费这么大内存换来的,却是一个「负性价比」的结果。
先看不做分区调整前,Spark 进程跑完需要的时间:
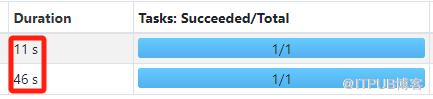
可以看到,过程非常简单,就2个stage,总耗时也就不到1分钟。
再看把分区调整到 8个之后,Spark 进程跑完需要的时间:
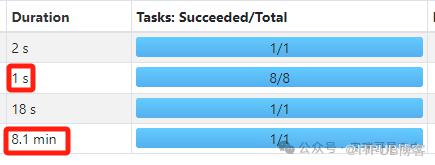
居然超过了8分钟,最最关键的是,扩展到8个分区之后,那8个分区需要的总处理时间,也就花了1秒钟而已,就问你惊不惊喜,意不意外?
3. 没事别扩展分区
对于「coalesce」来说,Spark 还算聪明,至少对于我当前的这个案例来说,它应该是预估出了,扩展分区数量并不是一个聪明的选择(费内存不说,还耗时间),所以,人家干脆就不鸟你,直接不生效。
相比之下,「repartition」就听话多了,要它扩展它就扩展,只不过呢,扩展分区之后的代价,需要你自行承担。
从原来的1个分区,扩展到8个,哪些数据进入到哪个分区,肯定就要根据一定的规则来,这里就一定会对数据进行比如「取哈希」或者「排序」(俗称 shuffle),这两个手段中的任意一个只要一上,就注定了 Spark 需要额外的「时间」还有「空间」。
这也就解释了,为什么上面把原本 1个分区的 MySQL 数据,给扩展到 8个之后,内存翻了好几倍不说,时间也翻了好几倍。
正所谓,赔了夫人又折兵,不划算惨了。
最后
为什么想到出这样一期实测,因为在现实开发中,发现有很多同学特别喜欢用这一招。
他们朴素的认为,想要提高一个分布式计算的效率,一个有效的办法,就是去增加计算时的「并行度」,但殊不知,在提高了并行度的同时,其他隐形成本可能也跟着大大提高了,得不偿失。
根据我的经验,类似这种问题,最好的解决方案,应该是尽量去避开这种不支持「分布式数据抽取」的数据源,如果说非要去读,且数据量巨大的话。
那么可以用其他抽取工具,先把它们以流的方式,或者小批量多次的方式,抽取到比如分布式消息队列、或者分布式文件系统中。
然后,再用 Spark 来读取,这样,无论你的数据读取效率,还是处理效率,都会有个质的提升。
你觉得呢?
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

