关于一个具体的 Spark 任务,需要设置多少内存这个问题,应该有很多同学都很关注。
但是呢,这个问题看似稀疏平常,但其实一点都不简单,因为它没有一个现成的公式可以准确套用,核心原因在于:除了跟任务读取的数据源、Spark 读取数据的方式有关外,还跟你要对这个数据采用的计算逻辑有密切的关系。
而在现实开发中,很多人对于 Spark 任务的内存设置,根本就没有一个很清晰的认识,基本遵循的都是「随心所欲」原则(包括很多大厂也一样),导致大量的内存浪费。
那么今天这篇文章,咱们就以相同的数据源,让它同时以 HDFS,跟 MySQL 作为数据源载体,然后,用 Spark 以相同的计算逻辑,对它们进行计算,最后将计算结果写到同一个存储里面。
以此来解密一个具体的 Spark 任务,它需要的内存大小,跟「数据总量」、「数据源载体」以及「计算逻辑」这 3 者之间的关联关系。
0. 测试设计
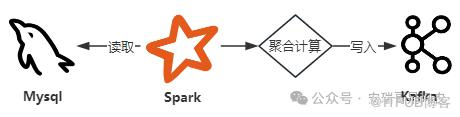
测试分为两组,第一组任务,将同一份数据存储在 MySQL 数据库里,以一定的计算逻辑进行计算,最后把计算后的结果,写入到 Kafka。
第二组任务,将相同的数据存储到 HDFS,以同样的计算逻辑计算后,最后把结果也写入到 Kafka。
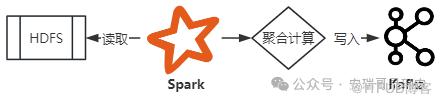
在这个过程中,我们通过同时改变数据量的大小,以及同时更换不同的计算逻辑(简单跟复杂),来观察这两组 Spark 任务需要的内存变化情况。
为了方便测试,我提前将存储到 HDFS 上的数据,给切成单个大小为标准的 1G 文件,共 11 个,在调整数据量量时,以每次一个的幅度递增。
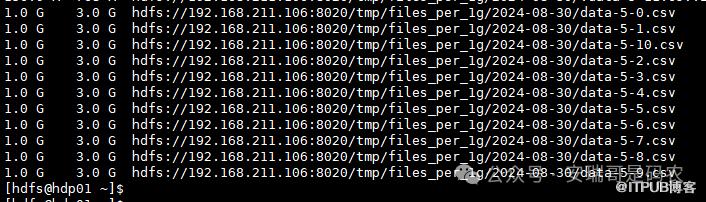
而存储到 MySQL 上的数据,也采用同样的数据集,以每次增加一个文件的数据量,写入到 MySQL 表里。
至于计算逻辑方面,为了说明简单的计算逻辑跟复杂计算逻辑在内存消耗方面的区别,这里的计算逻辑就只设计两个,「简单」跟「复杂」两个。当然,这里的复杂,也只是相对复杂。
来看一眼简单的计算逻辑:

再瞅一眼复杂一点的计算逻辑:

下面正式开始。
1. 1G数据量,采用「简单」计算时
为了方便对比,在后续计算时,我们所有的测试任务,都只用1个 executor,跟1核的 CPU。
1.1 MySQL 作为数据源时
我已经提前把一个 1G 数据量的文件数据,给灌到 MySQL 表里面了。
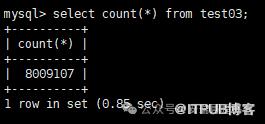
1G数据文件的数据条数

1G数据文件存储到MySQL的大小
经过多次我对内存的调整,能够把任务跑成功,此时 executor 设置的内存大小为:
--executor-memory 1g当前 yarn 占用的总内存大小为:2.5G
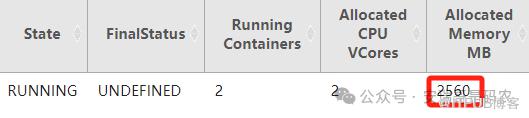
任务总耗时:约1分钟。

任务开始时间
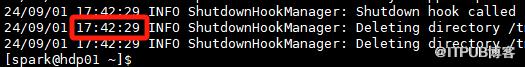
任务结束时间
1.2 HDFS 作为数据源时
同样的,取 HDFS 上 1G 的文件作为数据源:

通过对内存的调整,任务成功跑完,目前只需对 executor 设置如下大小的内存:
--executor-memory 512m
而 yarn 的总内存消耗为:2G
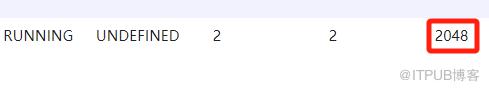
任务总耗时:1分40秒

任务开始时间
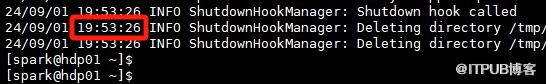
任务结束时间
小结:通过对 1G 数据量的测试对比,用简单计算逻辑时,Spark 读取 MySQL 需要的内存量要大于 Spark 读取 HDFS 的,而数据处理效率,则 MySQL 的要高于 HDFS。
2. 1G数据量,采用「复杂」计算时
2.1 MySQL 作为数据源时
经过一番折腾调试之后,能跑成功需要的executor最小内存为:
--executor-memory 4g
而需要 yarn 的总内存为:约5.5G
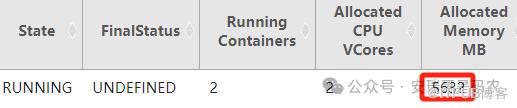
总耗时约:4分40秒。
2.2 HDFS 作为数据源时
通过调整 executor 最小内存大小为:
--executor-memory 512m
需要的 yarn 总内存为:2G
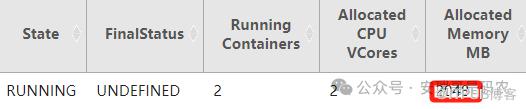
总耗时约:4分30秒。
小结:在数据源总量不变的情况下,随着对数据计算复杂度的增加,MySQL 数据源需要的 executor 内存量翻了4倍,而 HDFS 数据源需要的 executor 内存量,没有变化。
(PS:有想过为什么吗?)
3. 2G数据量,采用「简单」计算时
3.1 MySQL 作为数据源时
相比上次 1G 数据量时耗费的内存总量,这次数据量翻倍之后,需要的内存总量也随之翻倍。
需要的 executor 内存为:2G
--executor-memory 2g
需要的 yarn 总内存为:约3.5G

3.2 HDFS 作为数据源时
此时,Spark 需要的内存依然保证不变。
小结:数据量翻倍之后,Spark 读取 MySQL 需要的内存,相比翻倍前同样面对「简单」计算时,也是翻倍的。而Spark 读取 HDFS 需要的内存,依然不变。
4. 2G数据量,采用「复杂」计算时
4.1 MySQL 作为数据源时
当前需要的最小 executor 内存为:8G
--executor-memory 8g
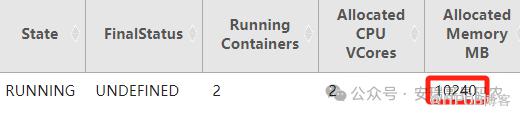
当前 yarn 占用的总内存为:10G
4.2 HDFS 作为数据源时
如果我告诉你,这个时候,Spark 需要的内存依然保证不变,你信吗?
对,人家就是保证不变。
......(省略多个中间过程)
后续随着数据量的持续增加(一直加到11G),以及同时采用「简单」跟「复杂」不同的计算逻辑时发现。
当 Mysql 作为数据源时,它的每一次数据量增长以及每一次,从「简单」计算逻辑,切换到「复杂」计算逻辑时,需要的内存,都会呈现同比例增加趋势。
而当 HDFS 作为数据源时,无论数据量一直增长,还是计算逻辑从「简单」切换到「复杂」,除了计算效率一直下降外,executor 需要的内存量一直都没有变化。
5. 为啥
有同学可能对这个测试结论很好奇,为毛会这样?这不科学啊!
原因其实很简单。
先解释 Spark 读取 HDFS 作为数据源时,为什么它的内存需求一直可以不变。
原因在于:
Spark 读 HDFS时,会默认以 128M 为一个数据块(跟总数据量无关),而一个数据块,对应一个任务的 partition,而这个 partition ,在这个任务里,对应的是一个 executor,而这个executor,当前分配的是 512M 内存,从这一点上来看,它的内存是够够的;
2. 至于计算逻辑从「简单」切换到「复杂」,为毛需要的内存还是不变?原因在于,这个计算的复杂度还不够高,导致当前给的 512M 内存足够你在里面折腾了,况且,人家还可以把部分中间数据 spill 到磁盘。
(PS:至于为什么是 512m 内存,由于我当前集群 yarn 配置的原因,executor 能设置的最小内存大小就是 512m)
再来解释 Spark 读取 Mysql 作为数据源时,为毛需要的内存要一直增加?
跟 HDFS 不一样,MySQL 全表的数据读到 Spark 后,默认就只会到一个分区里面去,它不能跟 HDFS 一样,把它切成多份,这就导致此时的 Spark,单分区的内存要容纳全表数据,也就是当前1个 executor 需要搞定所有数据;
2. 因为单个分区要装所有数据,如果这个分区给分配的内存比较紧凑的话,就会让它对计算逻辑的复杂度非常敏感,所以你就能看到,当计算逻辑从「简单」切换到「复杂」之后,它明显的内存变化。
最后
虽然这次测试的案例相对比较简单,但通过这样的对比,其实就想告诉你,Spark 在处理数据时,它需要的内存大小,跟 2个因素强相关:
1. 单个分区读取的数据量:而不是数据源的总量,单个分区的数据量,往往由数据源决定;
2. 计算逻辑复杂度的高低:计算复杂度越高,需要的内存就越高,反之越低。
希望通过这次实测结论,能够让你对 Spark 在处理数据时,在设置内存的时候,有一个比较清晰的认知,知道在哪些因素下需要大内存,而哪些情况下,可以不用那么浪费。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

