前面几篇文章就 Spark 读数据的问题展开了一系列的测试验证,这次我们换换口味,来体验一款新的数据同步集成工具——Seatunnel。
之所以想到来测试它,原因在于最近看到了很多同学的简历上都提到了这个玩意,讨论群里,它被提及的频率也挺高的。
于是想着,既然这么受欢迎,那我高低得测它一测,看它到底有没有大家夸的辣么腻害,正好也跟之前测试过的 flick-cdc、dataX 这些数据同步工具比试比试。
0. 官网体验
看了一圈,相比之前测试的一些组件来说,个人认为有下面几个优点:
1,文档结构设置比较合理,左边有根据功能列出来的导航目录,能比较清楚地找到想看的内容,而且可以不用梯子;
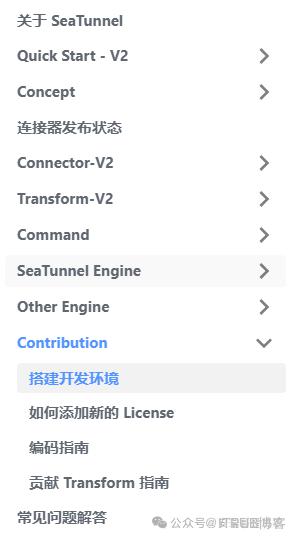
2,关键内容能比较好的支持中文(选择中文页面后),虽然说有些地方还是大面积的英文,但好在,我关心的几乎所有内容,已经都汉化了;
3,文档内容的描述还算详尽,除了个别地方,比如 Seatunnel 利用 Spark 跟 Flink 引擎怎么跑在 yarn 集群上的描述是缺失的,其他地方都还好,至少,我能比较顺利的把环境搭起来、 demo 给跑起来。
1. 基础部署
官网提供的 SeaTunnel 部署方式有 3 种:1,普通部署(官网叫locally);2,docker 部署;3,k8s 部署。
但根据我的个人习惯,这里用的普通部署方式。
1.1 下载安装包
部署 SeaTunnel 的第1步,跟之前用过的 DataX、Flink CDC 玩法一样,先下载对应的安装包,可以看到这个软件从 2022 年 12 月 release 的第一版(v2.3.0),到 2024 年 8 月最新的 v2.3.7,一共经历了 8 个版本的迭代。
具体下载地址:https://seatunnel.apache.org/download/。
这里选择最新的 v2.3.7 版本,具体下载过程略...
1.2 部署插件
还是跟之前的 DataX、Flink CDC 类似,为了能满足对多个外部数据源(Source),跟不同数据目的地(Sink)之间的数据传输,这里需要下载对应的 connector,也就是插件。
跟 DataX 不同的是,这里的 connector,不用区分是 Source 还是 Sink,而且最关键的是,它下载方式非常的智能。
默认情况下(啥都不用干,确保服务器能联网就行),你只需要运行这个安装插件的脚本(bin/install-plugin.sh),就可能把当前版本的 SeaTunnel 支持的所有插件给「一网打尽」。
试了一下,整个脚本运行完成,需要大概近 1 个小时。
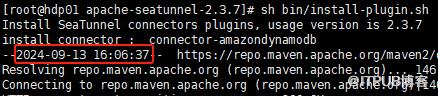
脚本开始时间
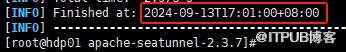
脚本结束时间
默认一共会下载 68 个 connector。
2. 基础配置
对于 SeaTunnel 来说,想要实现对数据的「读取」、「处理」、「写入」,目前它支持 3 种不同的引擎。
1,默认引擎 Zeta;
2,Flink 引擎,目前最新版本只支持 1.12.x — 1.16.x;
3,Spark 引擎,目前最新版本只支持 Spark2.x 跟 Spark 3.x。
根据我的习惯,因为目前集群已经有了 Flink 跟 Spark 环境,所以,我肯定会让它满足对 Flink 以及 Spark 的支持。
怎么支持?很简单,下面两种做法任选其一:
第一:修改配置文件「seatunnel-env.sh」,把下面关于 Flink 跟 Spark 的家目录,改为当前环境已经有的。
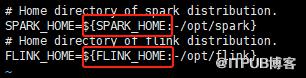
第二:修改当前服务器的概要文件,比如:
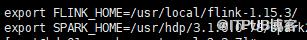
我这里选的第二种。
从这个配置你应该能看出来,当前部署的 SeaTunnel 节点,同时必须得是 Flink 跟 Spark 的客户端节点。
自此,一个可以用 Flink 跟 Spark 作为执行引擎的 SeaTunnel 环境就配置好了。
3. 集群部署
从官网的描述来看,接下来需要决定 SeaTunnel 以什么样的方式来运行,而什么样的运行方式,决定了你选择什么样的部署方式,目前给出的部署方式有下面 3 种:

而且,官网还特别强调,如果是生产环境,建议采用「分离集群模式部署」。
但是,经过我的测试,不想接受它的建议。
原因很简单,我都依赖 Spark 跟 Flink 作为引擎了,那就证明,我后续所有的 SeaTunnel 任务,本质上它就是 Spark 或者 Flink 任务,而这个 Spark 跟 Flink,本来就可以运行在集群上的。
所以我干嘛还要费那个劲,再部署一套 SeaTunnel 集群呢,闲的吗?
后面经过我的实试,确实不用。
所以,这里我就选择最简单的「local 模式部署」(也就是什么都不用做),但注意,这个说法是官网给的,我可不同意,准确的说,此时的 SeaTunnel ,应该充当的是一个「客户端」角色才对。
4. 跑起来
4.1 Spark 引擎怎么跑
官网在介绍的时候,给的是一个 Spark local 的案例,很显然这个不能满足我的胃口,我想让它 Spark on yarn。
咋整?(官网好像没有给出案例,我反正没找到)
这样:
bin/start-seatunnel-spark-3-connector-v2.sh
--master yarn
--deploy-mode cluster/client
--config ./config/v2.streaming.conf.template
其中这个「--deploy-mode」既可以是 cluster,也可以是 client,就跟你提交普通的 Spark on yarn 任务一样。
提交之后,根据任务配置文件中,配置的并行数量 2,会跑在 2个 executor 上。
(为了简单起见,这里就选一个最简单的模板任务作为说明)
经过我这轮简单的实测,SeaTunnel 利用 spark 跑在 yarn 集群上,目前来看是可行的。
4.2 Flink 引擎怎么跑
官网给的案例,用的是 Flink 的 standalone 环境,看过我之前相关实测文章的同学应该知道,我的集群压根就没有这个玩意。
那我想把它跑在 yarn 上面 ,咋个弄呢(官网依然没有找到对应案例)?
从 Flink 这个命令提示来看:

基于 yarn 环境的玩法有 3 种。
第1个:yarn-per-job,行不通,具体表现是,命令可以提交到 yarn 集群,但是,任务失败。
提交命令:
bin/start-seatunnel-flink-15-connector-v2.sh
--master yarn-per-job
--config ./config/v2.streaming.conf.template
失败截图:
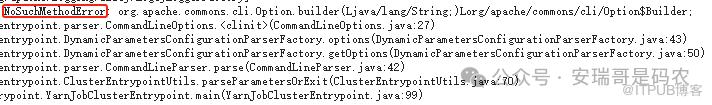
jar 包冲突?缺包?不知道。
第2个:yarn-application,也行不通,具体表现跟上面一样,可以提交到集群,但任务运行报错。
提交命令:
bin/start-seatunnel-flink-15-connector-v2.sh
--master yarn-application
--deploy-mode run-application
--config ./config/v2.streaming.conf.template
失败截图:
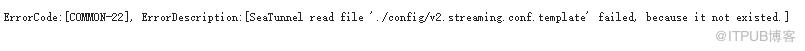
居然说找不到这个任务的配置文件,这不邪了门吗。
第3个:yarn-session,可行,任务能提交成功,且任务运行正常。
提交命令:
bin/start-seatunnel-flink-15-connector-v2.sh
--master yarn-session
-d -Dyarn.application.id=application_1726655793290_0111
--config ./config/v2.streaming.conf.template
正常运行截图:
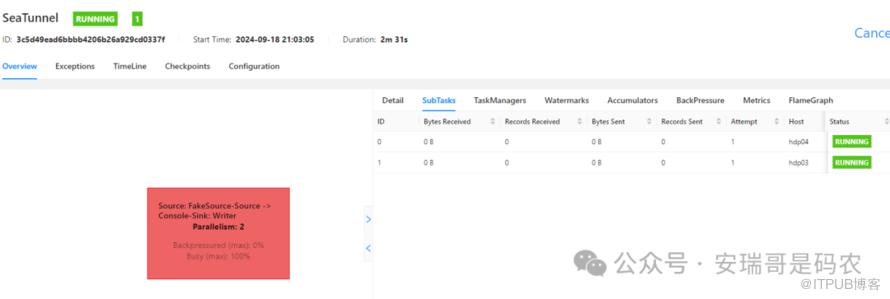
从运行日志来看,一切正常。
最后
这次对 SeaTunnel 的测试,只能算是匆匆一瞥,完全是根据个人喜好,对我最关心的内容做了一个基础性验证。
从验证的结果来看,还算可以(比之前 DataX 以及 Flink CDC 给我的第一印象要好)。至少,它能利用 Spark 和 Flink 作为计算引擎,在运行环境上(on yarn)是可行的。
那至于它后续更高阶、面对更复杂的数据处理场景表现怎么样?咱下一次,接着盘。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

