上篇文章关于用 Spark 的 repartition 和 coalesce 算子来扩展 MySQL 的分区文章发出去之后,就看到有同学留言对这个做法产生了争议。
说,明明用 Spark 读 MySQL 时,是可以通过 jdbc 来设置分区字段,达到分布式的读取目的,为毛还非得用 repartition 来扩展分区,费这劲有啥意义。
其实我的核心目的,是为了想说明,在实际开发过程中,「repartition」跟「coalesce 」这两个算子,尤其是「repartition」这货,并不一定能达到你的优化期望,希望你在用它们前三思,因为现实中,很多同学都喜欢这么干。
那至于 Spark 可以通过 jdbc 配置 MySQL,以多分区的方式读取数据这个解决方案,我又岂能不知道。
这篇文章,咱就来展开聊一聊,针对我的这个案例,如何优雅的实现分布式读取 MySQL 数据源?
0. jdbc 配置
不像其他天然的分布式数据源,我这里的 MySQL,是一个单实例、单表的形式,连存储的数据文件都是单个的,所以如果你用 jdbc 去读这个 MySQL 表,默认只有一个分区,也就好理解了。
既然想分布式读,那就得在读数据的时候,把数据进行人为的「打撒」,让 Spark 知道,哪一坨数据,对应哪一个分区。
Spark 官网对这个打撒的配置,有还算比较详细的说明:
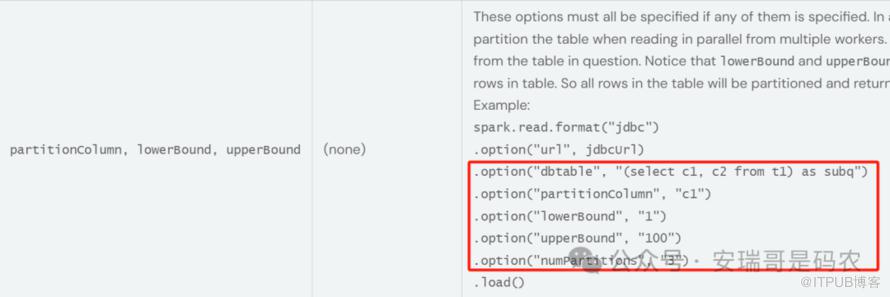
但是,看着好像挺简单的,但在实现的时候,还是有些需要你注意的地方。
1. 注意事项
1.1 配置方式
正如文档描述的那样,它这个分区配置有个特点,「要么就几个一起配,要么就干脆一个也别配」。
这些必须捆绑在一起团伙作案的配置,就是下面这 4 个。
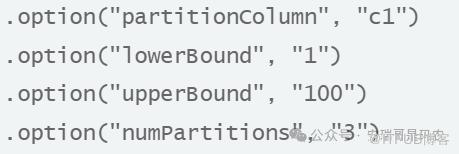
我单独试了,确实没有骗我,假如我只配置「numPartitions」这么一个我认为最关键的设置,Spark 是不会买账的,一点卵用都没得。
1.2 分区字段要求
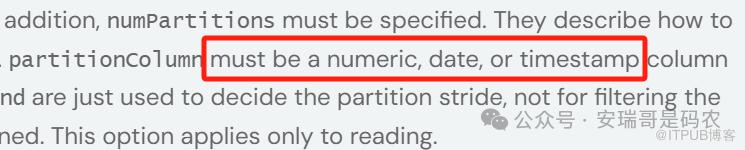
这里有个比较难受的地方在于,对于分区字段的类型,人家是有要求的:必须得是「数值类型」、或者「日期类型」、或者「时间戳类型」。
尴尬的是,我现在测试的这张表,全都是字符串类型,比如我随便挑一个字段作为分区,果然就报错了。
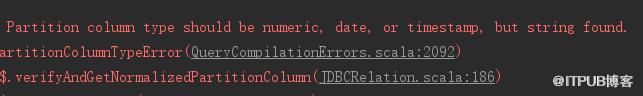
那咋整呢?骚操作在后面。
2. 字符串字段如何分区
对于我当前的这张表来说,可以拿来作为分区的字段,全都是字符串类型。

但是,我这里给想了个办法。
比如,我想给这个 MySQL 表数据分 10 个分区,而目前我认为比较好的分区字段为 time ,因为它可以根据某个规则,把数据比较平均地分成 10 份。
具体怎么分,看这里:
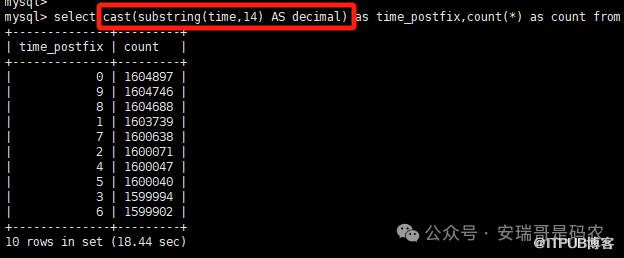
取这个时间字段值的「最后一个数字」,作为分区规则,就能以非常平均的方式,把这张表的数据给切成 10 份,这个骚操作是不是很聪明?
于是,对于当前这个情况,用 Spark 以分区的方式读取 MySQL 的代码,就得这么来写:
/**以分区方式读取MySQL数据*/
        val rawDF = spark.read
            .format("jdbc")
            .option("url", "jdbc:mysql://192.168.221.132:3306/test")
            .option("driver", "com.mysql.cj.jdbc.Driver")
            .option("user", "***")
            .option("password", "****")
            .option("dbtable", "(select cast(substring(time,14) AS decimal) as time_postfix,client_ip,time,target_ip,rcode,query_type,authority_record,add_msg,dns_ip from test03) as target_table")
            .option("partitionColumn", "time_postfix")
            .option("lowerBound", "0")
            .option("upperBound", "10")
            .option("numPartitions", 10)
            .load()
就在原表基础上,自己定义了一个符合类型要求的分区字段呗,这个额外字段就叫「time_postfix」。
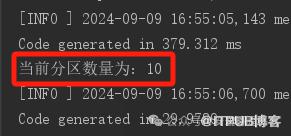
跑起来后,分区数量果然就变成了预期的 10 个:
至此,你可能会好奇,为毛代码设置的上界(upperBound)为 10 ,而不是 9 ,明明「time_postfix」的最大值就是 9 啊?
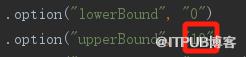
原因在于,它取的是「下闭上开」的区间,也就是:[0,10) 这种方式。
从程序运行的日志可以清楚地看到它的分区规则:
Number of partitions: 10, WHERE clauses of these partitions: `time_postfix` < 1 or `time_postfix` is null, `time_postfix` >= 1 AND `time_postfix` < 2, `time_postfix` >= 2 AND `time_postfix` < 3, `time_postfix` >= 3 AND `time_postfix` < 4, `time_postfix` >= 4 AND `time_postfix` < 5, `time_postfix` >= 5 AND `time_postfix` < 6, `time_postfix` >= 6 AND `time_postfix` < 7, `time_postfix` >= 7 AND `time_postfix` < 8, `time_postfix` >= 8 AND `time_postfix` < 9, `time_postfix` >= 9
最后
想要 Spark 以分布式方式读取 MySQL 的数据,虽然没什么大的技术难度,但想实现好,也没有想象的那么简单,需要你注意下面 3 点:
1,4个必要的配置,必须同时出现,且对分区字段的类型有硬性要求;
2,如果分区字段不符合类型要求,需要你用其他手段对它进行转换;
3,对于选定的分区字段,要提前判断它的数据切分效果,否则容易造成读取时的数据倾斜,给后续数据处理带来麻烦。
以上。

原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

