有这样一个需求,要把一个「大文件」数据经过一些聚合处理后,把聚合结果写入到 clickhouse(下称CK) 数据库。
因为是「一次性」写入需求,所以我决定用 Spark 来搞定这件事情。
0. 需求
这个大文件有多大呢,23G,4亿+ 条数据记录。
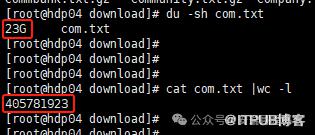
数据内容很简单,只有 2 列,一列为 key,另一列为 value。
而要求的计算逻辑也很简单,把 key 相同的 value 给合并到一起,本质上就是一个类似 world count 的统计,统计后的结果数据条数大概为 1.5亿+,最后把这个结果给写入到 CK 数据库。
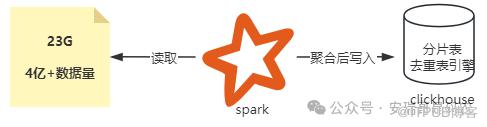
(代码不是这次文章的重点,略...)
因为考虑到数据量比较大,且为了防止写入过程中,程序失败后再次启动而导致的数据写入重复,所以这里设计的 CK 表,为「去重引擎表(ReplacingMergeTree)」+ 「分片表(Distributed)」的组合形式。
1. 问题表现
从实测表现来看,如果数据文件的数据量比较小(比如几G以内),那么把这个数据的 world count 聚合结果写入到 CK, 简直就是小菜一碟。
然鹅,就是这么一个非常简单的需求,当数据增加到一个比较大的量后,莫名奇妙的问题就冒出来了:
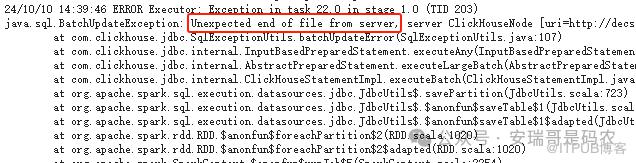
就这么个报错,不知道你们能不能看懂,反正我是看不懂。
具体表现就是:在数据聚合完毕之后的第 2 个 stage,也就是把聚合结果写入到 CK 的过程中,挂掉的。
一开始以为是 CK 服务端不稳定导致的,重试了好几把,都一个鸟样,聚合结果都能部分写进去,但每一次都会在中间的某个时刻嗝屁掉。
遇事不决问 Google,一顿操作之下,在 GitHub 上找到了一个跟我有相同遭遇的帖子。

里面的每一个回答我都看了,但没有一个是可以解决这个问题的。
2. 尝试的解决方法
2.1 增加内存
这个估计是很多同学最容易想到的,虽然实际开发过程中,很多 Spark 任务确实是因为内存不足而挂掉,而抛出来的异常信息,很多也确实找不到跟 OOM 有关的影子。
但是,这一次,它还真不是,别问我怎么知道的,我就是知道。
2.2 升级 jdbc 驱动包
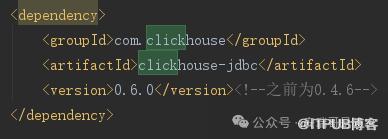
在上面那个 GitHub 帖子里,有一条解决建议就是让你升级当前程序依赖的 jdbc 驱动包的。
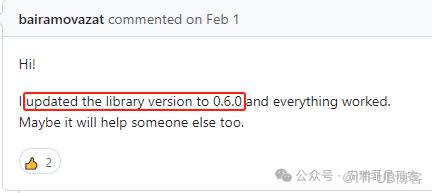
我照做了,把当前的 0.4.6 给升级成 0.6.0,但然并卵,没用,还是一样的错误。
2.3 修改数据写 CK 的批次参数
因为数据是在聚合完成之后,写 CK 时抛的异常,所以怀疑有没有可能是因为每个批次写入数据的大小设置不合理导致的。
于是,我把批次分别改为:1k、2k、5k、8k、1w...
然鹅,还是不行。
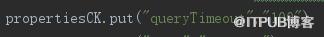
2.4 设置超时参数
在 jdbc 设置里,加上了读/写都适用的超时参数,也没用。
3. 得用这一招
一番折腾之后,问题最终解决了,但是,并没有采用网络上提到的任何一种方案。
怎么搞定的呢?
把之前的「ReplacingMergeTree」引擎,给换成普通的「MergeTree」引擎,就好了(分片表或者本地表都可以)。
数据能一次性全部写到 CK 表里。
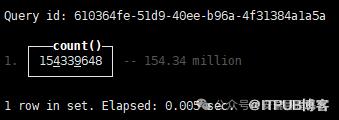
至于为什么?暂时并不十分清楚,猜测可能是「ReplacingMergeTree」引擎在数据写入过程中,后台存在大量的数据合并操作,从而影响数据的写入导致的。
但根据我以往的经验,按理说这种情况,应该可以通过设置特定的参数来解决,但,我暂时没能找到这个有效的参数。
最后
算是在用 Spark 写 CK 时,遇到的一次不大不小的坑,而这种坑呢,一般情况下也比较难遇到。
因为大部分情况下,我们一般很少有机会一次性处理这么大的数据文件。
希望这次的趟坑经验,能帮到也遇到了,或即将遇到类似问题的你。

原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

