既然前几期内容测试了 Flink 关于内存跟(MySQL)数据量之间的关系,那么这一次,在同等条件下,我们也来看看如果使用 Spark,那么它需要的内存,跟导出(MySQL)数据量之间,又一种什么样的关系呢?
之前的内容就说过,对于数据导入/导出这种事情,我一向秉承的原则就是,「能用 Flink 或者 Spark 来搞定的,就绝不用其他工具」。
原因很简单,这两者是组成大数据技术的最核心要素(至少我是这么认为的),相对其他组件,是社区支持力度最大,迭代升级最频繁,生态最广、也是成熟度最高的,几乎没有之一。
这次测试的目的,在于生产上,如果面临类似的数据导入场景,可以给你提供一个选择的依据。
0. 准备
Spark 读取 MySQL,目前官方推荐的主流方法,有仅只有一个,那就是通过 jdbc 的方式 ,而相比于 Flink,它只能是「批处理」。
可能你会问:咦?Flink 读 MySQL 是流的方式(需要binlog支持),而 Spark 读 MySQL ,就只能是离线方式,有什么可比性呢?
乍一看好像是,但你别忘了,在生产上,我们选择一个解决方案的关键,并不只是以「理论为驱动」,而更多会考虑解决方案的方便、高效、节省资源与否。
因为咱们这次的目的,是导出 MySQL 的「存量数据」,所以这里考虑用 Spark 以离线方式导出,也就有了合理性。
引入必要依赖
Spark 的 jdbc 方案,一般情况下,需要的依赖,相比 Flink 要更简单一点,这里要读 MySQL,就只需要引入 MySQL 自己的 jdbc 包就足够。
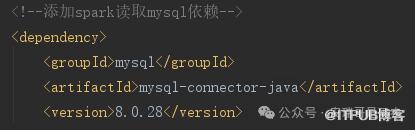
不存在跟 Flink 一样,还需要引入 Spark jdbc 的包一说。
然后,就可以编码了,简单的数据处理流程如下:

1. 编码
相比之前测试的 Flink CDC 3.x 全程只需要通过配置文件,就能实现对 MySQL 数据导入到 Kafka 来说,当前 Spark 需要编码的这种方式,确实要更麻烦一点。
但当你写完后会发现,其实还好,因为代码都很简单。
package com.anryg.bigdata.streaming.mysql

import com.alibaba.fastjson.JSONObject
import org.apache.spark.SparkConf
import org.apache.spark.sql.SparkSession

/**
  * @DESC: Spark 读取MySQL写Kafka,对比跟Flink消耗的内存情况
  * @Auther: Anryg
  * @Date: 2024/8/27 15:09
  */
object SparkReadMysql2Kafka {

    def main(args: Array[String]): Unit = {
        val conf = new SparkConf().setAppName("SparkReadMysql2Kafka").setMaster("local[*]")
        val spark = SparkSession.builder().config(conf).getOrCreate()

        /**读取MySQL数据*/
        val rawDF = spark.read
            .format("jdbc")
            .option("url", "jdbc:mysql://192.168.221.132:3306/test")
            .option("driver", "com.mysql.cj.jdbc.Driver")
            .option("user", "pcl")
            .option("password", "****")
            .option("dbtable", "test01")
            .load()

        import spark.implicits._  /**引入隐式转换对象*/

        /**因为要写Kafka,需要对数据做一点必要的转换*/
        val targetDF = rawDF.map(row => {
                        val jsonObj = new JSONObject(26)
                        val subject_common_name = row.getString(0)
                        jsonObj.put("subject_common_name",subject_common_name)
                        val serial_number = row.getString(1)
                        jsonObj.put("serial_number", serial_number)
                        /**中间字段省略*/
                        val created_at = row.getTimestamp(25)
                        jsonObj.put("created_at",created_at)
                        jsonObj.toJSONString
                    }).toDF("value") /**写到Kafka,key跟value字段,至少需要提供value*/

        /**将转换后,符合Kafka要求的格式数据写进Kafka*/
        targetDF
            .write
            .format("kafka")
            .option("kafka.bootstrap.servers", "192.168.211.107:6667")
            .option("topic", "test")
            .save()
    }
}
代码逻辑是:
1. 先把数据从 MySQL 读取出来;
2. 再根据 Kafka 的数据写入要求,把数据处理成只有「key」和「value」两个字段,或者只有「value」一个字段的 DataFrame。这里为了方便,把 MySQL 表中的 26 个字段,揉成一个 json string 对象,然后塞给 value 字段;
3. 最后,把符合 Kafka 格式要求的数据,写进 Kafka,数据格式跟之前 Flink CDC 写 Kafka 一样。
2. 几个需要注意的地方
但凡编码涉及到数据转换之类的操作,如果你的数据类型复杂一点点,都几乎会碰到一些不大不小的问题。
2.1 注意点01
对「Row」对象获取数据时,需要注意对应的类型,并不是所有的类型,都可以直接转为 String 的。
比如,「Boolean」、「TimeStamp」等类型就不行。
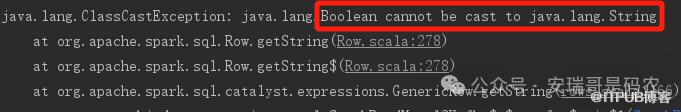
编码的时候需要注意。
2.2 注意点02
当 Spark 用 jdbc 把数据从 MySQL 读出来的时候,对应 DataFrame 的字段个数,是跟原始 MySQL 的字段个数保持一致的(这里是26个)。
但是,你不能直接就把它往 Kafka 里怼,因为格式不符合要求,这里估计有同学会犯这样的错,别问我怎么知道的,因为我开始就这么干过。
把这26个字段的数据,合成为一个 json 对象,再写到 Kafka,是一个比较主流的玩法。
3. 内存对比
在结论揭晓之前,你可以先猜一下,同样的数据量,Spark 跟 Flink 谁消耗的内存更大一些?
3.1 原始数据1倍量时
还记得上次测试用 Flink 导出的 MySQL 表的数据量不。
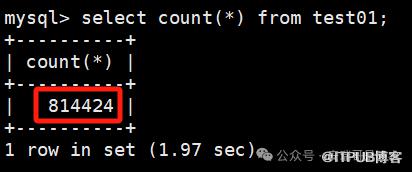
初始表的数据条数
初始表的数据存储大小
当时在我极致压榨 Flink 的内存之后,把这些数据导出成功,依然需要大概 10G 的内存空间。

Flink cdc需要的内存大小
而 Spark 同样被我多次调整内存之后,能成功导出这些数据量需要的内存大小如下:
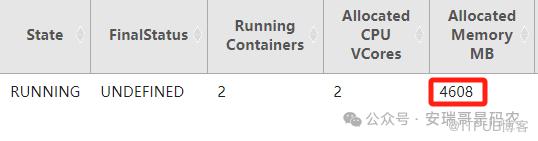
当前 Spark 需要的内存大小
而且当前只用了一个 executor,executor 的内存大小为:
--executor-memory 3g上次用 Flink 需要的时间为:4分30秒。

Flink cdc需要的时间
而这一次用 Spark 的效率要更高一点。
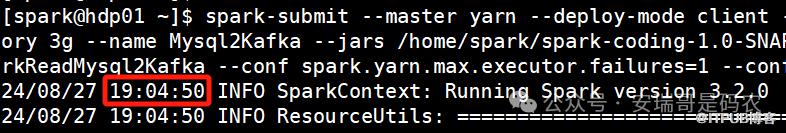
Spark 启动前的时间
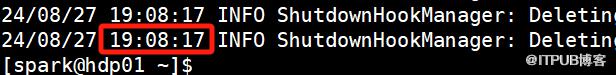
Spark 任务完成时的时间
总耗时:3分27秒,比 Flink 快整整 1分钟。
小结:当 MySQL 表为原始数据量大小时,Spark 消耗的内存只需要 Flink 的一半不到,且效率也要比 Flink 快 1分钟。
3.2 原始数据2倍量时
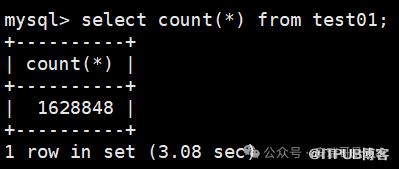
通过调整 Spark 的 executor 内存,最终能跑成功时,executor 的内存设置为:
--executor-memory 5g
消耗的 yarn 总内存为:
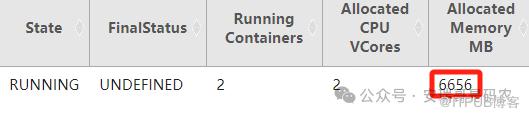
由这一点可以看出来,它跟之前的 Flink CDC 进程不一样(内存需求不变),Spark 进程在数据量翻倍的情况下,导出时需要的内存也随之增加,增加了2G。
此时消耗的时间为:10分钟。(截图就不放了,麻烦)
小结:随着 MySQL 数据量的翻倍,Spark 需要的内存也随之增加了 2G(约一个原始数据文件的大小),导出效率也只有原来的一半不到。
3.3 原始数据3倍量时
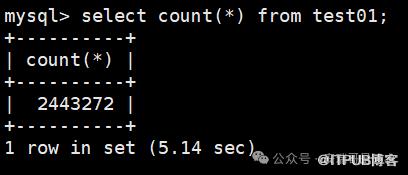
通用调整 executor 的内存大小,还是加了 2G 之后才能跑通的:
--executor-memory 7g
此时,消耗的 yarn 总内存为:

可以看出来,当数据量再次增加1倍时,增加的内存还是 2G。
时间消耗为:16分钟。
小结:随着 MySQL 的数据量再增加一倍,executor 需要的内存再增加 2G,效率也同比例下降。
最后
通过这次用 Spark 导出 MySQL 表数据到 Kafka 的测试可以得出如下结论:
1,同样数据量情况下(当数据量较小时),Spark 需要的内存总量,要明显小于 Flink,而且导出效率还更高;
2,随着数据量的翻倍,Spark 需要的内存总量,会同比例增加(这里是2G,约一个原始数据文件大小),导出的效率同样呈同比例下降趋势;
3,而 Flink CDC 的导出特点是,一开始需要的内存很大,但当达到一定阈值之后,这个内存大小就不变了,跟 Spark 在使用表现上有很大不同;
4,Flink CDC 导出 MySQL 数据读取的是 binlog,而 Spark 则读取的是数据文件本身。
那么对于这种数据库的存量数据导出任务,Flink 跟 Spark,你会选哪个?
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

