之前文章探索过 Flink 读 Clickhouse(下称CK)作为数据源的几种尝试,结果一番折腾下来,发现然并卵,至少目前为止,我还没有找到一个比较好的解决方案。
既然 Flink 读 CK 不行,那咱退而求其次,写 CK 总可以了吧?
你还真别说,这样一来,就容易多了。
从网上能查到的资料来看,Flink 写 CK 的解决方案有很多,大致可以分为两大类:
一类,是借助一些 GitHub 开源的 flink -ck-connector 插件来实现;
另一类,则是利用 Flink 和 CK 自带的 jdbc 方案来实现。
从我的经验来看,一般组件本身自带的 jdbc 方案就足够满足要求了,所以今天这篇内容,咱就一起来看看,Flink 利用自带的 jdbc 入库方式,耍起来到底怎么样?
(PS:本次测试用的 Flink1.15 + CK23.x)
0. 环境准备
既然是利用 jdbc,那么必要的 jdbc 依赖得引入进来,这里的 jdbc 依赖分为两部分。
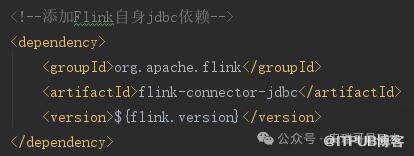
第1部分,引入 Flink 自身的 jdbc 依赖(最后一个方案可以不用):
第2部分,引入 CK 的 jdbc 依赖:

这次测试的目的,就是把在 Kafka 的数据,通过 Flink 给顺利写入到 CK 表里。

根据官方文档的描述,以及过往我对 Flink 的使用经验,这里至少可以有至少3种能尝试的方法。
1. 用 Flink SQL API
一般来说,类似这种计算逻辑比较简单的情况,能用 Flink SQL API 的,就尽量不去麻烦它的 DataStream API,毕竟这种写起来,要轻松高效很多。
然鹅,经过我的实测,不行!

该加的依赖也都加了,代码也是跟官网给的例子类似的写法,反正就是不行,得,你清高。
2. 用 Flink DataStream API(根据官网例子)
既然 SQL API 行不通,咱也不能在一棵树上吊死不是,那就换成 DataStream 这棵歪脖子树试试呢。
还是跟官网给的例子一样,照猫画虎,再结合我的案例,画出来能跑通的代码如下:
package com.anryg.mysql.jdbc

import java.sql.PreparedStatement
import java.time.Duration

import org.apache.flink.api.common.eventtime.WatermarkStrategy
import org.apache.flink.api.common.serialization.SimpleStringSchema
import org.apache.flink.connector.jdbc.{JdbcConnectionOptions, JdbcExecutionOptions, JdbcSink, JdbcStatementBuilder}
import org.apache.flink.connector.kafka.source.KafkaSource
import org.apache.flink.connector.kafka.source.enumerator.initializer.OffsetsInitializer
import org.apache.flink.contrib.streaming.state.EmbeddedRocksDBStateBackend
import org.apache.flink.streaming.api.CheckpointingMode
import org.apache.flink.streaming.api.environment.CheckpointConfig.ExternalizedCheckpointCleanup
import org.apache.flink.streaming.api.scala.StreamExecutionEnvironment

/**
  * @DESC: Flink DS API 读取Kafka数据,利用jdbc写CK
  * @Auther: Anryg
  * @Date: 2024/8/22 15:16
  */
object FlinkDSFromKafka2CK01 {

    def main(args: Array[String]): Unit = {
        val env = StreamExecutionEnvironment.getExecutionEnvironment
        env.enableCheckpointing(10000L)/**设置check时间间隔*/

        env.setStateBackend(new EmbeddedRocksDBStateBackend(true)) //新的设置state backend的方式
        env.getCheckpointConfig.setCheckpointStorage("hdfs://192.168.211.106:8020/tmp/flink_checkpoint/FlinkDSFromKafka2CK")
        env.getCheckpointConfig.setExternalizedCheckpointCleanup(ExternalizedCheckpointCleanup.RETAIN_ON_CANCELLATION) //设置checkpoint记录的保留策略
        env.getCheckpointConfig.setAlignedCheckpointTimeout(Duration.ofMinutes(1L))
        env.getCheckpointConfig.setCheckpointingMode(CheckpointingMode.AT_LEAST_ONCE)

        val kafkaSourceSource = KafkaSource.builder()
            .setBootstrapServers("192.168.211.107:6667")
            .setTopics("test")
            .setGroupId("FlinkDSFromKafka2CK")
            .setStartingOffsets(OffsetsInitializer.earliest()) //确认消费模式为latest
            .setValueOnlyDeserializer(new SimpleStringSchema())
            .build()

        import org.apache.flink.streaming.api.scala._  //引入隐式转换函数

        /**读取数据源生成DataStream对象*/
        val kafkaDS = env.fromSource[String](kafkaSourceSource, WatermarkStrategy.noWatermarks(),"kafka-data")

        kafkaDS.map(line => {
            val lineArray = line.split(",")
            val prefix = lineArray(0)
            val length = lineArray(1)
            val asn = lineArray(2)
            val ta = lineArray(3)

            (prefix, length, asn, ta) /**拿到4个字段的数据组成元组对象*/
        }).addSink(
            JdbcSink.sink("insert into test01 values(?,?,?,?)", /**写CK表的sql语句*/
                new JdbcStatementBuilder[(String,String,String,String)] {
                    override def accept(t: PreparedStatement, u: (String, String, String, String)): Unit = { /**确定字段写入顺序*/
                        t.setString(1, u._1)
                        t.setString(2, u._2)
                        t.setString(3, u._3)
                        t.setString(4, u._4)
                    }
                },
                JdbcExecutionOptions.builder() /**设置写入时的相关参数*/
                    .withBatchSize(10)
                    .withMaxRetries(3)
                    .build(),
                new JdbcConnectionOptions.JdbcConnectionOptionsBuilder()  /**目标CK数据库的相关参数*/
                    .withUrl("jdbc:clickhouse://192.168.211.109:8123/test")
                    .withDriverName("com.clickhouse.jdbc.ClickHouseDriver")
                    .withUsername("default")
                    .withPassword("****")
                    .build())

        )
        env.execute()
    }
}
虽然代码能跑通,但老实说,我不太喜欢这个写法。
因为这里用到了大量的 Flink jdbc 提供的,比如「JdbcSink」、「JdbcStatementBuilder」、「JdbcExecutionOptions」等类。
而根据 Flink 的传统尿性,一旦 Flink 的版本来个升级,以上这些玩意的写法,大概率会被全部推倒重来,代码重构的成本会很高。
那有没有一种不依赖 Flink jdbc,仅仅只用到 CK jdbc 就能成功把数据写到 CK 的办法呢?
有!往下看。
3. 不依赖 Flink jdbc 的玩法(非官网写法)
这个思考其实来源于之前对 Spark 的使用经验,我们都知道,Spark 有两个非常经典的算子,叫「foreach」跟「foreachPartition」。
啥意思呢?
就是如果你想把 Spark 最终处理好的数据,写入到某个 Spark 不能直接支持(没有对应的connector)的存储中,完全可以在这两个算子内部,用这个存储自己支持的写入 API 来实现数据的写入功能。
这里,就用到了类似的实现。
来看我调试成功后的代码:
package com.anryg.mysql.jdbc

import java.sql.Connection
import java.time.Duration
import java.util.Properties

import com.clickhouse.jdbc.ClickHouseDataSource
import org.apache.flink.api.common.eventtime.WatermarkStrategy
import org.apache.flink.api.common.serialization.SimpleStringSchema
import org.apache.flink.configuration.Configuration
import org.apache.flink.connector.kafka.source.KafkaSource
import org.apache.flink.connector.kafka.source.enumerator.initializer.OffsetsInitializer
import org.apache.flink.contrib.streaming.state.EmbeddedRocksDBStateBackend
import org.apache.flink.streaming.api.CheckpointingMode
import org.apache.flink.streaming.api.environment.CheckpointConfig.ExternalizedCheckpointCleanup
import org.apache.flink.streaming.api.functions.sink.{RichSinkFunction, SinkFunction}
import org.apache.flink.streaming.api.scala.StreamExecutionEnvironment

/**
  * @DESC: Flink DS API 读取Kafka数据,利用jdbc写CK
  * @Auther: Anryg
  * @Date: 2024/8/22 17:02
  */
object FlinkDSFromKafka2CK02 {

    def main(args: Array[String]): Unit = {
        val env = StreamExecutionEnvironment.getExecutionEnvironment
        env.enableCheckpointing(10000L)

        env.setStateBackend(new EmbeddedRocksDBStateBackend(true)) //新的设置state backend的方式
        env.getCheckpointConfig.setCheckpointStorage("hdfs://192.168.211.106:8020/tmp/flink_checkpoint/FlinkDSFromKafka2CK02")
        env.getCheckpointConfig.setExternalizedCheckpointCleanup(ExternalizedCheckpointCleanup.RETAIN_ON_CANCELLATION) //设置checkpoint记录的保留策略
        env.getCheckpointConfig.setAlignedCheckpointTimeout(Duration.ofMinutes(1L))
        env.getCheckpointConfig.setCheckpointingMode(CheckpointingMode.AT_LEAST_ONCE)

        val kafkaSourceSource = KafkaSource.builder()
            .setBootstrapServers("192.168.211.107:6667")
            .setTopics("test")
            .setGroupId("FlinkDSFromKafka2CK02")
            .setStartingOffsets(OffsetsInitializer.earliest()) //确认消费模式为latest
            .setValueOnlyDeserializer(new SimpleStringSchema())
            .build()

        import org.apache.flink.streaming.api.scala._  //引入隐式转换函数

        /**读取数据源生成DataStream对象*/
        val kafkaDS = env.fromSource[String](kafkaSourceSource, WatermarkStrategy.noWatermarks(),"kafka-data")

        kafkaDS.map(line => {
            val lineArray = line.split(",")
            val prefix = lineArray(0)
            val length = lineArray(1)
            val asn = lineArray(2)
            val ta = lineArray(3)

            (prefix, length, asn, ta) /**拿到4个字段的数据*/
        }).addSink(new RichSinkFunction[(String, String, String, String)] {
            /**添加CK的基本属性,初始化一次*/
            private val ckTable = "test.test01"
            private val url = "jdbc:clickhouse://192.168.211.109:8123"
            private val properties = new Properties
            private var dataSource: ClickHouseDataSource = null
            private var conn: Connection = null

            /**创建数据库连接,根据线程数量,只执行一次*/
            override def open(parameters: Configuration): Unit = {
                dataSource = new ClickHouseDataSource(url, properties)
                conn = dataSource.getConnection("default", "****")
            }

            /**对每一条业务数据都执行*/
            override def invoke(value: (String, String, String, String), context: SinkFunction.Context): Unit = {
                val prefix = value._1
                val length = value._2
                val asn = value._3
                val ta = value._4

                val ps = conn.prepareStatement("insert into " + ckTable + " values (?,?,?,?)")
                ps.setString(1, prefix)
                ps.setString(2, length)
                ps.setString(3, asn)
                ps.setString(4, ta)

                ps.addBatch()
                ps.executeBatch()
            }

            /**流任务里,不会执行*/
            override def close(): Unit = {
                if (conn != null) conn.close()
            }

        })
        env.execute()
    }
}
怎么样?是不是跟上一个版本不太一样。
这里主要用到了 Flink 独有的「富函数」,它最大的优点,是给使用者提供了一个非常实用且便利的「编码框架规范」,具体内容之前文章有说过,不赘述。
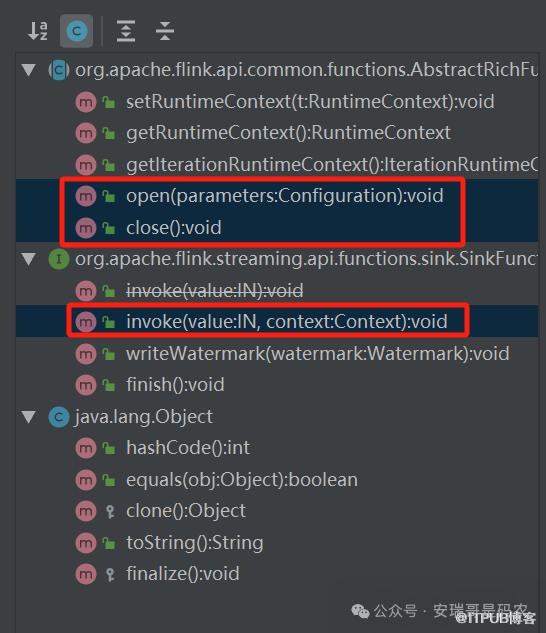
这里值得注意的是,这个「富函数」在实现的时候,对于需要重写哪些函数,你自己得心里有杆秤(因为可以重写的函数实在是太多了)。
比如对于我这个案例来说,得挑下面几个函数来重写(那个close函数其实可以不用):
最重要的是,当前这个写法,它是不需要依赖 Flink 自身 jdbc 的,你看,我都把它给注释掉了。

照样跑的嗷嗷的。
至于最后写到 CK 后的数据内容,不是本文重点,略...(肯定不会蒙你)
最后
这次利用 Flink 的 jdbc 方案,分别测试了它的 SQL API 以及 DataStream API 读 Kafka 写 CK 的3种不同实现方法。
其中 SQL API 上来就拉了,怎么着都行不通(代码我都没好意思贴出来)。
对于 Flink DataStream 的两种写法,其中第一个是 Flink 官网推荐的,既用到了 Flink jdbc,同时还需要搭配 CK jdbc 双管齐下才能达到目的。
至于 DataStream API 的第二种写法,利用了 Flink「sink富函数」提供的便利,可以免去第一个写法中对 Flink jdbc 的依赖,只需要引入 CK jdbc 就能搞定,更加灵活方便。
那么对于这两种 Flink 写 CK 的方案,你更喜欢哪个呢?
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

