上篇文章测试了 Flink CDC 任务通过极致内存压榨后,内存消耗跟最初没有优化前比,节省了近一半,但即便是这样,在我看来,跟导出的数量相比,这个内存消耗还是有些偏高。
但我们另外需要知道的一点是,作为分布式计算引擎,因为框架本身的缘故,咱不能把它的内存消耗,跟需要处理的数据总量直接划等号(需要耗费一定的内存来维持进程本身的运行)。
那这期内容,我们继续来验证下一个疑点——对于同样字段结构的一张表,随着数据量的增加(翻倍),Flink CDC 需要耗费的内存,是不是也同比例增长?
0. 测试准备
还是用上次测试过的那张表,还记得当时的数据量,和对应的文件大小吗?
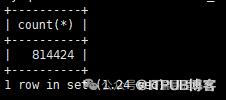
测试表数据原始条数
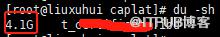
测试表数据原始大小
另外要知道,这张表还额外创建了多个索引:
在验证表数据量增长,跟 Flink CDC 进程需要的内存关系之前前,我们先来验证一下,表的索引,对 Flink CDC 进程需要的内存有没有直接关系?
之后,再测试数据量翻若干倍后,Flink CDC 任务需要的内存变化情况。
1. 去除索引后内存需求变化
先来看一眼,在去除了上面之前添加的那些索引之后,剩下的「纯」数据量为多大。

去除索引后,表数据的条数
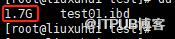
去除索引后,表数据的大小
数据条数不变的情况下,存储大小来只有原来(去掉索引前)的一半不到。
既然存储大小只有不到之前的一半,那我们用 Flink CDC 把它导出时,实时对应需要的内存是不是也可以减少呢(基于上一次成功导出用到的最小内存)?
出师不利
还没来得及验证索引去掉后的效果呢,任务刚启动就出事了。
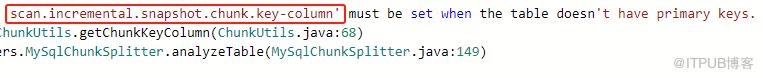
原来是因为去除这个表的索引时,把「primary key」也一同干掉了,导致 CDC 程序找不到一个取数据的「基准列」,才导致这样的报错。
找到官网说明,说只要在配置文件中添加这个配置,指定一个非空的列就好了。

然鹅,似乎没有什么卵用。
从目前为止,我对这个 Flink CDC 运行流程和原理来看(非编码方式),只有两个地方可以添加这个配置。
一个是配置 CDC 任务的主配置文件:不生效!
另一个是 Flink 的主配置文件:也不行!
算了,这种愚蠢的设计已经见怪不了,暂时没招,只能把这个「primary key」给加上,要不然今天就玩不下去了。
把这个「primary key」加上之后,再瞅一眼数据大小。

咦?发现跟刚才没有添加「primary key」时存储占用是一样大的。
原因很简单,因为「primary key」采用的是「聚簇」索引,索引本身跟数据是在一起存储的,唯一的区别在于,现在的数据经过了排序。
TM堆内存减少一半试试(1200MB)
很遗憾,堆内存减半后,行不通,还是跟之前一样,数据导到近一半的时候就嗝屁了。
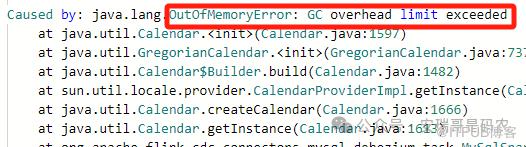
经过多次对 taskmanager 堆内存的调整发现,即便是删除了额外索引,减少了数据文件的存储大小,但 Flink CDC 对它的(堆)内存需要(还是上次需要的2400MB)没有变化。
原因在于,Flink CDC 即便读取的是历史数据,也是通过 binlog,而不是表的数据文件。
所以得出的结论是:MySQL 表的索引多少,并不影响 Flink CDC 对其导出时,需要的内存大小。
2. 数据量增加到原来的2倍
这一次,咱们把之前的 80w+ 数据量加倍,看 Flink CDC 进程需要的内存变化如何。
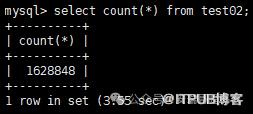
翻倍后的表数据条数
TM堆内存继续用 2400MB 试试
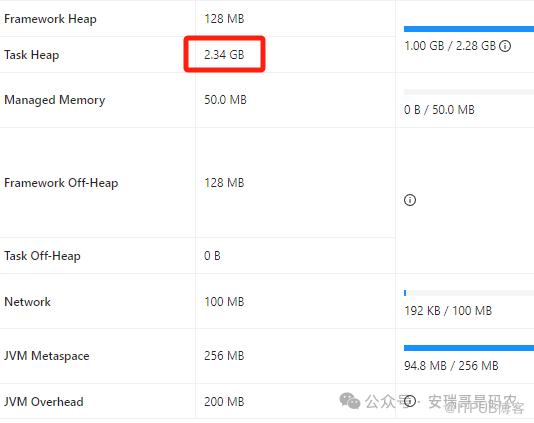
居然跑完了:
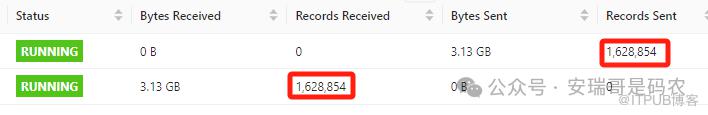
也就是说,数据量虽然翻倍了,但是当前的内存参数,依然可以在不增加的情况下,把数据量给导出成功。
3. 数据量增加到原来的3倍
瞅一眼当前表的数据量:
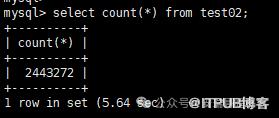
CDC 任务内存参数不变的情况下,也成功了。
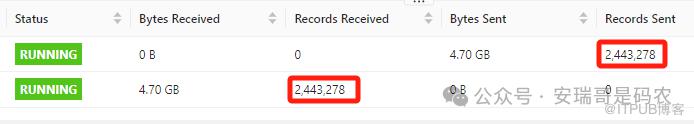
4. 数据量增加到原来的4倍

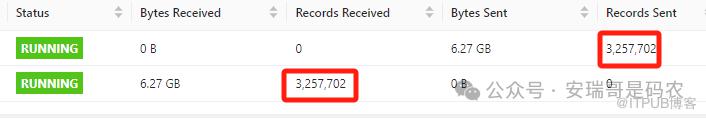
内存参数不变的情况下,依然可以跑成功:
5. (此处省略好多个字...)
6. 数据量增加到原来的8倍
当前数据量为:
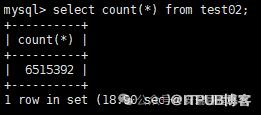
结果你猜怎么着,人家一样不怵,还是能导出成功。

只不过,导出时间变长了点。
7. 不测了
最后
从这次实测的表现来看,可以得出下面结论:
MySQL 表是否创建额外的索引,跟 Flink CDC 任务导出时,需要的内存大小之间,没有一毛钱关系(人家只读 binlog);
2. MySQL 表的数据量,跟 Flink CDC 导出任务需要的内存之间,并不是线性关系,它们之间存在一个「阈值」,当内存设置达到这个阈值后(当前测试任务为2400MB),随着数据量的增大,CDC 任务的内存需求是不变的,或者说至少在很大一个区间范围内不变。
至于数据量增加到多少,才需要再次调大 CDC 任务的内存,有兴趣的同学可以去验证一下。
那么对于这次的测试结论,有没有符合你的预期呢?
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

