当初决定把 Seatunnel 用起来,很重要的一个原因在于它支持 Flink 跟 Spark 引擎,因为对于我当前的大数据平台来说,Flink 跟 Spark 环境是现成的,这样一来,引入一个新组件的成本很低,且也不会导致系统过于臃肿。
上期内容测试了在面对 MySQL CDC 数据源时,Seatunnel 利用 Flink 引擎(不支持Spark 引擎)的糟糕表现。
那么这一次,咱接着测试在面对其他数据源时,看 Seatunnel 在使用 Flink 引擎,以及使用 Spark 引擎时,这两者有什么区别?
0. 测试设计
这里准备设计下面 3 种不同数据导出场景。
0.1 读 clickhouse 写 Kafka
看过我历史文章的同学应该还记得,之前专门分别测试过用 Flink API 跟 Spark API 去读 CK,结果只有 Spark 能很顺利的读取,而 Flink 当前怎么折腾都不行。
那么这一次,看 Flink 跟 Spark 被套上 Seatunnel 这个外壳之后,情况会不会发生变化。
0.2 读 Doris 写 clickhouse
之前也测试过,无论是 Flink 还是 Spark,都能很顺利的读到 Doris 数据,希望这一次,不要出幺蛾子(但还是出了)。
0.3 读 Kafka 写 Doris
同样,之前用 Flink 跟 Spark 测试没有问题,看这一次 Seatunnel 利用这两个引擎的表现怎么样。
1. 读 clickhouse 写 Kafka
瞅一眼任务配置(clickhouse_to_kafka.conf):
env {
  parallelism = 3
  job.mode = "BATCH"
}

# Create a source to connect to Clickhouse
source {
  Clickhouse {
    host = "192.168.211.109:8123"
    database = "test"
    sql = "select * from test01"
    username = "default"
    password = "****"
    server_time_zone = "CST"
    clickhouse.config = {
      "socket_timeout": "300000"
    }
  }
}

# Sink to kafka
sink {
  kafka {
      topic = "test"
      bootstrap.servers = "192.168.211.107:6667"
      format = json
      kafka.request.timeout.ms = 60000
      semantics = EXACTLY_ONCE
      kafka.config = {
        acks = "all"
        request.timeout.ms = 60000
        buffer.memory = 33554432
      }
  }
}
1.1 Seatunnel 利用 Spark 引擎
任务流程如图:
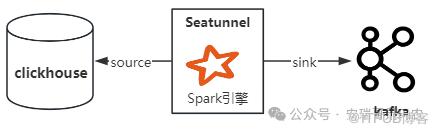
先说结论:执行失败!
任务提交命令:
bin/start-seatunnel-spark-3-connector-v2.sh
--master yarn
--deploy-mode client
--config jobs/clickhouse_to_kafka.conf
能提交到 yarn 集群,但是很快就报错了:

而这个错呢,跟上次测试读 MySQL CDC 写 Kafka 是一毛一样的。
你要说是 Kafka 版本的问题吧(我当前Kafka 版本为2.0),官方文档说的可是任意版本都支持的。
反正,就是不知道问题出在哪。
1.2 Seatunnel 利用 Flink 引擎
任务流程如图:
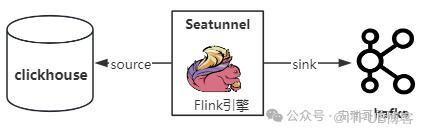
先说结论:任务卡住半死不活,数据写不进去!
任务提交命令:
bin/start-seatunnel-flink-15-connector-v2.sh
--master yarn-session
-d -Dyarn.application.id=application_1726655793290_0111
--config ./jobs/clickhouse_to_kafka.conf
老实说,对于当前测试,我一开始就没抱什么期望,因为在此之前,就已经尝试了几种用 Flink 去读 CK 的方法,都失败了,结果果然没有让我失望。
来看一眼任务提交后的状态:
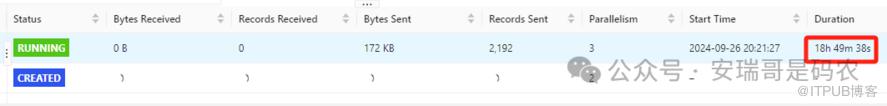
跑了 18 个多小时(已经重试几次了),结果 sink 这部分还在转圈圈,你受得了不?
1.3 其他尝试
既然写 Kafka 行不通,于是我又换成 console,发现:
用 Spark 引擎:可以;
但用 Flink 引擎:依然不行;
2. 读 Doris 写 clickhouse
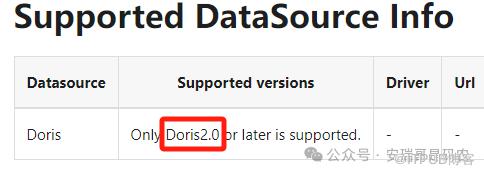
官网要求 Doris 的版本要在 2.0 及以上,而我当前的集群是满足的(2.1.2)。
具体配置:
env {
  parallelism = 2
  job.mode = "BATCH"
}
source{
  Doris {
      fenodes = "192.168.221.173:8030"
      username = root
      password = "****"
      database = "test"
      table = "test07"
  }
}
sink {
  Clickhouse {
    host = "192.168.211.109:8123"
    database = "test"
    table = "test07"
    username = "default"
    password = "***"
  }
}
2.1 Seatunnel 利用 Spark 引擎
先说结论:能跑成功,但丢数据!
提交命令:
bin/start-seatunnel-spark-3-connector-v2.sh
--master yarn
--deploy-mode client
--config jobs/doris_to_clickhouse.conf
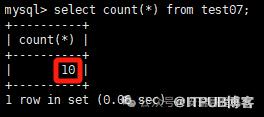
Doris 原始表就这么可怜的 10 条数据:
跑完之后,进到 CK 表的数据居然丢了一半(试了两次,效果一样):

你受得了不,关键我这 CK 用的可是普通引擎,根本不存在数据被合并一说,谁能给我一个解释。
另外这里还有一个小坑:
那就是虽然之前我已经把所有 Seatunnel 支持的数据源(source),以及数据目的地(sink)相关的 connector 都一口气全下载好了。
但是,如果想读(或写) Doris,你还得再额外下载一个 MySQL 的 driver 包。
这个是官网的说明,看上去多少有点隐蔽:
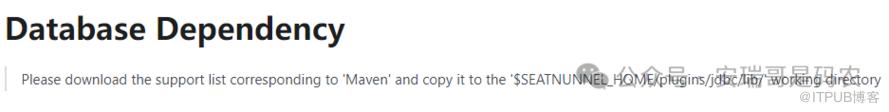
下载到这个地方:

不然,就抛下面这个异常:

2.2 Seatunnel 利用 Flink 引擎
先说结论:能跑成功,且不丢数据!
提交命令:
bin/start-seatunnel-flink-15-connector-v2.sh
--master yarn-session
-d -Dyarn.application.id=application_1726655793290_0111
--config ./jobs/doris_to_clickhouse.conf
原本的 10 条数据,利用 Flink 引擎导入到 CK 后。

这一次,终于不丢了。
3. 读 Kafka 写 Doris
具体配置:
env {
  parallelism = 2
  job.mode = "STREAMING"
}
source {
  Kafka {
    schema = {
      fields {
        id = "int"
        name = "string"
        age = "int"
      }
    }
    format = text
    field_delimiter = ","
    topic = "test"
    bootstrap.servers = "192.168.211.107:6667"
    kafka.config = {
      client.id = client_02
      max.poll.records = 500
      auto.offset.reset = "latest"
      enable.auto.commit = "false"
    }
  }
}
sink {
  Doris {
        fenodes = "192.168.221.173:8030"
        username = root
        password = "***"
        database = "test"
        table = "kafka2doris"
        sink.enable-2pc = "true"
        sink.label-prefix = "prefix_csv"
        doris.config = {
          format = "csv"
          column_separator = ","
        }
    }
}
3.1 Seatunnel 利用 Spark 引擎
先说结论:不能以流方式运行!
提交命令:
bin/start-seatunnel-spark-3-connector-v2.sh
--master yarn
--deploy-mode client
--config jobs/kafka_to_doris.conf
既然是 Kafka 数据源,居然不能以 streaming 的方式来跑。
下面这个截图,是任务提交到 yarn 之后的 UI 界面,跟传统的 streaming 任务相比,很明显少了个「streaming 选项」。

读 Kafka,居然都不能以流的方式,那我要你有何用?你干脆说不支持不就得了吗?
3.2 Seatunnel 利用 Flink 引擎
先说结论:运行结果符合预期!
提交命令:
bin/start-seatunnel-flink-15-connector-v2.sh
--master yarn-session
-d -Dyarn.application.id=application_1726655793290_0111
--config ./jobs/kafka_to_doris.conf
运行状态:
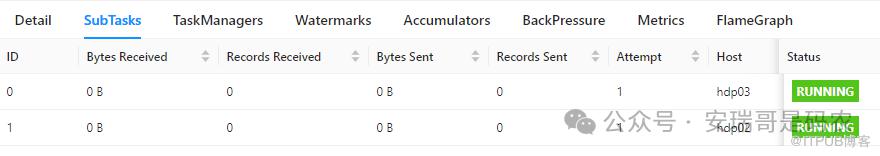
通过往 Kafka 不断写数据后,经过 Seatunnel 处理后,数据能正常 sink 到 doris 表(就不截图了,麻烦)。
最后
经过这 3 个场景的测试对比,基于当前最新版本的 Seatunnel,可以得出下面几点结论:
1,Seatunnel 无论是用 Spark 引擎还是 Flink 引擎,想把数据 sink 到 Kafka,目前来看,都行不通;
2,Seatunnel 可以用 Spark 引擎读到 CK 数据,但用 Flink 引擎不可以;
3,Seatunnel 利用 Spark 引擎以及 Flink 引擎都可以把 Doris 数据写到 CK,但是,Spark 引擎会丢数据;
4,对于 Kafka 数据源的读取,Spark 引擎不支持「流」的方式,而 Flink 可以。
从这次的测试结论来看,Spark 引擎跟 Flink 引擎的 PK 结果是: Seatunnel 对 Flink 引擎的支持,似乎要更好一点点。
至于 Seatunnel 自带的引擎表现怎么样,有的同学跟我说还可以,但因为暂时还没有实测,先不讨论。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

