上篇文章关于 Seatunnel 的初体验,比较简单的过了一遍它的软件部署、环境配置、以及基础功能的跑通。
从体验结果来看,虽然也有不少瑕疵,比如我关心的,对 Flink on yarn 的支持并不全面(只支持 yarn-session 模式),以及对于 Spark 跟 Flink 引擎的玩法说明,官方文档也只是轻飘飘带过,剩下的,全靠悟,但一些我比较关心的功能,从初步体验来看还是支持的。
那么从今天这篇文章开始,就正式开启 Seatunnel 在面对真实数据需求场景时的实测,而这第一测,就从大家使用比较多的 MySQL CDC 数据源开始。
(提前剧透:表现拉胯!)
0. 测试设计
根据以往的测试经验,这次读取 MySQL CDC 数据后,我准备给它设置两个不同的 sink,其中第一个 sink 为简单的控制台输出(console),而另一个 sink ,我把它输出到 Kafka。
所以,针对这次实测的测试流程安排如下:
测试1:将 MySQL CDC 数据源读取后,直接打印出来。

测试2:将 MySQL CDC 数据源读取后,输出到 Kafka。
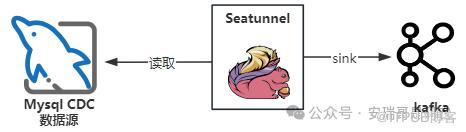
你可能会好奇,这两种测试方式能分别得出什么样的结论,别着急,接着往下看。
1. Mysql CDC 到 console
从官网描述来看,Seatunnel 是支持 Mysql CDC 数据源的。
这里的 Mysql CDC 数据源跟 MySQL 数据源的区别在于,前者需要 MySQL 开启 binlog,且是以「流」的方式进行传输。
后者只是用简单的 jdbc 协议,不需要 binlog 支持,且只能以「批」方式进行传输。
而因为是用 CDC 方式传输,所以这个时候 Seatunnel 的引擎,就不能支持 spark 了(因为 Spark 不能以 CDC 方式读 MySQL)。
为了能让 Seatunnel 成功读取 MySQL CDC 数据到 Kafka,这里以 Flink 引擎作为测试。
1.1 先启动 yarn-session
上篇文章中以经测试过了,Flink on yarn 支持的几种运行方式中,木有只有 yarn-session 方式跑能跑通,所以这里需要先启动它。
而因为目前最新版本的 Seatunnel,只明确支持 Flink 1.15 跟 1.16,所以这里先启动 Flink 1.15 的 yarn-session。
[flink@hdp01 flink-1.15.3]$ bin/yarn-session.sh -d
1.2 任务配置文件
接下来,就是配置 MySQL cdc 数据源 sink 到 console 的任务配置,如下(mysql-cdc_to_console.conf):
env {
  parallelism = 3
  job.mode = "STREAMING"
  checkpoint.interval = 10000
}

source {
  MySQL-CDC {
    base-url = "jdbc:mysql://192.168.221.132:3306/test"
    username = "***"
    password = "****"
    table-names = ["test.test001"]
    startup.mode = "initial"
  }
}

sink {
  Console {
  }
}
把一张开启了 binlog 功能的 MySQL 表(只有几行数据),以 3 个并行,CK 时间为 10 秒,且以流的方式进行导出到 console(直接打印)。
1.3 启动任务
利用 Flink 引擎的启动命令为:
bin/start-seatunnel-flink-15-connector-v2.sh
--master yarn-session
-d -Dyarn.application.id=application_1726655793290_0111
--config ./jobs/mysql-cdc_to_console.conf
任务启动后,虽然设置的是 3 个并行,但实际上只有一个在 running。
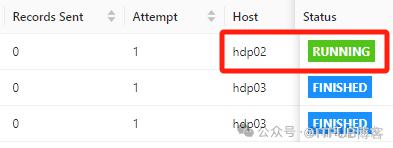
可能是 Flink 觉得,既然就这么点数据,而且输出方式是直接打印,那就不要浪费资源了,从 yarn 的资源分配结果可以看出来,它实际只启用了一个 task manager(另一个是 job manager)。
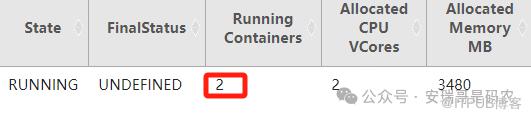
这一点,Flink 表现的比较智能(后面就不了)。
1.4 运行结果
从日志输出来看,历史数据是正常输出了的。
这个是当前 MySQL 的原始数据:
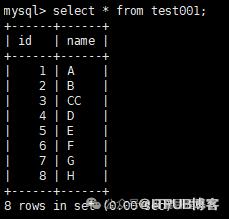
任务运行后,日志的打印情况:
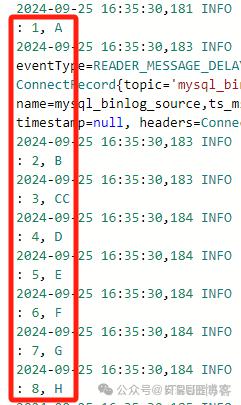
能看到,历史数据输出正常。
接下来,测试 insert。
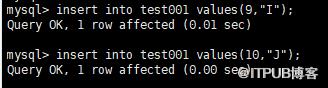
再次查看日志:
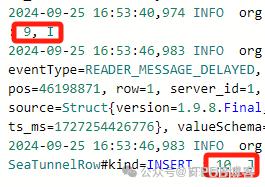
能正常输出。
继续测试 update:

查看输出:

证明 update 能正常捕获。
最后测试 delete:
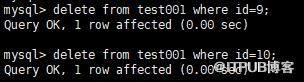
查看日志输出:

证明 delete 变化也能正常捕获。
另,值得注意的一点是,此时的导出任务,是没有去显示设置 checkpoint 目录的。
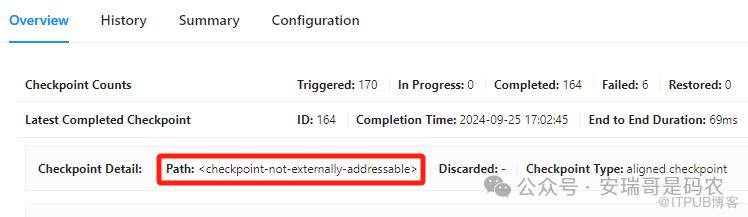
找了半天,也不知道它把这个状态数据存哪了,或者压根就没存,而这,就给下面的测试埋下了祸根。
小结:当 Seatunnel 利用 Flink 引擎读取 MySQL CDC 数据,并且 sink 到 console 时,任务能够顺利的捕获 MySQL 数据的「insert、update、delete」,功能表现符合预期。
2. Mysql CDC 到 Kafka
仅仅只是把 sink 对象,从 console 给换成了 Kafka,测试结论就天差地别。
2.1 任务配置
Mysql CDC sink 到 Kafka 的配置为(mysql-cdc_to_kafka.conf):
env {
  parallelism = 3
  job.mode = "STREAMING"
  checkpoint.interval = 10000
}

source {
  MySQL-CDC {
    base-url = "jdbc:mysql://192.168.221.132:3306/test"
    username = "***"
    password = "****"
    table-names = ["test.test001"]
    startup.mode = "initial"
  }
}

sink {
  kafka {
      topic = "test"
      bootstrap.servers = "192.168.211.107:6667"
      format = json
      kafka.request.timeout.ms = 60000
      semantics = EXACTLY_ONCE
      kafka.config = {
        acks = "all"
        request.timeout.ms = 60000
        buffer.memory = 33554432
      }
  }
}
跟上一个任务比,除了 sink 部分的配置不同外,其他的都是一毛一样。
2.2 启动任务
启动命令如下:
bin/start-seatunnel-flink-15-connector-v2.sh
--master yarn-session
-d -Dyarn.application.id=application_1726655793290_0111
--config ./jobs/mysql-cdc_to_kafka.conf
也是除了配置文件名不一样外,其他的一毛一样。
2.3 运行状态
任务成功提交到 yarn 集群之后,跟上面任务不同的是,这里是正儿八经地,在 3 个不同的服务器上,起了 3 个并行的 task manager的。
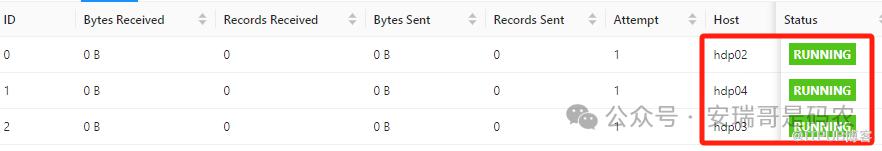
起了 3 个 task manager
从 yarn 分配的 container 的数量也可以看出来,比上一个任务多了 2 个。
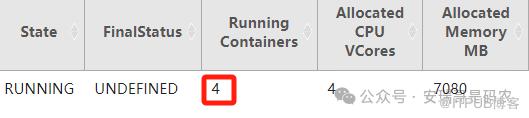
虽然占了更多资源,但干的事情却非常的拉胯(跟你公司部分同事一样,虽然工资拿的比你高,但做事跟坨屎一样)。
因为这个任务没跑一会(也就1分多种),就嗝屁了,抛了下面这么个莫名其妙的玩意:
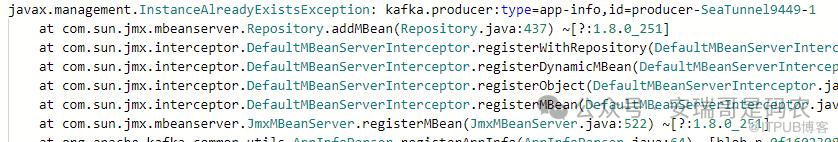
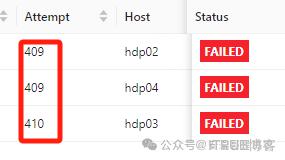
而且从此一蹶不振,即便重试了几百次也没有一点鸟用:
不过好在,历史数据它是可以导出成功的。

从报错的日志,再结合我之前测 Flink CDC 趟的坑,大概能嗅出一丝,可能是因为状态问题导致的异常。
于是,我把解决的重心放到了任务的 checkpoint 配置上,还记得上一个任务提到过,它是没有设置 checkpoint 目录的(默认没有,或者说没卵用),而当前这个任务,自然也一样。
于是,我就根据官网的描述,去小心翼翼的,一步步去做相应的设置。
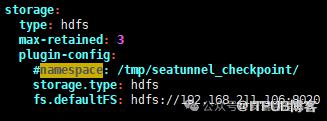
然鹅,一点鸟用都没有,任务启动后,还是这个熊样,异常还是那个异常,依然没有 checkpoint 目录。

不知道是我水平太低,看不懂它的配置策略,导致始终配置不对,还是它这破玩意,根本就没有经过实践的验证,搁这净扯犊子的。
总之,对于当前这个测试结论:差评!(主要是我反复试了很多次)
3. 吐槽
本来觉得,既然通过 Seatunnel 来配置任务的 checkpoint 目录行不通,那咱就通过 flink 来设置呗,因为它本质就是个 Flink 任务。
于是乎,我在部署 Seatunnel 的这台机器上,同样也是 Flink 客户端的机器,把 Flink 的配置文件,添上了 checkpoint 目录。
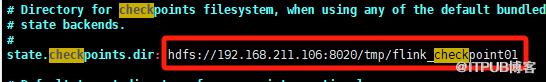
再次启动任务。
这一次,checkpoint 目录终于有了。
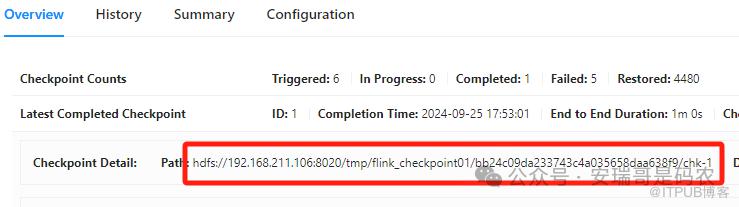
但是,没跑多久,任务还是挂球了。
至于抛出来的异常,跟之前的不能说像,那就是一毛一样。
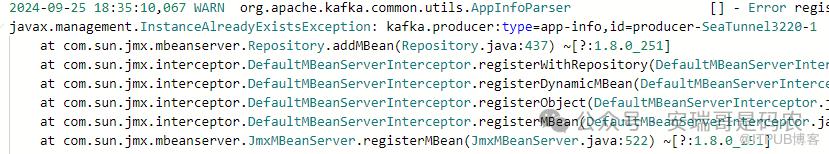
最关键的是,经过这么一折腾,这次任务重试之后,居然连历史数据都导不出来了,就问你神奇不神奇?
(PS:后面我又试了 Seatunnel 自带的引擎,也搞不定,只是抛出的异常不一样而已)
最后
本来以为是个挺平常的测试,本来以为这次能轻松过关,本来...
经过这次实测,让上次测评留下的些许好感,现在已经所剩无几。
这次实测的结论是:如果下次再想导出 MySQL CDC 数据,sink 到其他的存储里(比如 Kafka),我会老老实实用回 Flink CDC 的。
也证实了评论区一些同学的留言,这玩意现阶段还有太多问题,后面的升级优化之路任重而道远。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

