上篇文章测试了 Spark 如何用分布式读取 MySQL 的实现方案,并且演示了在当前表字段类型都不符合「分区字段」要求的情况下,可以通过怎么样的「骚操作」,来达到将数据平均切割的目的。
但利用这种分布式读取 MySQL 数据的方法,只是我们对程序优化的一种手段,最终能不能达到「节省硬件资源」或者「提高计算效率」才是我们追求的目的。
那经过上次对 MySQL 数据的切割之后,Spark 处理它需要的「硬件资源」到底有没有变少?以及对应的「计算效率」有没有变高?
这一次,我们一起来验证一下。
0. 不分区时需要资源跟效率
默认情况下,Spark 读 MySQL 只有 1 个分区,所以就要求这个分区能承载所有的数据量,记得当时要读取这张数据量为 1600w+
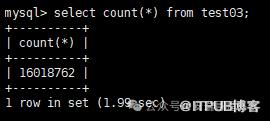
用特定的计算方式进行计算时,需要的「最小」内存为:
executor 内存量:2G。
--executor-memory 2g
占用的 yarn 总内存为:约3.5G

而当我们把原本的单个分区,给平均切成 10 个之后,需要的最小内存是多少?以及想要实现最高效的计算效率,应该采用什么样的并行策略呢?
1. 采用单个并行时——基准测试
作为对照,第一次测试,我们对 Spark 采用单并行策略,也就是
「1个 executor,配 1个 CPU」。
1个并行运行时
经过实测,能成功执行完任务,需要的 executor 内存设置为:512MB。
--executor-cores 1 --num-executors 1 --driver-memory 512m
占用的 yarn 总内存为:不到2G。
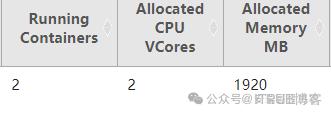
任务执行时间:约2分钟半(多次测量取平均值)。

小结:1个并行度时,相比之前 MySQL 采用默认分区(1个分区),Spark 需要的内存量大幅减少(少1.5G),但任务执行效率也由原来的约 1分钟,提高到约 2.5分钟。
2. 单 executor,2 CPU 时
在上一个基准测试时,细心的同学可能发现了一个问题,那就是既然原来 1 个分区时,需要的 executor 内存大小为 2G,那么现在把数据切成了平均 10份,理论上单个 executor 需要的内存就只需要大概 200M 就够了呀?
那为毛上面还要把 executor 的内存设置为 512M 呢?
如果你有这个思考,说明前面几期的测试结论,你真的看进去了,这里之所以单个 executor 给设置 512M,而不是 200M,原因在于:
yarn 不允许,目前我的集群环境,yarn 允许设置的最小 executor 内存大小,只能是 512M!
既然让 512M 的 executor 只跑 1 个分区的数据有些浪费了,那我们就让它并行跑 2个(或者更多个),这样一来,平均单个分区分摊的内存,就是 256M 了(或者更少)。
于是,当前对于 executor 的内存和并行度设置为:
--executor-cores 2 --num-executors 1 --driver-memory 512m
这样一来,虽然只有 1个 executor ,但并行度变成了2:

2个并行运行时
此时 yarn 占用的总内存不变,不变。
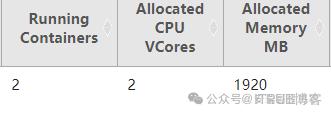
但因为并行度由原来的 1个,提高为 2个,所以执行效率肯定会提高。

由原来的 2.5分钟,提高到只需要 1.6分钟(多次执行取的平均值)。
小结:通过分析单个 executor 有富余的内存空间,提高单个 executor 的并行度,在硬件资源消耗不变的情况下,可以有效提高任务的执行效率。
3. 单 executor,3 CPU 时(依然可行)
这个时候,executor 的内存和并行度设置为:
--executor-cores 3 --num-executors 1 --driver-memory 512m
单个 executor 的并行度为 3:

3个并行运行时
yarn 占用的总内存量,依然跟上面一样保持不变(不到2G)。
按理说,这个时候,Spark 每个 partition 平均分得的内存量就为 512/3 MB。
那是不是就不够了呢?
结果你猜怎么着,它依然能跑成功(没有出现我认为的 OOM),但有一点可以确定的是,这个时候,单个 partition 的内存肯定是非常紧张的。
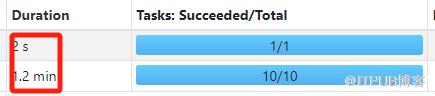
这个时候,整个任务执行时间,再一次缩短为 1.2分钟。
小结:通过单 executor 设置 3个并行度,依然在硬件资源消耗不变的情况下能跑成功,且执行效率,比 2个并行更高一些。
4. 单 executor,4 CPU 时(扛不住了)
如果说,上一个设置单 executor 3 个 CPU 是当前这个任务能承载的内存极限(512MB),那么当前的这个设置,毋庸置疑就是在找死。
事实证明,这一次,雀食行不通了,OOM 它终于来了。
5. 最高效且最节省资源的配置(3 executor,3 cpu)
如果现在要你对当前这个任务,用效率最高,且最节省资源的方式把它给跑起来,应该怎么设置?
应该这么来:
--executor-cores 3 --num-executors 3 --driver-memory 512m
你觉得呢?
这个时候,权衡资源最省、且效率最高时的最大并发为:9个。

9个并行运行时
这个时候 yarn 占用的总内存大小为:约3.8G
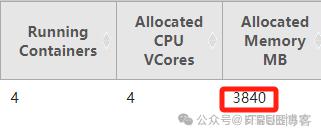
(这里怀疑是 yarn 显示的 bug,消耗的 CPU 应该为 10 才对)
执行效率为:约 1分钟。

小结:通过权衡资源消耗的最小化,以及执行效率的最大化,对于当前任务,需要 3个 executor,以及每个 executor 3个 CPU,消耗约3.8G 内存。
最后
所以,经过这样一番折腾,发现什么问题没?
在什么都不调整,不设置的情况下(单数据分区),面对相同的逻辑计算,把任务跑成功时。
任务执行效率为:不到 1 分钟。
占用 yarn 总资源为:约3.5G。
而现在呢?
分布式是实现了,但就算我们「挖空心思」,以「性价比」最高的方式来跑这个任务,在所消耗的硬件资源,比之前什么都不做还要高的的情况下,执行效率也就是勉强打个平手。
说明什么?
说明分布式的计算方式,并不是在任何情况下都是最优解决方案,如果数据量相对比较小,且单个节点的算力能完全能 hold 住,那用「单节点方式」可能更划算。
毕竟,分布式情况下,天然需要的「基础硬件成本」、和「必要的网络通信开销」是任何一个分布式任务绕不开的。
所以,基于什么样的数据量,用什么样的计算方式,你心里有谱了吗?
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

