上两篇文章分别测试了对于一张 80w+ 的 MySQL 表,用最新的 Flink CDC 3.1.1 导出到 Kafka 时,内存优化前,以及内存优化后,taskmanager 的总内存耗费情况。
从测试结果来看,无论是优化前的,需要 20G 内存,还是优化后的需要 13G 内存,在内存消耗上都有些过大了。
毕竟,对于这张 MySQL 表来说,算上它建的索引,总数据文件大小也才 4G,而从实际的 flink 导出任务界面来看,输出的「纯数据」部分,也才 1.57G。
于是就有同学留言说,这内存消耗也太大了。
另外,还有同学在群里说,上篇文章只是优化了 taskmanager 的内存,能不能把 jobmanager 的内存优化也顺便讲讲?
就着这两个问题,今天这篇文章,咱们就再一次,通过同时优化 jobmanager 的内存,以及再次「压榨」taskmanager 的内存,在保证任务导出不受影响的情况下,看还能节省多少出来?
1. 先调整 jobmanager 内存
个人觉得,如果你能削微认真一点,看完我上篇文章对 taskmanager 的内存优化思路,那这个对 jobmanager 的内存优化,就应该跟玩似的。
同样,还是来观察一下这个 jobmanager 在工作的时候,内存的变化情况。
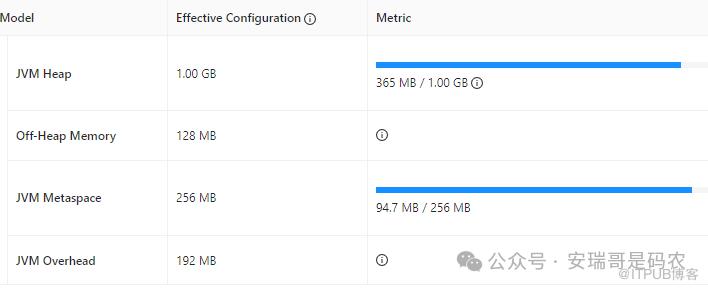
jobmanager默认的内存布局
这里得夸一下 Flink,虽然它的的内存布局很花里胡哨,但好在人家在跑任务的时候,可以给你动态显示一些关键内存的消耗情况,给你的内存优化,提供非常直观有力的直接证据,这点比 Spark 强。
从目前观察到的 jobmanager 内存消耗情况来看,「JVM Heap」跟「Off-heap Memory」是内存占用的两个大户。
而且,因为 jobmanager 不干活,这两部分的内存,咱可以尽量给它压榨到最低。
来试试,通过启动 yarn-session 时,把这两部分的参数设置为如下值:
-Djobmanager.memory.heap.size=256m -Djobmanager.memory.jvm-metaspace.size=100m
可以看到,yarn-session 服务启动后,其内存结构变化如下:
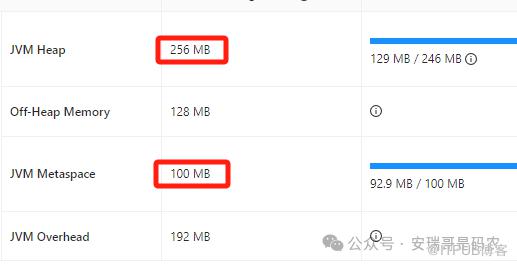
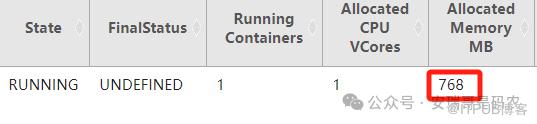
这个时候,消耗的 yarn 内存大小为:
对比一下内存优化之前,jobmanager 的内存占用大小为:
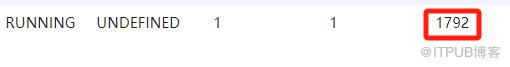
相比之下,优化后 jobmanager 的内存节省了整整 1G。
可能到这里,有同学会怀疑,你这内存优化后,服务虽然能启起来,但不代表就一定能满足跑任务的需求呀!
确实如此,事实上,以上这个调整的参数,是我多次尝试之后,能成功跑完上次那个表的数据后才确定的,前面因为内存调整的太低,程序在运行过程中崩过几次。
2. 调整过程中的注意事项
如果你要把 jobmanager 调整到一个相对很小的值,辣么,你首先得摆脱 Flink 主配置文件中,默认的 jobmanager 设置。
最好的做法是,把 Flink 主配置文件(flink-conf.yaml),下面这个地方给注释掉:

要不然,当你用上面的方式,把 jobmanager 那两个参数的值调得很低后,跑任务时,就会这样:

同样,如果要把 taskmanager 也调到一个相对比较小的值,也要把配置文件中,下面这个部分给注释掉:
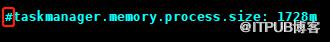
要不然,有些同学在面对这样的报错时,很容易一脸懵逼。
3. taskmanager 的内存还能再降不
既然上次已经把 taskmanager 内存结构中,最容易优化的部分做了调整,那么这一次,就只能对付接下来的硬茬子了。
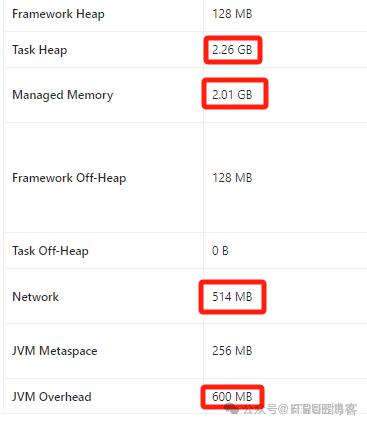
同时,把上一次调整过的部分,再进行一次尽可能的压榨。
经过多次调整和测试,对 taskmanager 的内存参数设置如下:
-Dtaskmanager.memory.task.heap.size=2400m
-Dtaskmanager.memory.managed.size=50m
-Dtaskmanager.memory.network.max=100m
-Dtaskmanager.memory.jvm-overhead.max=200m
最终,消耗的 yarn 内存总数为:

最终优化后,任务消耗内存总量
相比第一次优化前的内存消耗:

优化前,任务消耗内存总量
内存节省了近一半。
而对于数据的导出效率来看,依然没有变化。

最后
之前多次被问到,对于这种分布式计算引擎,什么样的数据体量,需要消耗多大的内存这种问题?
理论上来说,这个问题是个「迷」,你几乎不可能用一套标准的公式,去计算处理多大的数据源,需要用到多少内存。
我们能做的,最多只能根据「数据计算总量」以及「数据计算方式」来先估算,然后再通过设置具体的内存参数去试。
在每一次试错中,去调整具体的参数大小,最终找到一个适合当前任务的值,只有这种方式,才是最靠谱的。
最后,关于这部分其实还遗留了一个问题,那就是,虽然从当前的实际测试来看,Flink 任务的内存消耗,还是远大于实际的总数据量。
但是,随着后续数据源总量的不断增加,比如倍数增长,Flink 的内存消耗,是不是也会呈现倍数增长的趋势?
关于这个谜底,咱们下一期揭晓。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

