上篇关于 Flink 导出比较大的 MySQL 表文章发出来之后,有同学留言说,其中的部分槽点,可能是因为我用的 yarn-session 模式导致的。

首先,非常感谢这位同学的留意,作为纯技术性讨论,我个人有点如下不同的看法。
其中他提到「yarn-session 一般不上生产」这个观点,我是不同意的,yarn-session 这种方式最大的特点在于,它提前启动了一个 jobmanager 服务,它的好处有。
一者:后续依附于这个 yarn-session 的 Flink 任务,启动时效率会更高,同时,因为可以多个任务共用一个 jobmanager,也可以减少一些不必要硬件资源的消耗;
二者:yarn-session 这种管理模式,可以将多个业务性质相同的 Flink 任务放在一起集中管理,可以做到同时启动,以及同时销毁,运维效率更高。
其实,类似的言论还有 Spark 的「yarn-client」只适合做测试,也不适合上生产,我就特别想知道,这都是谁规定的?
另外,留言中还提到,说之前用 yarn-session 的运行方式消耗的资源过大,可以试试用 yarn-application 的运行模式。
Emm... 我只能告诉大家,Flink CDC 3.x,它压根就没有提供所谓的「yarn-application」模式,人家就提供了一个「yarn-session」玩法,谁要是不信邪的话,可以去试试。
澄清了关于上篇文章的几个疑虑之后,咱们来正式开启今天的主题——Flink 的内存优化。
0. 内存消耗说明
在开始之前,我们先来瞅一眼,上次用 Flink CDC 3.1.1 导出的那张 80万记录的 MySQL 表,耗费内存的情况。
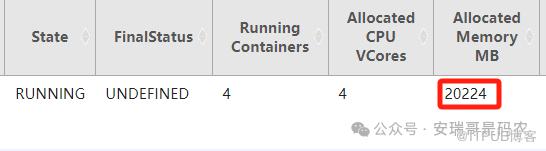
上文说了,当时分配的 3 个并行度,也就是 3 个 taskmanager,每个 taskmanager 给的是 6G 内存,才勉强让任务顺利执行成功,至于 jobmanager 的内存,用的是默认值。

但是,细心的你也许已经发现了一个问题,讲道理,按照这么个内存分配原则,那么这个进程实际的内存占用
6 * 1024 * 3 + 1600 = 20032MB
应该为 20032MB 才对呀,那为啥实际上是 20224MB 呢?
这又是咋回事?
来,看这里。

对于这种分布式任务,我不知道你们平时有多少人会去仔细看这样的日志。
刚才那个内存大小对不上问题,日志这里做出了详细的解释,来解读一下,估计有很多同学还不清楚。
任何一个跑在 yarn 上面的分布式任务,它的内存分配方式都有自己的一套规则,并不是你配置多少,它就给你多少,而是取 yarn 配置中,跟你指定的内存最接近的,这个「yarn.scheduler.minimum-allocation-mb」值的倍数。
这个「yarn.scheduler.minimum-allocation-mb」,在我的集群里,配置的是 256MB,所以 yarn 分配给这个任务的总内存就为:
256 * 24 * 3 + 256 * 7 = 20224MB
理解了吧。
1. Flink 进程的内存组成
才 26 个字段、80w 数据量,算上索引的占用一起,也就 4个G的存储大小,为毛会耗费这么大的内存呢?
带着怀疑跟好奇,我们先一起来看下 Flink 相关的内存参数设置:
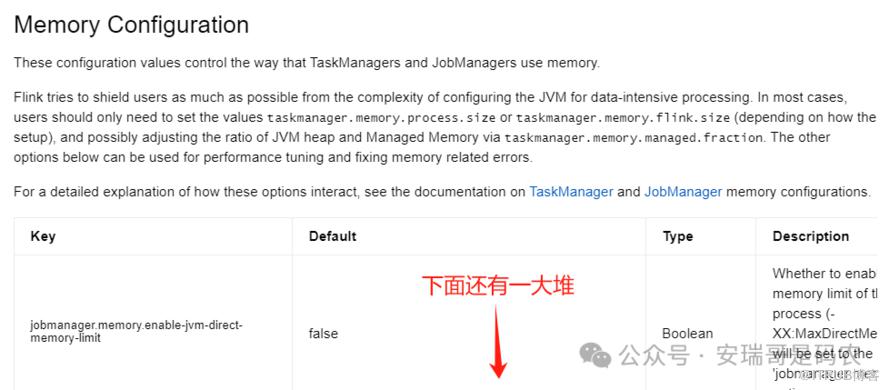
我数了下,一共有 26个之众,作为一个使用者,如果你想每个参数都去搞清楚,在执行任务时都去设置一遍,要么你太闲,要么你爱折腾。
为了弄清楚其中的核心参数,我们来观察这个给 Taskmanager 分配了 6G 的任务,在执行过程中,Taskmanager 用到的,且干系重大的那一部分,看这里。
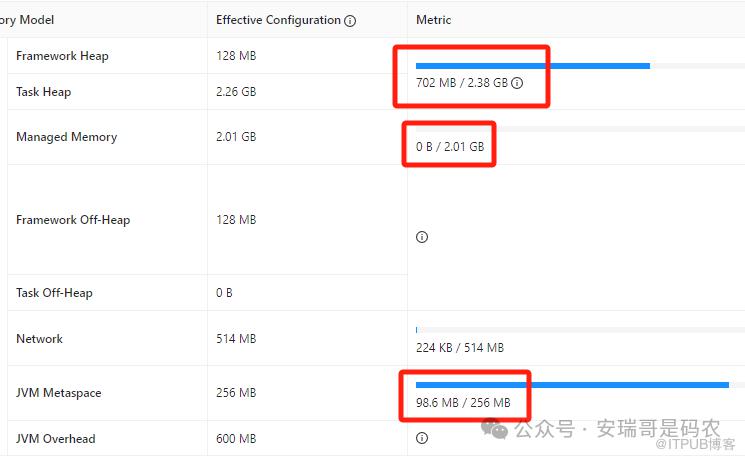
从我的观察来看,对于当前的 Flink 任务来说,比较重要的几个参数如下:
1. Framework Heap + Task Heap:这 2 部分加起来为 2.38GB,其中 Framework Heap 内存是 flink 预留出来的,不管它。Task Heap 是在任务运行时消耗最大,变化幅度也最大,是当前任务最重要的内存部分;
2. Managed Memory:从官方文档描述来看,这部分内存主要用来在数据计算时的聚合排序用的,被瓜分了 2.01G,但从当前任务运行过程的观察来看,它的消耗情况始终都是 0,很浪费;
3. JVM Metaspace:这部分默认为 256MB,虽然它的消耗情况在本任务中一直在变化,但占用不大,也一直都是够用的。
所以,接下来如果要优化内存结构的话,重点在于对 1,2 点的调整。
2. 内存布局调整
对于当前这个给 Taskmanager 分配了 6G 的 Flink 任务来说,如果直接是通过「taskmanager.memory.process.size=6G」这种胡子眉毛一把抓的内存指定方式,从上面的内存布局观察来看,很显然有些太浪费了。
既然分析出来,对于当前任务,内存消耗最多的是「Task Heap」,而最没有用的是「Managed Memory」,至于其他的,因为关系不大,且默认值都比较小,就可以暂且先不管。
那,咋调?
看这里。
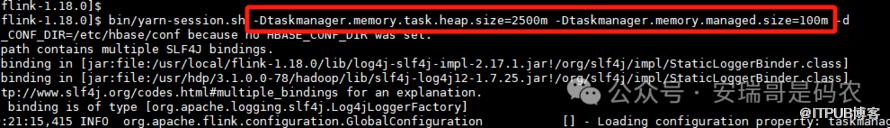
我们就只用把「Task Heap」给调到一个合适的值(2500MB,也是我多次试出来的),而「Managed Memory」,因为几乎不用,给个 100MB 意思下就行了。
来看下提交新的 Flink CDC 任务后,新的内存布局情况:

很明显它生效了。
再来瞅一眼,对于这个任务来说,yarn 整体的内存消耗:
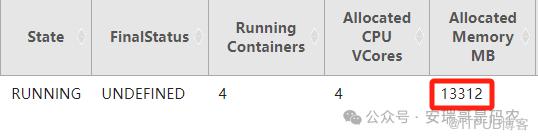
对比一下内存优化之前的。

同样,经过 4 分多钟的运行,所有数据全部顺利导出:
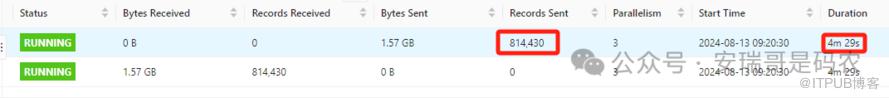
怎么样?同样的任务,同样的数据量,但经过内存的优化调整之后,内存可以节省约 7G,但导出效率不变。
最后
如果你是个对性能/资源消耗,有着极致优化追求的人,其实对于我的这个案例来说,还有进一步优化调整的空间。
毕竟,对于一个 Flink 任务来说,能够给予用户控制的内存参数,实在是太多了,如果你愿意,完全可以把控制内存的这 26 个参数,挨个都自己设置一遍。
但更多时候,为了效率,我们要学会「抓大放小」,控制住核心的那少数几个就可以了,你觉得呢?
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

