上篇文章记录了最新 Flink CDC 3.1.1 的部署,以及它的功能表现,从部署过程来看,有些地方表现的很蛋疼,官方文档描述不清不楚,个别的设计逻辑也让人分分钟想打人。
不过好在,结局还行,该有的功能,咱最终还是都给他跑出来了,可喜可贺。
如果说上一次的功能性测试只是洒洒水,那么这一次,咱就给它拉到生产环境,看它在面对凶险的环境下,表现如何?
0. 凶险设置
讲道理,为了避免给自己惹太大的麻烦,我这里先选一张数据量相对没辣么大的,26个字段,已经有80w+(数据文件大小为4个G)历史数据的 MySQL 表先试试水。
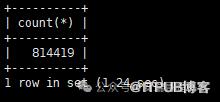
准备把这部分历史数据,用 Flink CDC 3.1.1,给同步到 Kafka。
理论上,如果以当前 Flink CDC 默认的内存大小、并行度、以及数据读取速率的话,我猜,很可能在数据导入过程中出现 OOM。
那针对这个 OOM,咱们准备两种应对策略:
策略1:在进程默认内存大小、并行度不变的情况下,调整可能的数据读取速率,让它时间单位读取的效率低一点;
策略2:修改默认的 CDC 内存大小(taskmanager内存),让它满足对应的内存需求。
1. 默认参数情况下
所谓默认,就是我啥参数都不动的情况下去跑。
任务启动后,默认是3个并行度,启动了3个 taskmanager,每个 taskmanager 分配一个 slot。

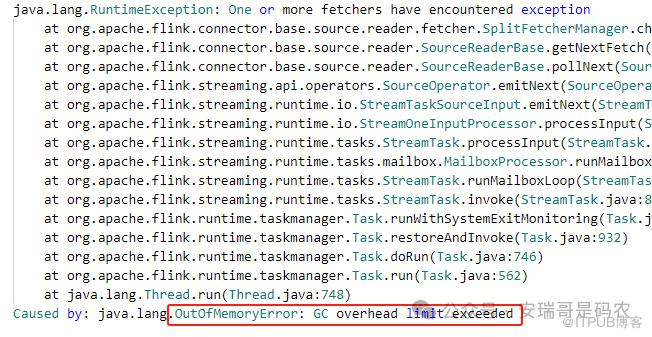
大概1分钟左右,导出数据量约为 40w 的时候,就不出意外的嗝屁了,原因就是:内存不足:
先来瞅一眼,默认情况下,我们的 jobmanager 跟 taskmanager 内存大小。
jobmanager堆内存大小

taskmanager堆内存大小
说明这个时候,默认的内存大小,满足不了当前默认的数据读取速率。
既然这样,那咱就改。
2. 设置读取效率参数
从官网对这个 CDC 参数介绍来看,貌似提供了一些可以控制数据读取速率的参数(至少它是这么解释的)。

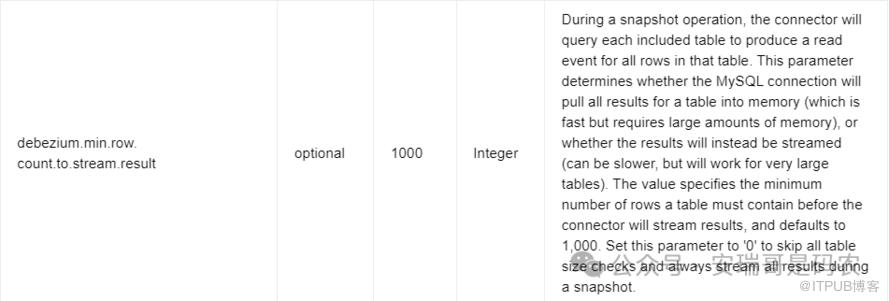
既然找到了,那就试试呗。
于是我就把这3个参数,都给配到了 CDC 任务的主配置文件里,经过多次参数的调整、这个值是越调越低,最后都调到下面这个样子了。
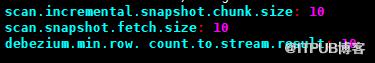
然鹅,从实际测试效果来看,几乎没有任何卵用,我没看到任何数据读取速率上的变化,而且,抛出的异常还是跟原来一个鸟样。
也就是说,这个参数,就是个废的。
(莫非是我设置的不对?如果是,那只能说明官方文档太垃圾)
3. 调整内存大小
既然尝试通过修改数据读取速率行不通,那咱就只能尝试添加任务的运行内存了。
对于当前的这个 Flink CDC 任务来说,jobmanager 的内存大小是可以不用管的,毕竟它又不干活。
我们要调整的,核心是 taskmanager 内存,调谁?
根据官网的介绍,咱暂时优先调整「taskmanager.memory.process.size」这个参数。
从 Flink 的配置文件来看,默认值为「1728m」,既然这个小了,那咱就挨个往上调。
先调到「2000m」试试
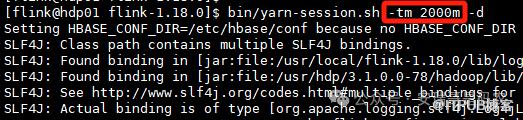
这个时候,taskmanager 的堆内存为:

而且当前运行有 3 个 taskmanager,也就是一共消耗了 6G 内存。
但,还是太小了,依然 OOM。
再调到「3000m」试试
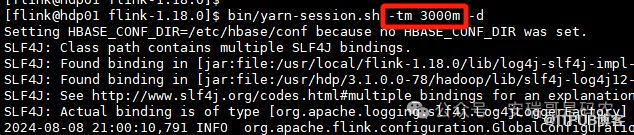
这个时候,每个 taskmanager 的堆内存为:

当前 3个 taskmanager,一共消耗了 9G 内存。
然而,还是不行,依然 OOM。
再调到「5000m」试试

这个时候,每个 taskmanager 的堆内存为:

当前 3个 taskmanager,一共消耗了 15G 内存。
说出来你可能不信,就这张大小只有 4G 的 MySQL 表,当前内存条件下,依然不够,在导出数据量在 40w+ 的时候,还是 OOM 了。
继续调到「6000m」试试

这个时候,每个 taskmanager 的堆内存为:

当前 3个 taskmanager,一共消耗了 18G 内存。
这一次,它终于行了。

80w+ 条数据,3个并行度,耗费近 20G 的内存,才勉强能把它导完,就问你惊不惊喜,意不意外吧。
从上图的显示来看,明明发送的数据量才不到 2G,又不存在数据间的逻辑运算,却要耗费这么大的内存空间,其他内存都干嘛了呢?
4. 几个槽点
各种尝试之后,总算是把这张不怎么大的表给导完了,测试过程中,有几个槽点,不吐不快:
槽点1:数据读取速率没法控制,虽然官网给了一些看上去可以设置速率的参数,但实际上屁用没有;
槽点2:任务运行参数设置过于奇葩。
你会发现,CDC 任务的并行度,可以通过具体的 CDC 任务配置文件来设置(这个合理)。但任务的内存大小参数,又只能通过 Flink 的配置文件(注意还不是 Flink CDC 的配置文件)来设置,或者只能在启动 yarn-session 的时候设置,这就会让你在实际操作过程中,特别的麻烦。
这要是没个几年脑血栓后遗症,我实在想不出哪个正常人可以做出这样的设计,咱就不能换一个脑子正常点的人来吗?
槽点3:失败任务默认会无限次重试。
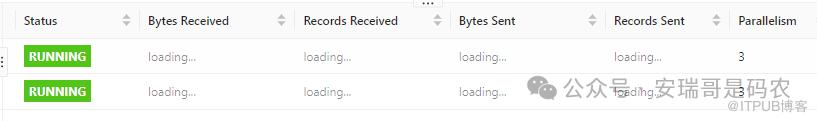
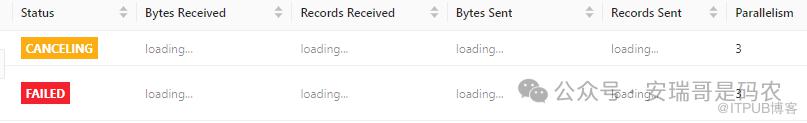
如果导入过程中因为 OOM 异常了,这个 CDC 程序就会跟个神经病一样,一直去重启任务。
从 web 页面看,一会它是这样的:
一会又变成这样的:
然后它又变成这样:
如此这般循环往复,周而复始,都一个多小时了,你会发现,它根本停不下来。
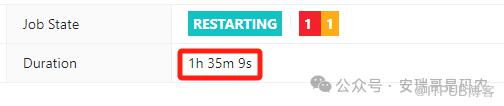
咱就是说,既然重试了几次都不行,那就说明是真的不行,这个时候,停下来,就是进步,懂不懂?(学学人家Spark好不好呢)
最后
虽然生产咱也上了,问题也碰到了,也最终解决了,但总感觉内心没那么痛快。
对于 Flink CDC 任务(或者说所有的 Flink 任务)来说,当前它的这个内存管理,在我看来有点迷。
那为了解开这个迷,我决定再来一期关于 Flink 任务内存管理的内容,你们乐意看不?
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

