继上一次测试 Flink CDC 3.1.0 的糟糕体验之后,最近刚好有个项目需求,希望尽可能以「零编码」的方式把一些数据从 MySQL,给导入到 clickhouse。
这不我又想到 Flink CDC 了嘛,刚好又看到最新的 3.1.1 推出,心想:要不再相信它一次?
于是,我的鼠标又不自觉地点开了它的官网。
本来想着把这个需求的整个实现过程都写下来的,但是又一想,那样怕是文章篇幅有点长,你们都没耐心看,于是咬牙决定,先确保这个 Flink CDC 能顺利跑起来,至于后面的,后面再说。
0. 看官网
从最新的 connector 描述来看,对于我要把 MySQL 表中的数据,给同步到 Clickhouse 的这个需求,即便是最新的 3.1.1 ,依然不能直接搞定。

那根据之前的实战经验,想要用 Flink 把 MySQL 的数据给倒腾到 CK,在不借助外力的情况下,只能分两步走:
第1步:用 Flink CDC 3.1.1 将 MySQL 的数据同步到 Kafka(配置文件+命令行方式,不用编码);
第2步:用 Spark structed streaming 读取同步到 Kafka 的数据,然后再写入到 CK(要编码)。
至于为什么要分两步?有兴趣可以去看看我之前的测试文章。
但是今天这篇文章的任务,只需要实现第1步,用 Flink CDC 3.1.1 以配置文件 + 命令行任务启动的方式,来实现将 MySQL 的数据导入(包含存量 + 增量数据)到 Kafka。
1. 部署 Flink CDC 3.1.1
先下载最新的 Flink CDC 3.1.1,下载地址:https://flink.apache.org/downloads/。
打开这个页面发现,它把 Flink、Flink connector、以及 Flink CDC 的下载都揉在了一起。
鼠标一直往下翻,找到这里:

让人欣慰的是,在这个页面有明确告诉你,它兼容的 Flink 版本是多少。
一顿熟练的操作之后,把安装包下载到目标服务器里,
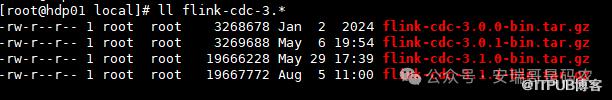
瞅瞅这几个压缩包,不知不觉,我已经测到它们的第 4 个版本了,也不知道今天这一次,它(或者我)到底能不能争口气。
解压之后,得到这样跟以前版本一样的目录结构:

到这一步,最新的 Flink CDC 3.1.1,就算部署完成了。
但是,很明显,如果你的部署只是止步于此的话,那它就跟一坨废铁一样,啥都干不了。
接下来,得部署对应的「数据来源」跟「数据目的地」插件,对于我当前的需求来说,数据来源是 MySQL,数据目的地是 Kafka。
下载 MySQL 插件:
应该是从 3.1 开始,这个 MySQL 插件跟其他插件相比,显得有些膈应人,因为它一次性要下载两个。
1,先下载 MySQL 的 pipeline 插件(下载地址:https://github.com/apache/flink-cdc/releases)。

老规矩,下载后要把它放到 Flink CDC 的 lib 目录下。
2,此外,还要再额外下载一个 MySQL 单独的 connector,对于这一点,官网作了专门的说明 。
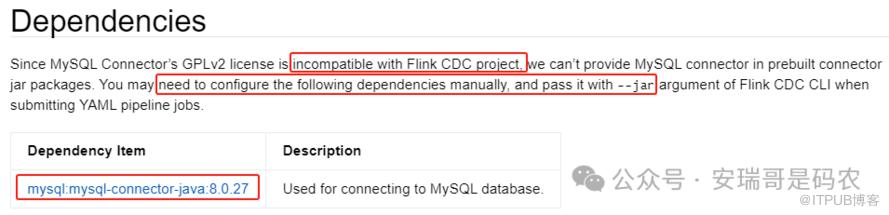
只不过,它需要到 Maven 的中央仓库去下载。
根据文档的描述,你在启动 Flink CDC 任务的命令行中,通过 --jar 参数来指定使用,既然这样,是不是就意味着,这个 connector ,我可以放到一个任意目录里。
下载 Kafka 插件:
跟上面下载 MySQL 插件一样,只不过,对于 Kafka 来说,只需要下载一个 Kafka pipeline connector 就够了。

然后,再次把它放到 Flink CDC 的 lib 目录下。
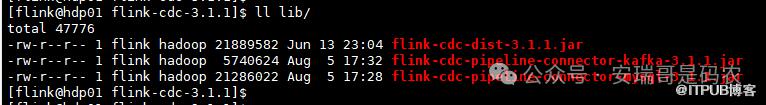
至此,这个 lib 目录下,就有了下面两个插件:
2. 依赖环境准备
老规矩,因为我准备把这个 Flink CDC 3.1.1 跑在 yarn 上面,而且以 yarn-session 的方式,所以这里需要2个环境的准备。
2.1 Flink 环境
在上面下载 CDC 3.1.1 安装包时,下载说明就已经明确告知了,它兼容的 Flink 版本为 1.18。
于是,当前 Flink CDC 默认的依赖 Flink 环境,就得修改(添加)为下面这个样子(修改 flink 用户的概要文件):
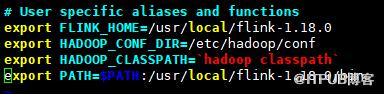
当然,前提是你已经部署了 Flink 1.18,而且,需要它跟 Flink CDC 部署在同一台客户端机器上,否则,它俩互相不认识可不行。
2.1 yarn 环境准备
同样,你得先部署好了 hadoop 的相关组件,而且确保 yarn 的基础服务已经跑起来了,这个是前提(我这里部署的是 hadoop 3.1)。
这部分的重点在于,先用 Flink 1.18 启动一个 yarn session 服务。
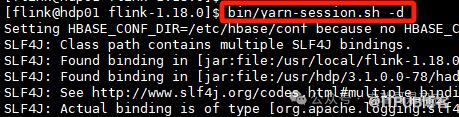
然后,把这个启动后的 yarn session 相关信息,再次写入到 Flink(注意不是 Flink CDC) 的配置文件 flink-conf.yaml 里。
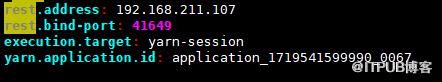
关于这部分的具体信息该怎么找,之前文章有详细说明,有兴趣的同学可以去找找看。
当然,关于这种傻X的硬编码式配置,之前也吐槽过,但很明显,最新的 3.1.1 依然没有任何改进。
3. 跑起来
上面的所有步骤都只是准备工作,接下来才是进入主题。
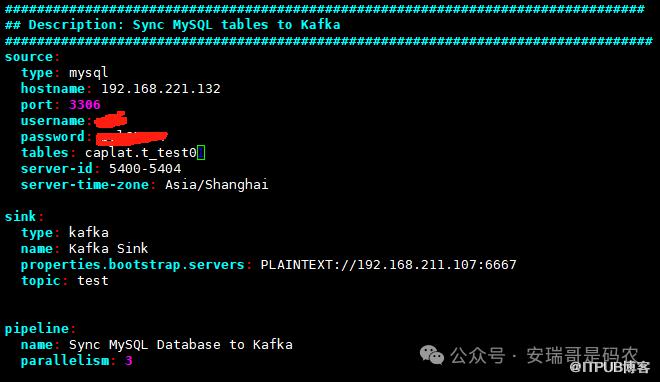
既然是想把数据从 MySQL 导入到 Kafka,那么就需要一个关于它们的配置文件。
来,长这样(mysql2kafka01.yml)。
根据官网描述,启动任务:
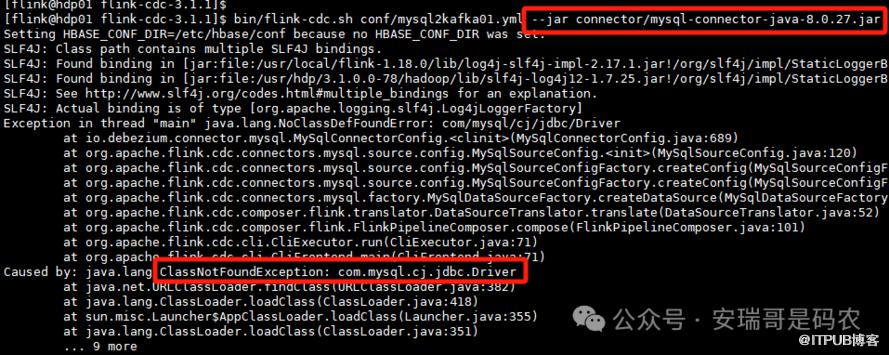
还记得上面在部署 Flink CDC 的时候,下载了个额外的 MySQL connector 吗(注意区别于 pipeline connector)?
官网的描述是,可以通过 --jar 来指定这个 connector 的位置启动,我照做了,但是,明显它报错了。
既然这样,那咱就换个思路,把这个 connector 直接 copy 到 lib 目录下。

这样一来,刚才下载的所有的插件,就都在一个目录下了。
那再次启动,这次按理说就不用指定这个 MySQL connector 的位置了吧。
果然,在命令行确实可以启动成功。
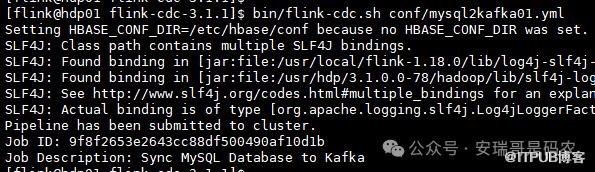
但是,你要是看一眼提交到 yarn 上面的任务日志,能把你气半死。
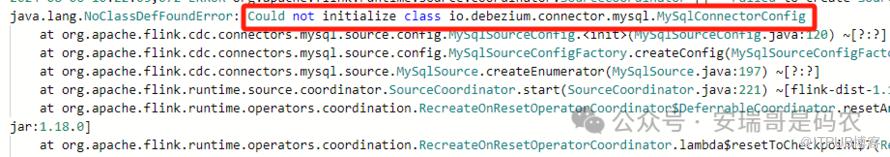
怎么就又TMD,TMD报错了呢?
来,告诉你怎么解决,还是命令行参数的问题,你得这么启动。
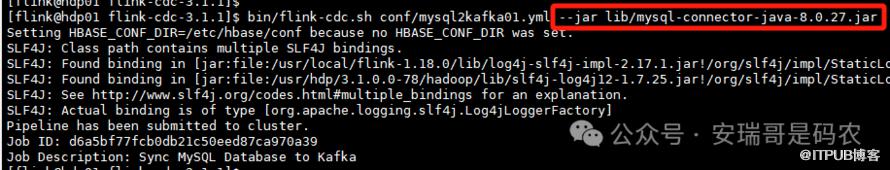
也就是说,就算你把这个 MySQL connector ,放到了它一定会加载的 lib 目录下,你在启动任务的时候,还必须得额外在参数 --jar 里再三叮嘱它一声:乖,别忘了哟!
我就想知道,想出这么个设计的人,脑子里真的没si吗?
4. 查看结果
因为这次只是想测试 CDC 3.1.1 的功能,所以导出的这张 MySQL 表,我只是手动写入了几条数据。
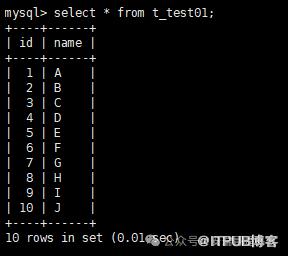
任务正常启动后,历史数据可以正常写到 Kafka。

任务启动后正常运行的截图
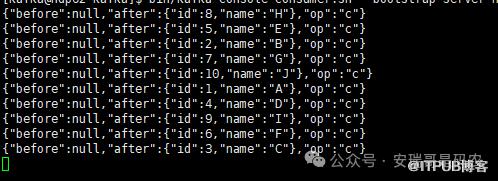
写到Kafka的数据
从测试结论来看,历史数据同步没有问题。
再看增量同步,往里新增几条试试。
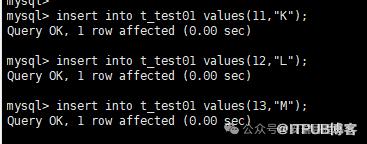
看结果变化。
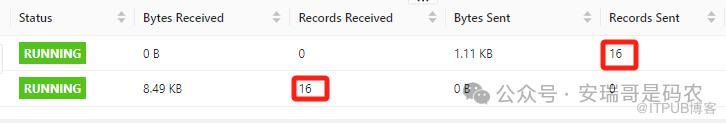

可以看到,新增的数据也可以捕捉到变化。
再看删除的。
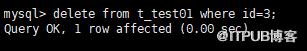
同步到的结果。
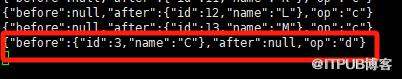
再看update:
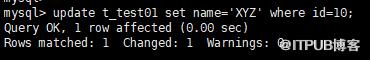
同步到的结果:

至此,Flink CDC 3.1.1 的功能测试基本 OK。
5. 其他需要注意的地方
5.1 关于权限
这里其实也踩坑了,很多人在使用 MySQL 的 CDC 时,特别喜欢用 root,但我不是,所以就能发现更多的问题。
对于同步存量的历史数据来说,你得开启这个权限。
GRANT SUPER ON *.* TO 'mysql_user'@'%';
而如果,你要同步增量数据,还得开启下面这个权限。
GRANT REPLICATION SLAVE ON *.* TO 'mysql_user'@'%';
是不是觉得,咦!还挺麻烦的。
5.2 开启 checkpoint
在我看来,这里又是一个槽点,这个 checkpoint 的开启,目前来看,好像又只能「写死」在 Flink 的配置(不是 Flink CDC)文件里(flink-conf.yaml)。
比如像这样:

什么时候能把这部分,会随着不同任务变化的参数,给安排到命令行参数里(至少官网没有看到),也算是一种进步。
最后
测试了这么多次的 Flink CDC 3.x,历经了辣么多的磨难,这一次,总算是行了。
当然,目前为止,还只是针对它的功能性测试,至于它是不是真的好用,稳定性怎么样,还需要拉到生产环境上溜溜。
期待下一期对 Flink CDC 3.1.1 的生产体验吧。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

