前3篇文章展开聊了 Flink 把 Doris 作为外部数据源(区别于主数据源)时,用不同的 API 实现了「推」跟「不推」,以及「此推」跟「彼推」的区别。
在前面几期的实测中发现,通过 Flink 的 Doris connector ,主要实现的是条件查询时,「不推」跟条件受限的「推」,而通过 Doris 的 jdbc 接口,则可以实现任意查询条件的「下推」自由。
本来以为上面得出的结论可以尘埃落定了,但上一篇文章发出之后,又有个同学留言说,利用 Flink 的 Doris connector(Flink SQL API) 配合 lookup join 也可以实现跟 Doris jdbc 一样的点查询(下推)功能。

看到这,我又来劲了,于是决定亲自一试。
0. 什么是 lookup join
请原谅我的土,我是第一次知道还有这么个 join 方式(主要是之前没用过),于是赶紧去补了下关于这方面的知识点。
网上劈哩叭啦一通扫盲后发现,这个 lookup 最早是来源于 Excel 对数据的一种处理方式,而这个 lookup join 则出现最多的,是 Flink 的一种根据数据源种类不同,进行关联操作的一种类别划分。
啥意思?
我们知道,对于 flink 来说,各种乱八七糟的 join,那老多了,除了传统的根据关联方式的不同,可以分为 inner join、left join、right join、full outer join 之外。
它还可以根据数据源性质的不同,在此之上,又定义了诸如regular join、interval join、temporal join、lookup join 等等。
你看,本来挺简单一件事,被它这么一整,估计很多人就懵逼了。
对于 Flink 的其他 join,我们先晾一边,今天只单独拿 lookup join 说事,从官网的介绍,以及网上各种资料拼凑出的信息来看,它更像是一个「主数据」,跟另一个「静态的外部数据」之间产生关联的 join 方式。
而这,好像很符合我当前的测试场景,至于这个 Flink 的 lookup join 到底能不能解决我的问题,我们一起来看看。
1. lookup join 对主数据的要求
看了眼之前我模拟的主数据源,再瞅了瞅官网 Flink 对 lookup join 的要求,多少有点尴尬。

Flink 要求,想要实现 lookup join,你得具备「主数据有个处理时间字段,且这个字段还必须得是 TIMESTAMP 类型」。
而且根据官方文档的要求,这个 TIMESTAMP 类型的「处理时间」,一般是需要在「CREATE TABLE」语句中定义的,比如像这样:
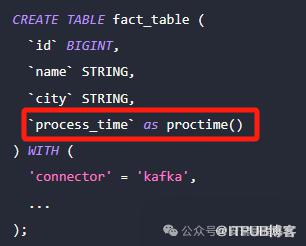
Doris 官网给的示例
但很显然,我当前造出来的几条主数据,多少有点上不了台面,满足不了这样的要求。
咋整?
别急,常规方法不行,骚操作的途径,那还不有的是,我是这么干的,既然原数据不能在建表的时候,包含这个符合要求的「处理时间」,那么我在执行查询的时候,用相同的函数生成一个,是不是也可以。

经过我的实践,你别说,它真可以。
2. lookup join 对 Doris 的要求
既然作为主数据,想要实现 lookup join,Flink 要求其必须有「处理时间」,那么作为被 join 的 Doris,自然也有对应的要求。
啥要求?
那就是在用 Flink SQL 映射 Doris 表的时候,必须加上「jdbc-url」这项配置(如果像之前那样映射整张表的数据,是不需要加的)。

否则,人家就会报错提醒你。

看到这里,再结合之前的实测文章,不知道你有没有发现一个问题?
那就是,想要实现根据查询条件的「精确下推」,对于一般数据库来说,还得靠 JDBC。
3. 测试代码跟结果
本次测试的需求,是看我造的那几条主数据中的 IP,分别在 Doris 表里有多少条记录,然后把结果打印出来。
package com.anryg.mysql.jdbc

import org.apache.flink.api.common.RuntimeExecutionMode
import org.apache.flink.api.common.restartstrategy.RestartStrategies
import org.apache.flink.streaming.api.scala.StreamExecutionEnvironment
import org.apache.flink.table.api.bridge.scala.StreamTableEnvironment

/**
  * @DESC: 利用Flink SQL 的 lookup join 实现对 Doris 的点查
  * @Auther: Anryg
  * @Date: 2024/7/31 20:29
  */
object FlinkSQLLookupJoin {

    def main(args: Array[String]): Unit = {
        val env = StreamExecutionEnvironment.getExecutionEnvironment
        env.setRestartStrategy(RestartStrategies.noRestart())

        env.setRuntimeMode(RuntimeExecutionMode.BATCH)/**因为数据有界,用batch模式*/
        val tableEnv = StreamTableEnvironment.create(env)

        import org.apache.flink.streaming.api.scala._

        /**模拟生成主数据,实际可以是任何数据源,比如Kafka等*/
        val mainDS = env.fromCollection(Seq(
            (1,"221.198.68.4"),
            (2, "192.168.100.1"),
            (3, "110.22.68.4"),
            (4, "172.64.33.195"),
            (5, "20.242.68.3"),
            (6, "1.2.3.99")
        ))

        /**将主数据映射成表t1*/
        val mainTable = tableEnv.fromDataStream(mainDS).as("id","ip")
        tableEnv.createTemporaryView("t1", mainTable)

        /**将Doris外部数据源映射成表t2*/
        tableEnv.executeSql(
            """
               |CREATE TABLE t2 (
               |`client_ip` STRING,
               |domain STRING,
               |`time` STRING,
               |target_ip STRING,
               |rcode INT,
               |query_type INT,
               |authority_record STRING,
               |add_msg STRING,
               |dns_ip STRING
               |)
               |    WITH (
               |      'connector' = 'doris',
               |      'fenodes' = '192.168.221.173:8030',
               |      'table.identifier' = 'example_db.dns_logs_from_kafka',
               |       'jdbc-url' = 'jdbc:mysql://192.168.221.173:9030',
               |      'username' = 'root',
               |      'password' = '****',
               |     'sink.label-prefix' = 'label_001'
               |)
            """.stripMargin)

        /**执行最后的查询统计操作,并打印结果*/
        tableEnv.executeSql(
            """
              |select
              |ip,
              |SUM(case when domain is null then 0 else 1 END) as cnt
              |from
              |(
              |select
              |a.ip,
              |b.domain
              |from
              |(
              |select
              |ip,
              |PROCTIME() AS proctime
              |from
              |t1
              |) AS a
              |left join
              |t2 FOR SYSTEM_TIME AS OF a.proctime  AS b
              |on a.ip = b.target_ip
              |)
              |group by
              |ip
            """.stripMargin).print()
    }
}
跑完之后,得到的结果如下:

符合预期,而且效率很高,说明当前方案,实打实的「推」了(如果不推,这张几亿数据的 Doris 表,且得跑一会呢)。
最后
通过实测,这个 Flink SQL 的「lookup join」确实可以实现,根据主数据作为查询条件的「下推」功能,或者说「点查询」功能。
打破了之前我对 Flink SQL 只能映射全表,需要把全表数据都拽到进程后,才能开展条件查询的刻板印象。
但是,相比以往的普通表映射,Flink 想要实现 「lookup join」,对主数据提出了基于「处理时间」的要求,而对外部数据 Doris 的点查询,也必须是通过 jdbc 的方式来访问。
至于「lookup join」的优缺点,跟之前用 Flink DataStream API 配合 Doris JDBC 的方案一样,优点是:可以根据每一条主数据作为查询条件,实现对 Doris 的「精准下推」,IO 量小,每次查询的效率高。
而缺点是:如果主数据的数据量大,且 Flink 设置并行度过高,就会导致 Doris 需要承受过高的 qps 压力。
当然,相比之前用的 Flink DataStream API,当前的 Flink SQL 「lookup join」方案,编码要更加简单一点。
最后,对于 Flink SQL 的「lookup join」方案,你觉得怎么样?

原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

