前两篇文章结合了一个具体案例,展开聊了下 Flink 读取 Doris 时「推」跟「不推」的具体表现,以及编码区别。
经过实测,当时得出的结论是:通过 Flink SQL 利用 flink-doris-connector 读取 Doris 表数据时,不能对其执行条件下推动作,只能将整张表数据全部先「拽」到进程中,然后再根据条件进行过滤。
文章发出去后,有 2 个同学留言说,这种情况下,其实也可以实现「查询下推」功能,还热心给我贴上了相关的文章链接。
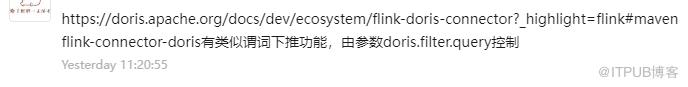
我顺着这个链接一查,哟吼,还真是耶,在用 Flink SQL 映射 Doris 表的时候,确实可以通过下面这个参数,来控制需要条件的数据。

我研究了下这个参数,也实测了,确实可以根据参数「doris.filter.query」,来添加数据过滤条件以达到「查询下推」的目的。
但是,尴尬的地方在于,目前这种在表映射时添加的「条件下推」设置,根本解决不了我上篇文章中,根据每一条主数据作为查询条件,以此来对 Doris 做「点查询」的场景。
至于为什么解决不了?下面咱们稍微展开来说说。
1. 关于「doris.filter.query」的用法
从 Doris 的官网介绍来看,在我们用 Flink SQL 读取 Doris 表时,除了最基础的可以映射整张表的数据外,还可以通过在「with」属性中,添加对这张表的过滤条件。
比如像下面这样:

但这里需要注意的,对于这个过滤条件(where 条件)来说,比如「where target_ip = "221.198.68.4"」在添加到这个过滤配置时,如果条件字段(target_ip)是个字符串类型,一定要记得像图中红框框那样,对这个双引号添加转义字符,虽然这是个小问题,但估计很多同学会犯。
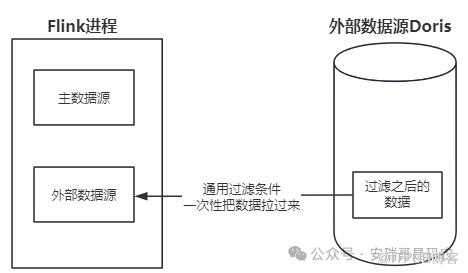
对于「doris.filter.query」来说,它解决的是如下图所示的「下推」问题:
2. 为什么 「doris.filter.query」搞不定
仔细读过上两篇文章的同学应该知道,我面临的场景是,通过 Flink 读取主数据源时,每读到一条主数据,就需要根据这条主数据作为 where 条件,向 Doris 表发起查询请求。
这是一个典型的,根据主数据内容,向外部数据源发起「点查询」的应用场景。
来看下面这个图,你应该就能完全懂了。
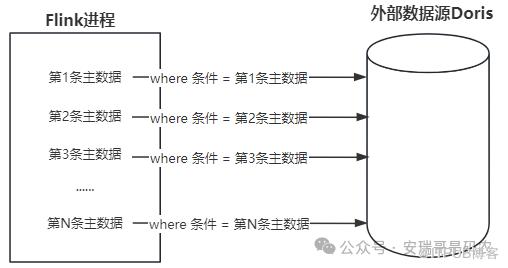
而「doris.filter.query」能解决的,只能是通过「一个确定的」过滤条件,「一次性」把符合业务需要的数据,给都拉到 Flink 进程里。
但是,当前场景需要的这个过滤条件,它并不是一成不变的,就跟开盲盒一样,只有当计算程序在不断地往下推进时,才能知道每一条主数据长什么样,然后,根据它的样子,去 Doris 查询目标对象。
最后
从这个案例可以说明,当我们在利用分布式计算引擎(Spark 或者 Flink),对外部数据源进行条件查询时,除了「推」与「不推」的区别之外,还存在「此推」跟「彼推」的不同。
希望通过最近的这几篇文章,让你能对「查询下推」这个概念,能有更加深入的理解。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

