上篇文章对比了 Flink 读取 Doris 数据库,实现同一个数据统计功能时,用的两种不同连接方式,带来的编码以及原理和效率之间的差异。
用 Flink SQL 借助 flink-doris-connector 对 Doris 进行读取,映射的是整张表,也就是只能把所有数据先给「拽」过来,然后用 Flink 支持的 SQL 逻辑对数据进行操作。
而用 Flink 借助 Mysql jdbc 来读取 Doris 的方案,虽然编码复杂一点(DataStream API),但在数据查询上,会更加聪明,能够有效做到查询条件「下推」。
在之前的历史文章中聊过,Spark 读取外部数据源的 4 种方案中,对外部数据源的管理方式,也可以分为类似的两大类。
一类是不用管理数据源的连接问题,对比 flink-doris-connector 的解决方案;而另一类,则是需要考虑数据源的连接问题,类比 Doris 的 jdbc 方案。
那么对于 Flink 需要考虑数据源连接问题的方案来说,它在具体的实现过程中,跟 Spark 有哪些相似,跟不同之处呢?
这篇文章,我们就来聊一聊。
0. 代码解读
还记得上篇文章中,通过 Flink 借助 Mysql jdbc 来读取 Doris 的方案中,关于它连接部分的代码实现吗?
new RichMapFunction[(Int, String), (String, Long)] {
            var connection:Connection = null
            val url = "jdbc:mysql://192.168.221.173:9030/example_db?useUnicode=true&characterEncoding=utf8&useTimezone=true&serverTimezone=Asia/Shanghai&useSSL=false&allowPublicKeyRetrieval=true"

            /**创建jdbc连接*/
            override def open(parameters: Configuration): Unit = { /**创建连接的个数,根据线程数量来*/
                Class.forName("com.mysql.cj.jdbc.Driver")
                connection = DriverManager.getConnection(url, "root", "****")
            }

            /**对每一条主数据挨个处理*/
            override def map(value: (Int, String)): (String, Long) = {
                val ip = value._2
                val ps = connection.prepareStatement("select count(*) as count from dns_logs_from_kafka where target_ip = ?")
                ps.setString(1,ip)
                val result = ps.executeQuery()
                var count = 0L
                while (result.next()){
                    count = result.getLong("count")
                }
                (ip,count)
            }

            /**任务完成,关闭连接,如果是流任务则不要关*/
            override def close(): Unit = {
                if (!connection.isClosed || connection != null) connection.close()
            }
        }
就是在 map 函数内部,再次实现这个「RichMapFunction」类。
至于为什么需要这么做?我们先来看 map 这个函数,对于输入的要求是什么样的。
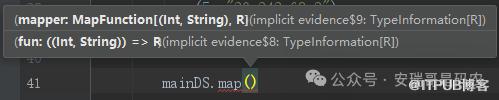
从提示来看,要么输入一个 lamda 表达式,要么输入一个 MapFunction 的实现类。
至于这里为什么没有选择更为灵活的 lamda 表达式?
原因很简单, lamda 表达式虽然更灵活,但也正因为过于灵活,只规定了输入数据,跟输出数据的类型,其他所有跟数据处理相关的逻辑,都必须我们自己一个个来实现,缺少了一种规范性的约束力,导致编码过程会更复杂(之前的 Spark 就是这么干的)。
而 RichMapFunction 的实现类,虽然是一个抽象类(比 MapFunction 稍微具体一丢丢 ),但它对数据处理过程中会出现的一些通用性步骤,是做出了约束规范的。
比如一般情况下,我认为用得最多的是这3个函数:

map 函数
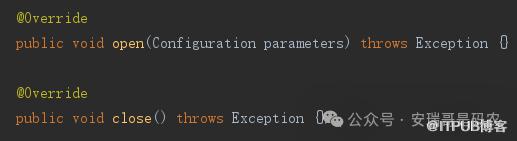
open 跟 close 函数
通过阅读源码的相关解释,以及我的亲自验证,发现它们有下面几个特点。
对于 map 函数来说:
这个函数的实现,就跟一开始,我们最初用 map(注意这两个 map 的区别) 中的 lamda 表达式是一样的。
只不过这个 map ,只需要你在其中,实现对业务数据「纯粹」的计算逻辑,它的调用频率是「一条业务数据,调用一次」。
对于 open 函数来说:
这个函数,从名字命名来看,你就基本可以猜出它的用意,open 函数会在 map 函数的逻辑被调用之前调用,而且「只会调用一次」。
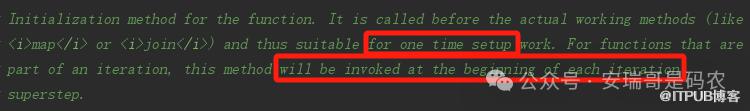
对 open 函数的源码解释
类似对数据处理之前的 pre-step 操作,一般可以用来创建数据库连接,初始化某个对象等。
对于 close 函数来说:
理解了 open 函数的意义,这个 close 自然就好理解了,它的核心目的,就是用来给前面 open 的操作檫屁股的,比如关闭 open 阶段打开的数据库连接,或者销毁之前创建的某个对象等,是一个典型的 post-step 操作。
1. 运行验证分析
Flink 的这个 「RichMapFunction」之所以这么受欢迎(我看到好多同学在编码时都用了),核心原因在于,它给你的编码,节省了很多思考跟设计的时间,在某种程度上,避免了一些差劲代码发生的概率(比如糟糕的连接管理问题)。
从实践上来看,如果我们把数据库的连接部分逻辑,放到 open 函数实现里,写起来是可以非常简单的(如上),这里既不用考虑「连接单例」,也不用思考要不要用「线程池」。
从上面实现的代码来看,好像没什么技术含量,几乎没有用到任何高大上的高级功能,但是,它就是能满足你的数据库连接需求。
从实测表现来看,这个 open 建立的数据库连接数量,跟当前运行 Flink 任务的「线程数量」保持一致。
比如当前 Flink 任务设置的计算总并行度为 2,那么它向 Doris 数据库创建的连接个数就为 2,如果为 N,连接数量就为 N,非常的准。
别问我怎么知道的,因为我亲自测试验证过了。
(至于相关内容的截图,先欠着,有机会下次直播给大家演示。)
2. 对比 Spark
细心的同学可能已经发现了,Flink 的「RichMapFunction」提供了天然的,对外部数据源的管理规范,而相比较 Spark 来说,同样的 map 函数,却并没有提供这样的便利。
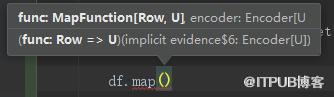
Spark 的 map 算子提供的输入要求
虽然从输入提示来看,好像跟上面 Flink 的输入要求很像,貌似也可以用这种富函数的思路来解决问题。
但是,当我想去找到一个跟 Flink 的「RichMapFunction」类似功能的类时,你会发现,Spark 根本就没有提供,这也是为什么,前面文章中关于 Spark 对数据库连接的管理,想要达到一样的效果(数据库的连接个数,跟线程数保持一致),我用的「ThreadLocal」。
在面对这种比较复杂的数据处理场景时,从框架能够提供的丰富性选择上来说,这一点,Spark 不如 Flink。
最后
在用分布式计算引擎对外部数据源进行读写时,关于它的连接管理,是一个我们始终都绕不开的话题。
作为一个合格的大数据码农,会利用框架带来的便利当然是件好事,但如果你还能搞清楚它背后的原理、不同框架的优缺点,那就再好不过了。
这样一来,面试的时候,就又多了一个跟面试官吹牛逼的筹码不是。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

