前面用4篇文章,聊了 Spark 如何引入外部数据源 Redis 的4种不同玩法。
那么接下来,咱们把角色一变, Spark 换成 Flink,同时也把 Redis 换成 Doris,同样来看看,在面对类似的场景时,这两者之间,能碰撞出什么样的火花出来。
0. 抛个问题
假如有这样一个场景,主数据是一批 IP 地址(可能在任何数据存储系统,比如Kafka),然后 Doris 数据库里面,存储有跟 IP 地址相关的其他信息(具体是啥,不用关心)。
计算的要求是,查询出这个主数据的每一条 IP 地址(ip字段),对应的,在 Doris 数据库表中(target_ip字段),有多少条对应的记录。

主数据
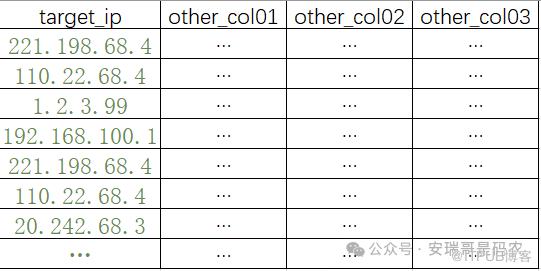
外部 Doris 数据
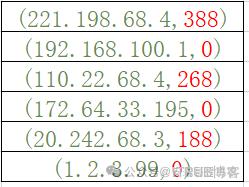
要求计算结果
但是,这个 Doris 中对应的表,比较大,有好几亿条数据,如果在计算的时候,把整张表的内容都读到进程里,除了占用内存不说,效率还低。
但如果是针对每一条要查询的 IP,通过查询动作,给「下推」到 Doris 端,然后 Doris 返回查询结果,那样效率就会高很多。
接下来,我们来对比一下,用两种不同的处理方式,看他们分别在执行效率,以及编码上面的优劣。
1. 解决方案一
也是我认为编码最简单的方案,利用 Flink 的 SQL(Table) API,编码如下:
package com.anryg.mysql.jdbc

import org.apache.flink.api.common.RuntimeExecutionMode
import org.apache.flink.streaming.api.scala.StreamExecutionEnvironment
import org.apache.flink.table.api.bridge.scala.StreamTableEnvironment

/**
  * @DESC: 利用 Flink SQL API 引入 Doris 外部数据源
  * @Auther: Anryg
  * @Date: 2024/7/16 17:37
  */
object FlinkSQLReadDoris {

    def main(args: Array[String]): Unit = {
        val env = StreamExecutionEnvironment.getExecutionEnvironment

        env.setRuntimeMode(RuntimeExecutionMode.BATCH)
        val tableEnv = StreamTableEnvironment.create(env)

        import org.apache.flink.streaming.api.scala._  //引入隐式转换函数

        /**模拟生成主数据,实际可以是任何数据源,比如Kafka等*/
        val mainDS = env.fromCollection(Seq(
            (1,"221.198.68.4"),
            (2, "192.168.100.1"),
            (3, "110.22.68.4"),
            (4, "172.64.33.195"),
            (5, "20.242.68.3"),
            (6, "1.2.3.99")
        ))

        /**将主数据映射成t1表*/
        val mainTable = tableEnv.fromDataStream(mainDS).as("id","ip")
        tableEnv.createTemporaryView("t1", mainTable)

        /**将Doris外部数据源映射成表t2*/
        tableEnv.executeSql(
            """
               |CREATE TABLE t2 (
               |`client_ip` STRING,
               |domain STRING,
               |`time` STRING,
               |target_ip STRING,
               |rcode INT,
               |query_type INT,
               |authority_record STRING,
               |add_msg STRING,
               |dns_ip STRING
               |)
               |    WITH (
               |      'connector' = 'doris',
               |      'fenodes' = '192.168.221.173:8030',
               |      'table.identifier' = 'example_db.test02',
               |      'username' = 'root',
               |      'password' = '***',
               |     'sink.label-prefix' = 'label_001'  //导入标签前缀
               |)
            """.stripMargin)

        /**用Flink SQL 对t1,t2进行关联得出结果*/
        tableEnv.executeSql(
            """
              |select t1.ip,
              |case when
              |t3.cnt is null then 0
              |else
              |t3.cnt
              |end as cnt
              |from
              |t1
              |left join
              |(
              |select target_ip,count(*) as cnt from t2 where target_ip in (select ip from t1) group by target_ip
              |) as t3
              |on t1.ip = t3.target_ip
            """.stripMargin).print()
    }
}
由于 Flink 提供了对 Doris 现成的 SQL API
所以对于它的编码,用 SQL 来写显得效率格外高。
但是,它的缺点也非常明显,那就是上面提到的,对于当前的数据处理场景来说,执行效率非常低。
原因在于,当前映射的这张 Doris 表,必须将所有的数据全部都要加载到进程里,没有办法根据查询条件,执行有效的「下推」操作,好家伙,好几亿条数据,不慢才怪。
而且,如果你是在本地执行,默认内存设置情况下,压根就跑不出来,关键它抛出的异常,根本就不会告诉你是因为数据量过大导致的。
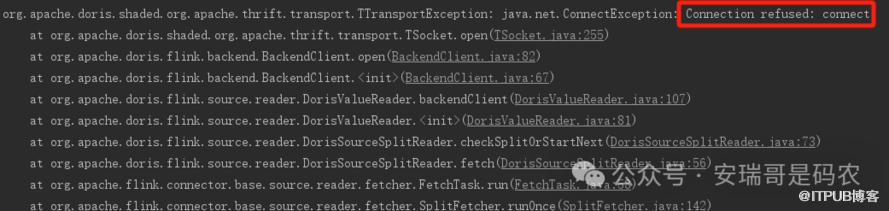
而事实上,当你把这张 Doris 的大表,给换成一张小的,它就可以跑出来了,很讨厌。
2. 解决方案二
既然上面这种方式不行,那咱就换一种思路,上面的编码方式不能让查询「下推」,那就改为支持下推的。
用原始的 JDBC 方式读取 Doris,只不过这一次,只能用 DataStream API。
package com.anryg.mysql.jdbc

import java.sql.{Connection, DriverManager}

import org.apache.flink.api.common.RuntimeExecutionMode
import org.apache.flink.api.common.functions.RichMapFunction
import org.apache.flink.configuration.Configuration
import org.apache.flink.streaming.api.scala.StreamExecutionEnvironment

/**
  * @DESC: 测试 Flink 在处理主数据的时候,用JDBC方式额外引入 Doris 数据源
  * @Auther: Anryg
  * @Date: 2024/7/16 11:06
  */
object FlinkDSReadDoris {

    def main(args: Array[String]): Unit = {
        val env = StreamExecutionEnvironment.getExecutionEnvironment
        env.setRuntimeMode(RuntimeExecutionMode.BATCH)

        import org.apache.flink.streaming.api.scala._  //引入隐式转换函数

        /**模拟生成主数据,实际可以是任何数据源,比如Kafka等*/
        val mainDS = env.fromCollection(Seq(
            (1,"221.198.68.4"),
            (2, "192.168.100.1"),
            (3, "110.22.68.4"),
            (4, "172.64.33.195"),
            (5, "20.242.68.3"),
            (6, "1.2.3.99")))

        /**利用富函数*/
        mainDS.map(new RichMapFunction[(Int, String), (String, Long)] {
            var connection:Connection = null
            val url = "jdbc:mysql://192.168.221.173:9030/example_db?useUnicode=true&characterEncoding=utf8&useTimezone=true&serverTimezone=Asia/Shanghai&useSSL=false&allowPublicKeyRetrieval=true"

            /**创建jdbc连接*/
            override def open(parameters: Configuration): Unit = {
                Class.forName("com.mysql.cj.jdbc.Driver")
                connection = DriverManager.getConnection(url, "root", "***")
            }

            /**对每一条主数据挨个处理*/
            override def map(value: (Int, String)): (String, Long) = {
                val ip = value._2
                val ps = connection.prepareStatement("select count(*) as count from dns_logs_from_kafka where target_ip = ?")
                ps.setString(1, ip)
                val result = ps.executeQuery()
                var count = 0L
                while (result.next()){
                    count = result.getLong("count")
                }

                (ip, count)
            }

            /**任务完成,关闭连接,如果是流任务则不要关*/
            override def close(): Unit = {
                if (!connection.isClosed || connection != null) connection.close()
            }

        }).print()

        env.execute() //启动任务按钮
    }
}
很明显,这次的编码方式要更复杂一点,这里主要需要注意的是,对 Doris 的连接管理问题(关于这一点,后面文章会展开聊)。
当然,对应的,这里需要你引入 JDBC 的包。
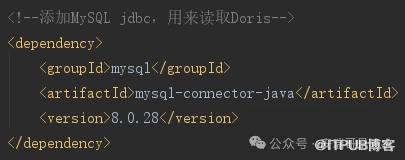
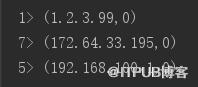
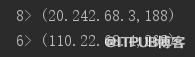
这种方式最明显的优点是,执行效率高,因为用的 JDBC,所以它自带「查询下推」属性,不用傻了吧唧把所有表数据都薅出来。
所以很快,这个结果就跑出来了,就在本地,不用额外设置任何参数。
最后
这次测试用的两种 Flink 读取外部 Doris 数据源的方案,应该是我们在平时都会用到的,而且你会发现,类似的方案,在前面的 Spark 读取外部数据源文章中,也出现过。
从对比效果来看,方案一很明显要更「费IO」以及「费内存」,效率低不说,而且如果运行的资源参数设置过小,很容易嗝屁。
而方案二虽然编码复杂一些,但对数据的处理逻辑则「更聪明」,不会去浪费没有必要的 IO 跟内存空间,所以效率更高,且更节省资源。
那么你平时在工作中,主要用的哪种呢?
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

