从这两周文章内容中透露出的执着,你应该可以看出来,我要把「Spark 如何引入外部数据源」的各种可行方案都尝试一遍,对,看着有点像闲得蛋疼。
就在我以为过去的 3 篇文章,已经能够概括当下所有主流的,用 Spark 引入外部数据源的玩法时,猛然发现:咦?好像还有一种方案捏。
通过 Spark 同时读取主数据,以及 Redis 黑名单数据,然后将其映射成两张表,最后通过 Spark SQL 取交集,得出最终结果。
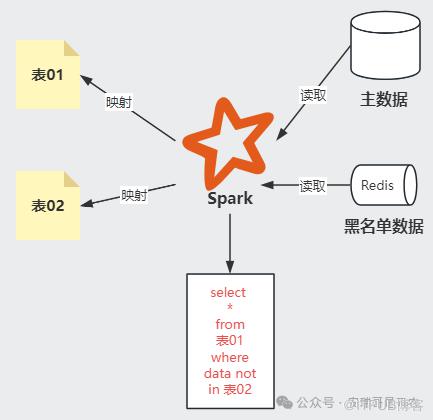
只不过呢,这种方式对我来说,确实不怎么常用,还记得当时写这个系列的第一篇文章时,我还信心满满的说,不能用多表关联的方式来解决这个问题,但没想到打脸来得这么快,看来还是自己学艺不精。
0. Spark 直接读取 Redis
之前说过,但凡是个能叫上名字的数据源,Spark 几乎都可以找到对其进行读、写的 API,而对于存储有黑名单数据的 Redis,当然也不例外。
但是呢,Spark 读写 Redis 的 API,目前来看,Spark 官网并没有直接提供(我反正暂时没有搜到),而是 GitHub 上开源的一个插件。
叫做 RedisLabs,从 start 数来看,好像流行度还可以。
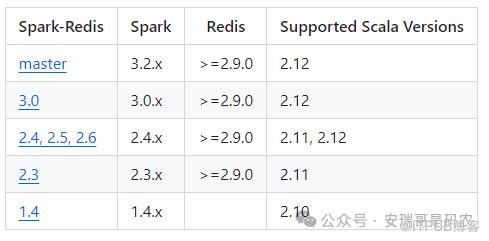
而从其中的描述来看,跟 Spark 的 兼容程度也还可以。
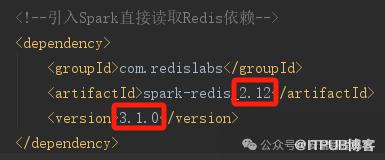
而且,它对应的 spark-redis 包,不需要你非得把这个项目 down 下来编译后才能用,Maven 中央仓库本身就提供了最新的,直接下载就行。
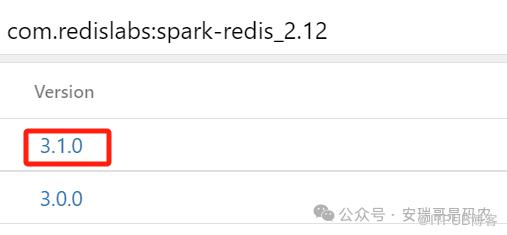
由于我当前的 Spark 版本为 3.2.0,Scala 语言版本为 2.12,Redis 版本为 5.x,所以这里按理说应该下载它的 3.1.0 版本(有坑,往下看)。
1. 上代码
根据 GitHub 上给的示例,再结合我的实际情况,写出了下面的代码:
package com.anryg.bigdata.test.variable

import org.apache.log4j.{Level, Logger}
import org.apache.spark.SparkConf
import org.apache.spark.sql.SparkSession

/**
  * @DESC: 测试用 Spark 直接读取外部数据源跟主数据取交集
  * @Auther: Anryg
  * @Date: 2024/7/11 17:36
  */
object SparkReadExternalDataTest03 {

    def main(args: Array[String]): Unit = {
        Logger.getLogger("org.apache.spark").setLevel(Level.WARN)
        val sparkConf = new SparkConf().setAppName("SparkReadExternalDataTest01")
            .setMaster("local[*]")

        /**设置Redis的连接参数*/
        sparkConf.set("spark.redis.host","192.168.211.106")
            .set("spark.redis.port","6379")
            .set("spark.redis.db","5")
            .set("spark.redis.auth","****")
        val spark = SparkSession.builder().config(sparkConf).getOrCreate()

        /**构造数据源(主数据)*/
        val seq = Seq("baidu.com",
            "qq.com",
            "xiaomi.com",
            "12345.com",
            "abc.com",
            "def.net",
            "xxx.com",
            "google.com",
            "sina.com",
            "163.com",
            "yyy.net",
            "360.com",
            "cctv.cn",
            "12306.com")

        import spark.implicits._

        /**主数据生成DF*/
        val mainDF = spark.createDataset(seq).toDF("domain")
        /**映射成t1表*/
        mainDF.createOrReplaceTempView("t1")

        /**引入必要的函数*/
        import com.redislabs.provider.redis._
        /**通过Spark直接获取黑名单数据*/
        val blackDF = spark.sparkContext.fromRedisSet("black_domain").toDF("domain")
        /**映射成t2表*/
        blackDF.createOrReplaceTempView("t2")

        /**将主数据表t1,跟黑名单数据表t2取交集*/
        spark.sql(
            """
              |SELECT
              |domain
              |FROM
              |t1
              |WHERE
              |domain not in
              |(SELECT * FROM t2)
            """.stripMargin).foreach(println(_))
    }
}
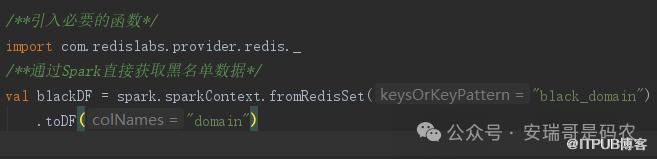
值得注意的是,由于黑名单数据是放在 Redis 的 Set 数据结构里的,观察了下这个包提供的 API,好像只有先通过 RDD 的方式将数据读进来,然后再转成 DataFrame。
2. 有坑
你以为代码写完,就能轻松跑起来了吗?哼!怎么可能?
2.1 什么坑
本地IDEA启动,运行。哦豁,报错了!

看上去,是个典型的 jar 包冲突问题。
一查,这个类属于 「jedis」包的,确实可疑,因为当前工程的环境里,刚引入的 spark-redis 包,里面含有 jedis,而之前也单独引入过一个 jedis 包(之前文章创建Redis连接用的),所以当前环境有两个版本的 jedis。
所以想着,把之前引入的 jedis 版本,换成跟当 spark-redis 里面包含的 jedis 版本一致,或者直接把之前的 jedis 排除掉。
但是,你猜怎么着?他娘的仍然抛这个“函数找不到”的异常。
最关键的是,我把各个版本的 jedis 包中,这个类都打开看了,根本就没有它要的这个函数,你说它是不是有病?
2.2 怎么解决
幸亏咱世面见得足够多,猜测大概率是当前引入的这个 spark-redis 版本有 bug 导致。
于是果断把当前的 3.1.0,给降级成了 3.0.0。

果然不出所料,它跑出来了。
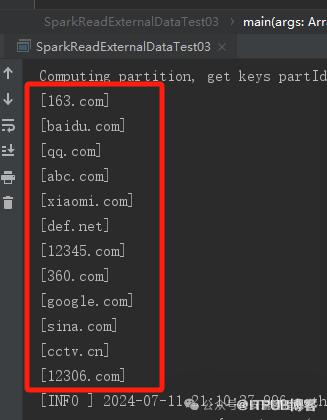
当然,结果也没有毛病,2个黑名单顺利给过滤掉了。
说明什么?说明即便是官方文档,有时候也可能跟放屁一样不严谨,关键是你要会辨别。
3. 我不喜欢的地方
虽说从 GitHub 找的这个 spark-redis 包(或者插件),确实解决了我当前黑名单引入的问题。
但是,它的局限性也很明显。
3.1 配置具备侵入性
从代码中你应该也发现了这一点,对于 Redis 的配置,它必须这么来写。
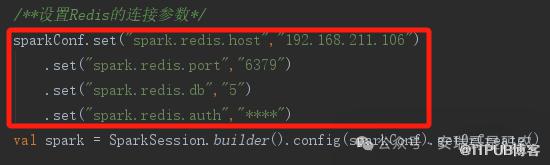
也就是说,它必须配置在 SparkSession 对象内部。
发现问题了吗?
如果我想在当前代码里,再引入另一个数据源,而这个数据源的引入方式,如果也恰好跟当前一样,必须在 SparkSession 对象内部设置数据源的配置,那就得配置两个 SparkSession 对象。
3.2 给工程带来额外的依赖负担
一般而言,如果一个软件工程中用到了 Redis,正常情况下,都会有额外的,专门操作 Redis 的工具类(比如CRUD),而这部分,大概率是用 Jedis 来实现的。
也就是说,你当前工程中,原本是不缺跟 Redis 交互,读取这个黑名单数据的解决方案的。
既然这样,你还要引入一个额外的 Redis 操作包,这样势必会给当前的软件工程,带来一些除了 jar 包臃肿之外的不确定因素,比如最常见的 jar 包冲突问题。
3.3 不能解决数据结构复杂的碰撞问题
当前方案最大的特点,是一次性把 Redis 的数据全给读取出来(某个key的),然后通过 Spark SQL 在 SQL 语法上进行过滤。
但是,如果我存在 Redis 中的数据结构,不是当前案例中的 Set,而是 ZSet,我每次碰撞的时候,需要用到 Redis 自带的范围查找函数,这个时候,这种方式就失效了。
关于这种情况的具体案例,记得之前文章讲过,有兴趣的同学可以往前找找看。
最后
虽然用当前方法,也是 Spark 引入外部 Redis 数据源的一种解决方案,它最大的优点,是不用我们担心它的“Redis 连接”问题。
至于缺点,上面已经提到过了,如果是你,会选这种方案吗?
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

