前言
今天团队一小伙伴火急火燎告诉我,他提交的一个spark任务怎么着都跑不起来,一启动就报错,明明同样的代码几天前还运行好好的,怎么今天就【失灵】了呢?因为我当时在忙其他事情,所以让他先找找原因,他检查了半天,没有找到,只把代码逻辑前后检查了一遍又一遍后确认他代码没有问题,再次找到我,把【锅】成功甩给了我。
那我哪能忍,于是吭哧吭哧把原因找到后,然后又一顿噼里啪啦操作,把问题给解决了,成功获得了他的【大拇指】。

01
—
问题表现
用spark-submit在spark客户端机器通过命令行端提交job之后,任务一直处于ACCEPT的状态,然后一会就直接退出了。
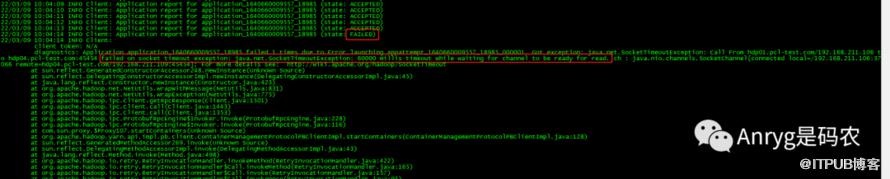
从客户端提交的console端日志反映的直观信息来看,就是跟集群中的某个机器进行通信时超时,然后就退出了,其实并没有什么有效信息。
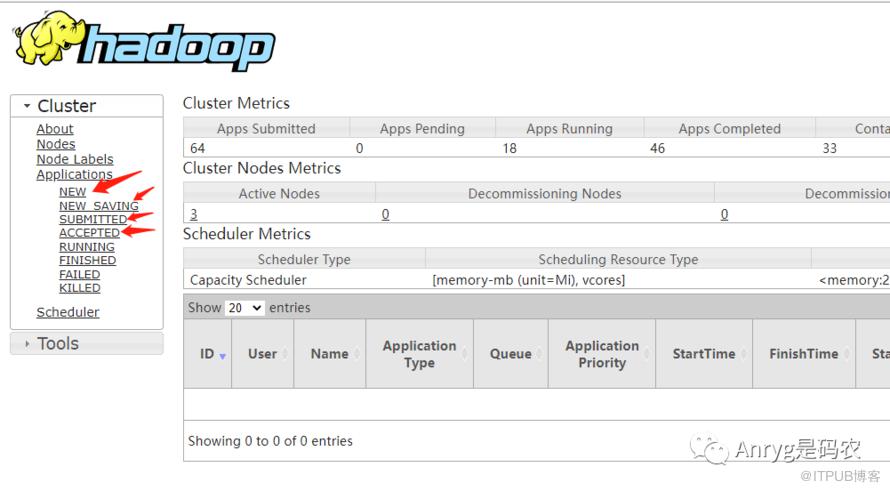
然后再看YARN记录的日志信息,看有没有什么新的发现:

02
—
问题定位

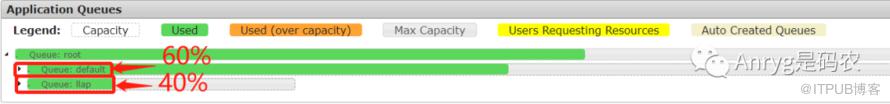
可以看到当前YARN配置了2个队列,其中default队列资源占比为60%,而另一个llap队列资源占比为40%,当前提交的队列因为没有指定具体用哪个队列,因此默认使用的是default队列。而通过检查发现,该队列在这个任务提交前期资源就已经占用了58%,剩下2%的资源已经不够这个任务运行的需要,才导致了这个小伙伴的任务提交一直失败。
到这里,问题定位成功。
03
—
问题解决
既然定位到问题了,那解决起来就简单多了,要么扩大这个队列的资源,要么等待其他任务运行完,等资源释放再提交。
因为考虑到这个任务的紧急性,以及另一个队列llap的资源确实分配的有点多了,于是决定调整这两个队列的资源配额比例,将原本default的60%改为80%,而原本的llap从40%改为20%(注意所有队列的资源总和加起来必须小于等于100%)。
具体改法如下,找到YARN的配置文件的scheduler选项(我这里因为是用Ambari来管理,因此可以直接通过页面来修改,如果是其他方式管理配置文件,改法类似),

另外,我这个YARN用的是capacity scheduler,如果你的集群用的其他scheduler,配置也是类似的。
最后refresh一下你的scheduler就可以了,注意只用refresh,不需要重启你的YARN服务。
再次提交任务,发现可以正常运行了。
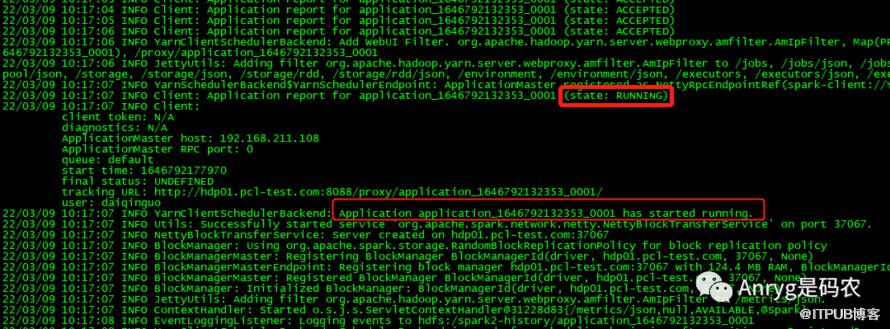
问题解决...
04
—
想起前段时间的一个坑
yarn.scheduler.capacity.maximum-am-resource-percent结语
——
实际工作中我们会遇到非常多这样的问题,在遇到类似表面没有头绪的问题时,一定不要慌张,自乱阵脚,或者干脆甩锅,撇清责任,解决问题才是根本。
用你的强逻辑能力去分析,从【道】的高度来对问题进行拆解,然后从【术】的层面对其进行解决。其实今天这个问题一点都不难,你只需要稍微沉下心来分析一下,就很容易找到问题。
共勉...
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

