前言
前两天有个同学跟我私聊,说他们的Redis在某个应用场景下存了太多的key-value数据,目前为止已经累计了16G,说是否可以优化一下。询问得知他们的value用的是最简单的string数据类型。对于很多使用Redis的人来说,如果数据量较小,鉴于内存查询的优势,你怎么设计你的数据存储类型都没有问题,不同的底层数据存储结构带来的效率差异并不明显。但是如果数据量越来越大了,像这个同学描述的这样情况,你的Redis不再像以前那般【岁月静好】,这个时候对底层数据结构的重新思考就【迫在眉睫】。
Redis数据结构简介
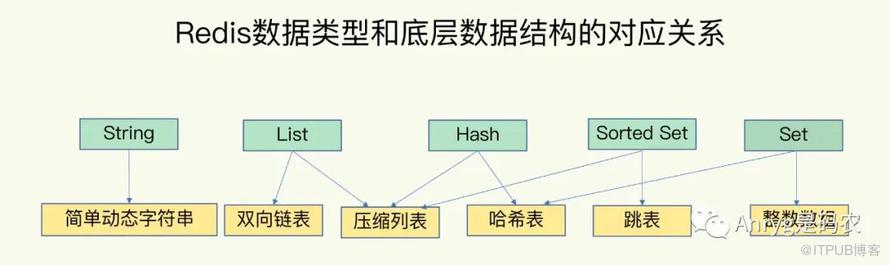
我们知道Redis是一个key-value型的数据库,里面存的所有数据都是k-v结构,对于key来说,都是统一的string类型,而value则可以有5种类型可供选择:
- sorted set,对应数据结构为:压缩列表和skiplist(跳表);

Redis之所以提供这么多value的数据类型和对应的不同数据结构,目的就是为了满足不同场景下对数据存储的要求。
问题描述
这位同学在Redis中存的key-value数据中key为粉丝的用户id,而value则是该粉丝关注的大V的用户id,其中用户id是一个10位数的整数。
key: 1101000123value: 9901000341
这里value选择的类型就是最简单的string类型,这样就表示系统有多少个粉丝,Redis就必须有多少个key-value对。这也是非常多同学在使用Redis时使用的存储方式,因为这种方式无论是在数据写入还是读取时都最简单、方便。
但是随着Redis中数据写入的不断增多,这种存储的弊端就会逐渐显现出来:
存储空间增长很快,占用大量内存;
数据的读写速度变慢;
存储空间变大
随着这种key-value数据持续不断写入Redis后,其存储空间也会呈现线性的增长,原因主要有2:
- 因为是用key-value这种结构进行存储,key没有任何复用的部分,而我们知道对于一个10位数值的用户id而言,不同用户之间一定存在相同的部分(比如身份证号,前面部分很多人都相同),这部分没有利用起来;
-
对于value来说,因为采用的string的数据类型,其对应的数据结构为动态可变字符串,这个数据结构的特点是:除了存储数据本身外,它还存储了其他的元数据信息;
先来看看简单动态字符串(Simple Dynamic String,SDS)的数据结构:
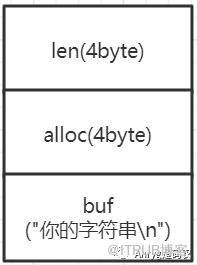
SDS数据结构
可以看到,这个结构除了存储自身数据(buf)外,还存储了这个对象占用的长度,分配的内存信息,需要额外的8byte空间来存储。
你以为这样就完了吗?为了直观看到这种存储方式带来的内存消耗,我们来验证一下,写入1条这种key-value的数据看看空间占用情况:
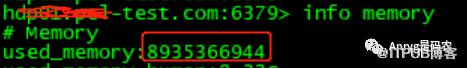
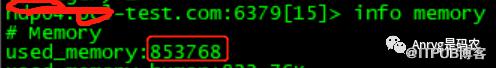
写入前内存大小
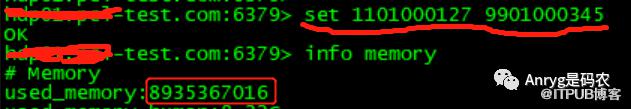
可以看到写入这条数据之后,Redis的内存增长了72byte,比刚在那个SDS本身远远要大。那么这空间占用都去哪了呢?
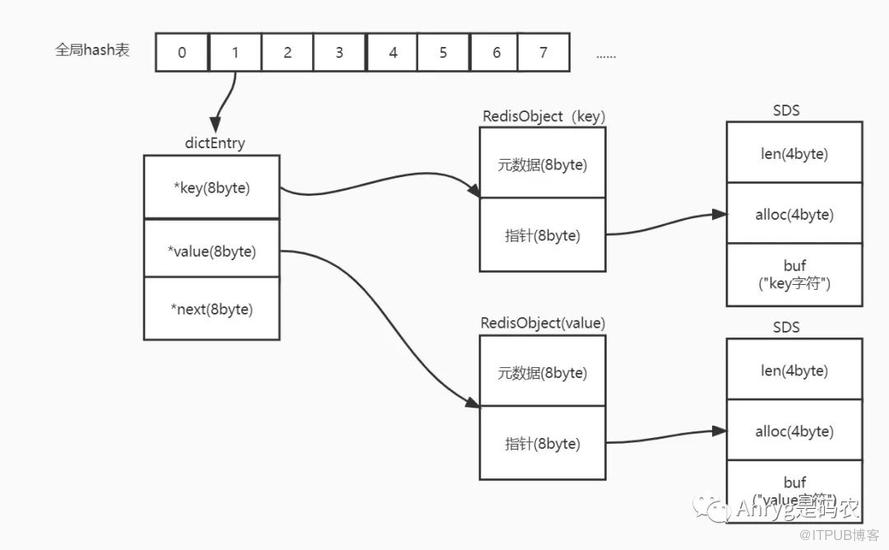
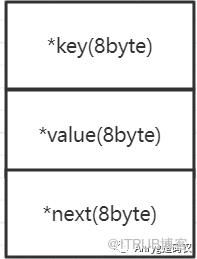
我们从全局来看下,写入的这个key-value,占用了多大空间? 首先,我们要知道,在Redis的每个实例中,都维护了1张(实际上是2张)全局hash表,用来保存所有的key-value的指针,以方便我们在根据某个key进行查找时,以O(1)的时间复杂度找到其对应的值,而这个hash表中的对象也叫dictEntry,其结构如图:

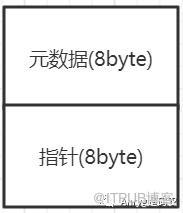
其次,无论是我们key-value中的key还是value,其实都是封装在一个叫RedisObject的对象中,而这个RedisObject对象的组成如下图所示:

最后,我们从全局的视角来看看一个key-value的内存占用情况:

可以看到,虽然我们只写入了一个简单的key-value,但是其内存中增加的对象,可远没有我们想象的那么简单,这也可以解释为什么那位同学的Redis数据很快占用那么大内存的原因(因为每个key-value就占了72byte)。读写效率变低
随着数据写入量的增大,其写入和查询效率也会变低,原因有如下2点:
- 随着key的不断增多,Redis的全局hash表中的空缺就会越来越少,这样带来一个问题就是出现越来越多的【hash碰撞】,遇到hash碰撞时,就只能通过链式hash来解决这个问题,即一个全局hash桶中同时保存多个dictEntry,这也是为什么上文中你看到dictEntry结构中有一个next指针的原因,随着碰撞的加剧,这个链式hash对象也会越来越多,而在同一个hash桶中的这些dictEntry是用单向链表来连接的,因此在同一个桶中其查询时间复杂度就变成了O(n);
- 随着数据量逐渐的增大,每一次的日志归档效率也会越来越低,而我们知道日志归档是需要Redis的【主工作进程】fork出子进程来完成的,随着数据量的增大这个fork的效率也会越来越低,而这就直接影响了主工作进程,而又因为Redis的工作进程是单线程的,所以Redis的读写效率变低也就不难理解了。
优化建议
既然已经存储了这么多数据量了,那怎么做可以让原本的存储空间节省一些,从而进一步改善原本的读写效率呢? 上文提到,Redis的value有5种数据类型,其对应6种数据结构,而在这6种数据结构中,能够有效减少存储空间的就是【压缩列表】这种数据结构,那么我们就应该想办法把这种数据结构给用上,而从上文的图中可以看出,想用这种数据结构,对应的value的数据类型就必须得是【hash】或者【sorted set】或者【list】这3种,这里我们以hash(最合适)为例子来做说明。
key是一个10位数字的整数,而value也同样是一个10位数字的整数,怎么把它改为用hash的方式存储呢?
还是拿key为1101000123,value为9901000341举例,上文分析到,作为一个用户的id,其数值的组成一定是遵循一定的业务规则的,比如key中的前7位1101000可能存在一定的重复度,那么我们完全可以利用这一点,把这部分共性给抽取出来。 根据这一点,我们就可以把这个数据优化成:key=1101000,value为一个hash对象,而这个hash对象的key为123,hash的value为9901000341。于是在向Redis写这个数据时,我们的写入就变成了这样:
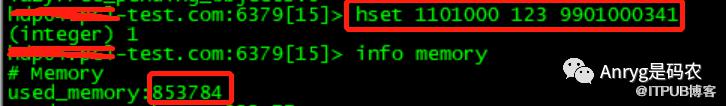
hset 1101000 123 9901000341


可以看到内存仅仅增加了16byte,比之前的72byte节省了整整56byte的空间,只有不到原来的1/4,从结果看,这个优化是非常成功的。 但是这里面需要注意一点,就是hash这种数据类型是对应了2种底层数据结构的,压缩列表只是其中一种,当你hash对象的元素个数或者单个元素大小超过某个阈值的话,会直接将压缩列表转变成为hash表,这两个控制的参数如下:hash-max-ziplist-entrieshash-max-ziplist-value
第2个指的是你的hash对象元素中,某个元素的最大长度阈值; 这两个参数一旦有一个超过阈值,则压缩列表会变成hash表,而hash表则没有了压缩功能。
但是压缩列表也不是哪哪都好,压缩列表本质上也是一个数组的数据结构,因此其查询时间复杂度为O(n),所以不建议你设置的元素过多,否则虽然空间节省了,但是查询效率变低了,这里需要你根据实际场景做出取舍。
结语
——
在使用任何存储软件时,一定不要以为软件本身足够优秀就放弃了对存储过程的设计和对原理的掌握。共勉...
因公众号无法留言,如果你觉得我讲的还凑合,欢迎找我交流探讨...

原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。