前言
继上一篇讲到一个优化Redis存储空间的案例,给出了一个具体的优化建议,这种优化方案虽然能大幅减少数据的在内存占用的开销,但也多少有点【亡羊补牢】的味道。倘若我们在将数据写入Redis前就大概能估算,根据业务要求,我要写入的数据量会占用多大的内存,是不是可以在一定程度上避免这种因为前期缺少对数据量的预估,而导致后期你的Redis不堪重负的境况呢?我相信很多人(包括以前的我)在往Redis写数据之前,都没有事先去估算即将要写入的数据会占用多大的内存空间的习惯。而是一股脑的往里写,写完后用对应的api去查,如果效率OK就不会考虑优化的事情,直到你的Redis逐渐慢了下来,才会回过头去思考所谓的优化。
为了尽量减少这种【后知后觉】带来的挽救成本,这里给大家介绍一个Redis官方推荐的估算Redis数据结构占用内存大小的工具,不用花钱,不用注册,打开即用,工具地址为:http://www.redis.cn/redis_memory/。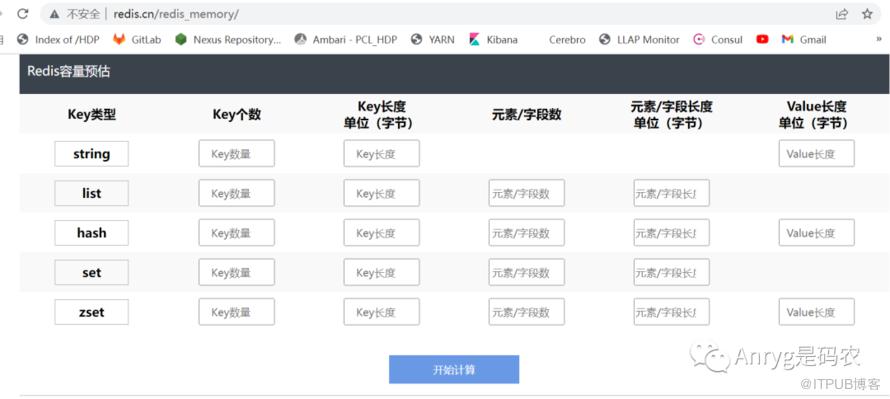
这里支持Redis所有的数据结构,但因为是估算,单位只能以MB来计,如果想估算单条key-value的大小,目前这种方式是用不了的。
来,还是以上篇文章的案例来做示范:
key: 1101000123value: 9901000341
当我们将value以string方式写入时,以1百万条为例,看占用的Redis内存存储空间为多大:
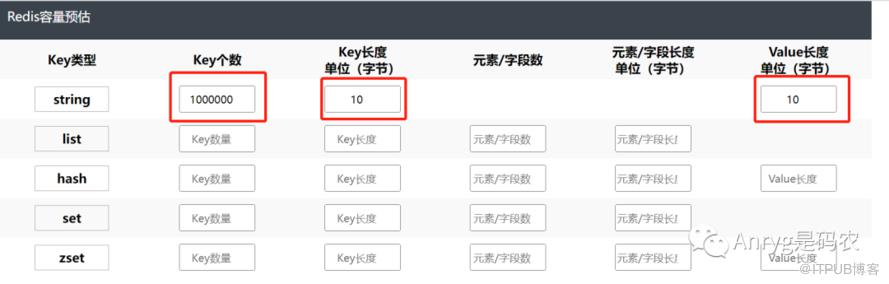
在算出其占用的内存大小之前,我们用传统思维来先估算下其大小应该是多大。可以看到,这个k-v中,无论是k还是v其实都可以用一个long类型的整数来表示,也就是说,在我们理解的传统数据类型中,这个k-v应该就占用16byte(一个long类型占用8byte)就够了,那1百万个这样的k-v,算下来也就不到16MB才对,但是你猜,如果选择用string类型来存储v,在Redis中会占用多少内存?点击开始计算,得出这1000000条k-v占用的大小:

可以看到,占用了约97.27MB的内存空间,远大于我们上面估计的16MB,这个充分说明,Redis的数据存储结构远比我们实际理解的要复杂(详情可以参考上一篇文章)。 很明显上面这种存储类型比较耗内存,上篇文章中我提到用hash这个数据结构来存储,空间可以节省很多,我们同样来看下如果1百万这样的k-v转换成为hash,会占用多大内存空间:
假设这1百万条k-v中,k的前3位都是公共部分,后7位是变化部分,那么前3位就是这个hash对象的key,而后7位作为这个hash对象的1百万个元素中,每一个的元素的key。类似:110 1000123 9901000341
我们来看下他们占用的内存大小是什么样的?
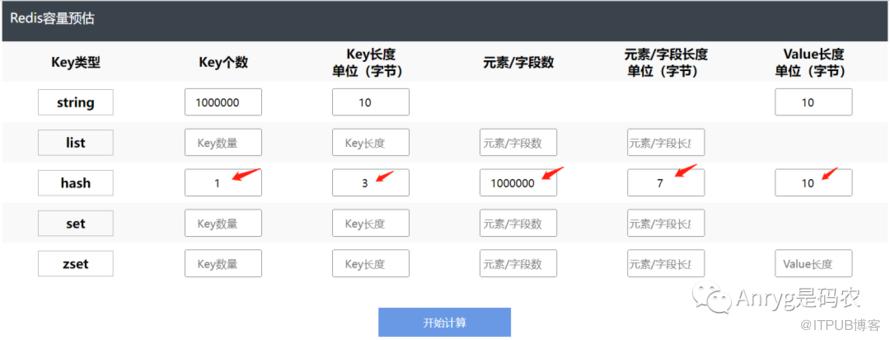
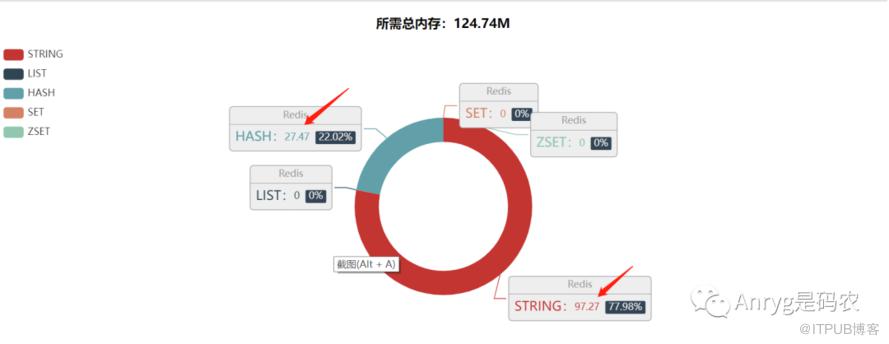
从估算的结果来看,约占27.47MB,大概是之前string类型的约1/4,跟上篇文章中估算的相差不大。
同时我也用这1百万个k-v分别用list、set、zset(sorted set)来存储,分别来看下他们占用的内存是多大:
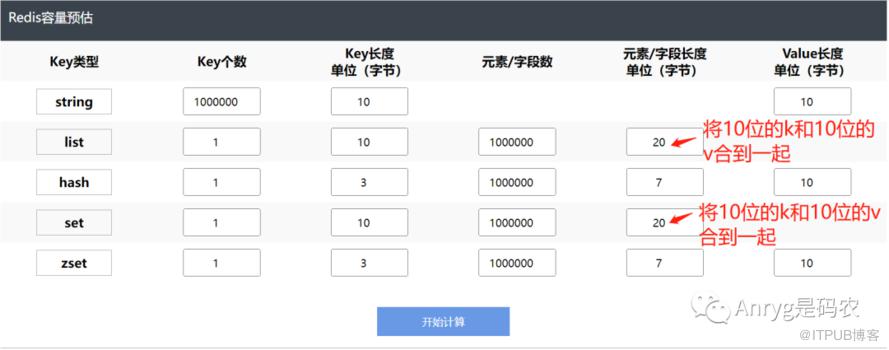
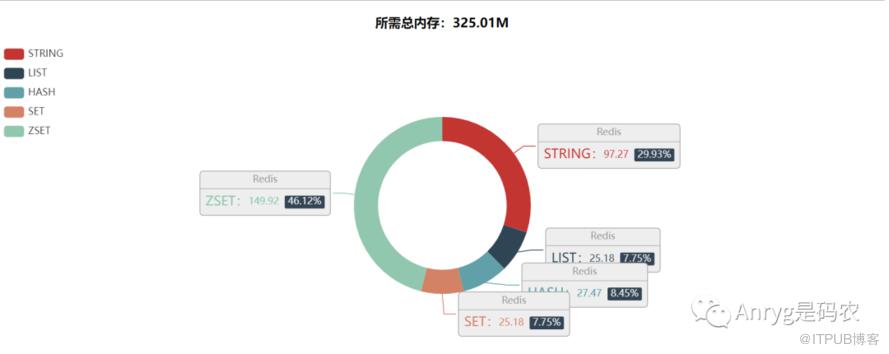
我们从内存占用从大到小,来依次分析下各个数据类型的特点:
Zset(sorted set)类型:因为其数据可以按照你的某个业务规则进行顺序存储,且支持范围查询,是一种skip list的数据结构,其数据查询的时间复杂度为O(logN),效率非常高。因为有比较复杂的索引结构,所以其内存占用也是最大的;
String类型:最简单、易用的数据类型,不需要投入过多精力进行数据结构设计,但是内存消耗也非常高,过多的key很容易造成Redis全局哈希表的【hash碰撞】问题,导致Redis变慢,虽然简单,但跟其缺点相比,是非常【不划算】的一种数据类型,如果数据量过大,要慎重选择;
Hash类型:是这个例子中【最划算】的存储方式,存储空间占用少,而且查询效率也非常高(如果底层是hash表,时间复杂度为O(1)),兼顾了空间和效率的平衡;
List与Set类型:都是集合类型,这里看到存储空间一样,是因为这个工具把他们的底层存储看成了【数组】的结构,优点是一个key可以存储大量的value,节省了额外的key的空间,缺点是value因为是数组,如果value数量很大,其查询的时间复杂度会很高,为O(N);
结语
——
这篇文章作为上一篇的补充,主要是想告诉你,在使用一个存储工具或者数据库时,如果能够提前预估我们要写入的数据占用多大空间,以此反过来指导我们的存储方式,让我们对存储结构有个更加深入的理解,就可以避免很多因为前期【功课不足】而导致的后期【手忙脚乱】。共勉...
因公众号无法留言,如果你觉得我讲的还凑合或者有任何问题,欢迎找我交流探讨...

原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

