上周在技术讨论群里有同学问到一个关于MySQL的查询语句中,其查询条件有没有走索引,走哪些索引的问题,这里面考察的知识点就是索引的最左原则问题,这是各大公司为了考察候选人数据库基础,出现的一道高频面试题。虽然是基础,但是每次类似考题一旦出现,对于那些基础不牢的同学,基本可以说是[哀鸿遍野],各种蹩脚的回答更是不计其数。之前的文章说过,任何存储系统,当你在考虑如何将数据存储前,一定要想清楚你后续要如何使用该数据,否则,你的存储将不会有实际的意义。对于数据库来说,[索引]就是用来实现这件事情的具体手段,[索引]即是个动词,同时也是个名词。
作为名词,它指的是一种特定的数据结构;作为动词,它指的是将数据写入这个数据结构的过程。所以,这里斗胆给索引下一个我理解的定义:索引的本质就是将数据按照特定业务规则,进行排序的过程。
原因也很好理解,试想,如果你的数据只管写入,不去考虑上一条跟下一条之间的逻辑关系,那么就没有必要用数据库了,直接写文件系统就好了。而且写入效率会非常的高,因为写入过程都是顺序的,不需要考虑任何数据之间的逻辑关系。但是你这样写入虽然效率高,那么查询时候的效率也会低的吓人,因为没有制订写入规则,数据没有按照业务规则排序,你就只能挨个数据去查找比对,直到找到为止,会导致数据的全量IO,时间复杂度O(N)。在说最左原则之前,还是有必要简单说下MySQL根据一般索引的查找方式是什么样的。如下图,就是一棵小型的B+树,可以看到图中蓝色部分为索引(非叶子节点),而绿色部分为实际数据,也叫叶子节点。之所以这么叫,因为它看起来像一棵倒过来的树形状。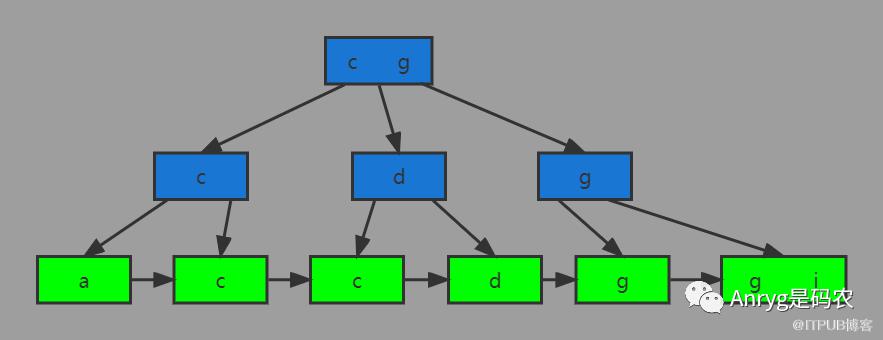
但是这棵树的数据写入过程中是经过了严格排序的,即在每个节点内部,数据大小都是从左到右依次递增的,且每个节点对应的左边子节点一定是小于等于自己的,而右边子节点也一定是大于等于自己的数据。比如我要查找数据a,从顶层节点开始找,发现a比c小,那么目标数据一定在c的左边子节点,可以看到此时c的左边子节点依然是c,继续跟目标a比较,因为a比c要小,所以目标数据一定在当前c节点的左子节点位置,此时定位到c的左子节点正好是数据a,查找完成。再比如找数据i,也是一样的逻辑,i大于顶层的数据g,于是找g的右子节点,发现依然是g,继续查找其右子节点,发现右子节点的第2个数据就是i,查找完成。根据这个规律,找到目标数据的时间复杂度就为O(logN)。但是如果这个时候,这棵树中的数据变成了2个字母的组合,比如下图这个样子: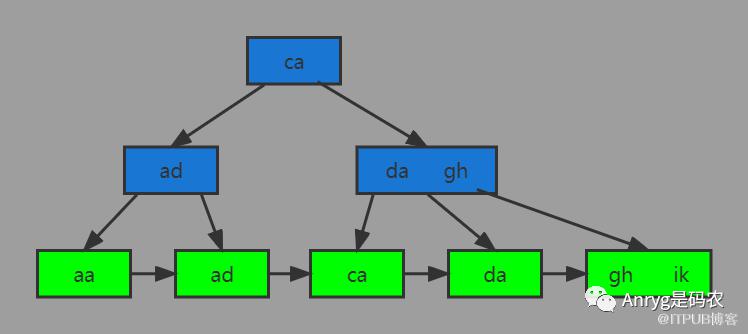
此时,假如我要查找字符中第二个字母为d的目标数据(对应查询语句的like '%d'),该怎么办呢?按照刚才的查找逻辑,我们看顶层点中数据的第2个字符为a,而d大于a,于是我们会去其右子节点查找,然后发现这个节点的两个数据的第二个字符中,一个比d小(da的a),另一个比d大(gh的h),于是定位到最终的数据da,你会发现,咦... 不对!找到的数据根本就不是我需要的目标数据。
你会发现这个时候,如果用刚才这种方式对数据进行查找的话,原本的排序策略失效了,即索引失效。想要找到目标数据,就只能老老实实把所有的数据都给读出来,然后逐一比对第二个字符是否为目标字符。而这种查找方式在MySQL的查找语法中,就叫模糊匹配,对应的SQL为:select ... from ... where data like '%d'
通过这种方式查找数据,虽然已经对数据建立了索引(数据排序),但是查找过程中索引却无法发挥作用,会引起全表扫描。那是不是意味着只要是模糊匹配就一定会导致索引失效呢?select ... from ... where data like 'a%'
来看下查找顺序,还是根据之前用过的查找规则,因为这个时候是查找第一个字符为a的数据,那么还是先看顶层节点,发现其数据的第一个字符为c,而a比c要小,于是目标数据只可能在其左子节点中,此时发现,其左子节点数据的第一个字符为a,跟目标字符一样,那么根据B+树的数据排序规则(左子节点小于等于当前节点,右子节点大于等于当前节点),其左子节点和右子节点都有可能是目标数据,于是分别找到左右子节点,发现其第一个字符都为a,于是都符合要求,查找完成。看到上面这些查找方式之后,你有没有发现一个问题,那就是对于已经索引的数据来说,你的查找条件必须是以[左]为基准,否则你将无法使用索引带给你的[便利]。而这种必须以[左]为查找基准的原则,就叫:最左原则。
刚才上面只是从数据查找的角度进行分析,下面我从MySQL的实际数据表中来验证下刚在说的。
create table t1
(
ID int primary key AUTO_INCREMENT,
str varchar(3) NOT NULL,
index k(str)
)
engine=InnoDB;
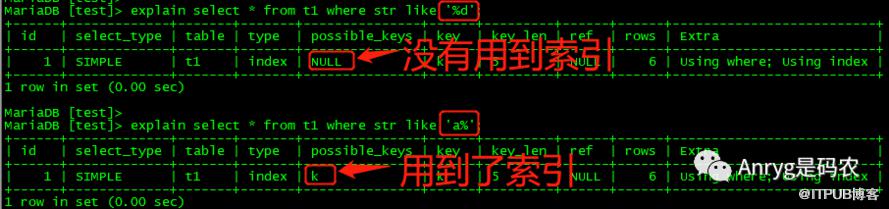
可以看到,第一个查询条件'%d'的是没有用到索引的,而第二个查询因为遵循了[最左原则],走了索引,跟上面分析的结论一样。但是,第一个查询可以看到在上面的Extra一栏里显示: Using where,using index又是怎么回事呢?意思是:这个查询通过where条件,虽然没有有效用到索引这个数据结构带来的便利,但是还是通过索引这棵树来找到目标数据的。
我们通常意义上说的查询条件有没有走索引,其实是在说当前的条件有没有用到索引这个数据结构的便利特性,以此快速定位到目标数据,并不是指没有在索引这棵树上进行数据查找,假如是通过索引这棵树扫描了所有数据,那么就认为当前查询条件没有走索引。
以上是一个字段的情况,假如我们多几个字段,用组合索引来看看,是否也适用这一条件:
create table t2
(
ID int primary key AUTO_INCREMENT,
str1 varchar(3) NOT NULL,
str2 varchar(3) NOT NULL,
str3 varchar(3) NOT NULL,
index combin_key(str1,str2,str3)
)
engine=InnoDB;
其中,字段str1,str2,str3组成联合索引combin_key,往其中写入些数据后,我们再来通过不同的查询条件来看看,不同查询语句对索引的利用情况:

可以看到,通过这种严格执行最左原则的查询条件,在组合条件(str1,str2,str3)中,每一个子索引条件都用到了,目前这个查询条件是当前索引利用率最高的方式,没有之一。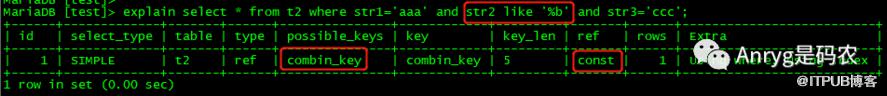
发现当str2的查询条件用模糊匹配后,且对单个str2的子索引来说,也不满足最左原则,这个时候,查询优化器明确只用到了一个子索引的高效查询能力(即走索引),即子索引str1,因为str1与str3之间的连接是通配符'%b',而这个%可以是任意字符,那么对MySQL的执行器来说,它就只能去匹配可能的所有内容,因此这部分是要走[全表扫描]的。
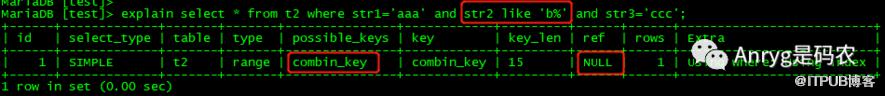
当把str2的查询条件改为:'b%'之后,发现ref这一栏的内容为null,虽然用到了联合索引的便利查找功能,但是不确定用到了哪几个子索引的功能,但是这里我们可以根据之前的推理,得出用到了str1、str2的子索引功能,因为此时的条件str2满足自己的最左原则。
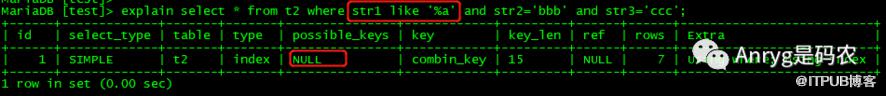
很显然,只要联合索引的最左字段str1本身不符合最左原则,那么整个联合索引是完全没有办法利用索引的[查询便利性]的。对于最左原则,考察的最多的是在组合索引的情况下,因为在这种情况下,大家最容易犯错误。记住核心的一点:最左原则可以是联合索引的最左n个字段,也可以是字符串索引的最左m个字符。
因公众号无法留言,如果你觉得我讲的还凑合或者有任何疑问,欢迎找我交流探讨...
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。