前言
-XX:+UseCompressedClassPointers //压缩类指针
-XX:+UseCompressedOops  //压缩普通对象指针
-XX:+UseCompressedClassPointers:表示是否启用类指针压缩,因为对于任何一个jvm中的对象而言,其内部都有一个指向自己对应类(属于哪个class)的指针(Java习惯叫引用),在64位的Java虚拟机中,默认是启动压缩的;
-XX:+UseCompressedOops:表示是否使用普通对象指针压缩,Oops是Ordinary object pointers的缩写,就是任何指向一个在堆中的对象(非简单类型)的指针,默认也是启动压缩的。
01
—
为什么要压缩指针
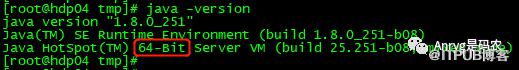
跟操作系统一样,我们先看下一个常用的JVM的规格:
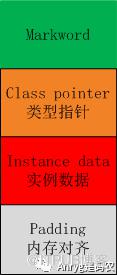
Markword:对象头,用来标记对象状态的,比如hascode、锁状态信息等;
Class pointer:类型指针,用来指向方法区(method area)中该对象属于哪个类,比如A对象指向A.class;
Instance data:实例数据,指的是对象中的成员变量,如果是简单类型,则直接存对象本身,如果是非简单类型,则保存对象的指针(引用);
Padding:内存对齐,对于64位Java虚拟机来说,对象为8字节(64bit)对齐,如果对象大小不满8字节的倍数,则通过该部分进行补齐,比如对象时间大小只有12Byte,则需要补齐到16Byte,这样做最大的好处在于寻址效率高(知道为什么数组可以用下标直接读取数据吗?就是因为每个对象大小一样且挨在一起)。
接下来,看这么个例子:
public class A {
    private Object object = new Object();

    public static void main(String[] args) {
        //打印出对象的内存布局
        System.out.println(ClassLayout.parseInstance(new A()).toPrintable());
    }
}
注意,这里除了依赖JDK本身外,还需要依赖一个第3方jar包,用来专门查看对象的内存布局情况。
<dependency>
    <groupId>org.openjdk.jol</groupId>
    <artifactId>jol-core</artifactId>
    <version>0.13</version>
</dependency>
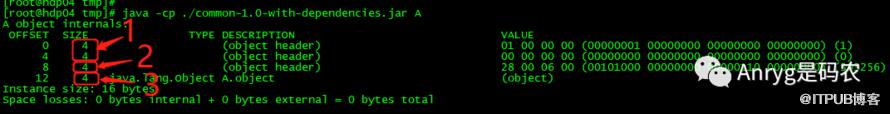

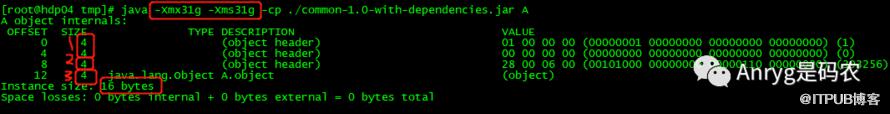
用这个命令就可以看到,JVM自动给你设置了5个额外的参数,包括最小heap大小,和最大heap大小,GC方式,以及2个指针压缩的选项。
就是这2个默认的指针压缩配置,导致了上面我们打印一个对象时,其成员变量在内存布局中的指针只有4byte。
我们来验证一下:
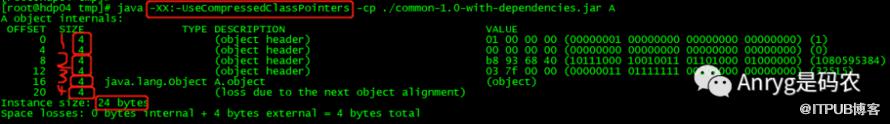
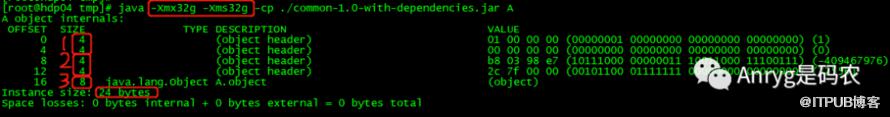
1,先关闭掉类压缩指针,关闭参数为:-XX:-UseCompressedClassPointers,意思是不启用类指针压缩:
关闭类指针压缩
可以看到,其内存布局由之前的3部分,变成了现在的4部分,第2部分的类指针由原来的4byte变成了现在的8byte,因为我把类指针压缩给关闭了。
那为什么多出来个第4部分呢,原因也很简单,上面说了,在64位JVM中任何一个对象的大小必须满足8byte对齐,即8byte的整数倍,如果不满足就用要额外的空间来填充,上面3部分加起来只有20byte,不满足8的倍数,因此需要额外再加4byte到24byte,刚好8的3倍。
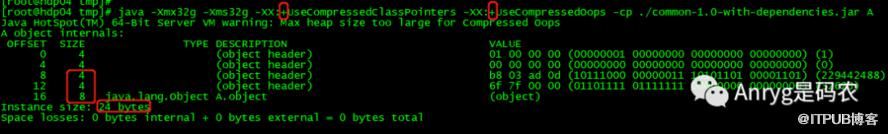
2,再来验证下普通对象指针,把压缩功能给关闭了(-XX:-UseCompressedOops),会是个什么情况:

再关闭普通对象指针压缩
可以看到,第3部分的普通对象指针已经从原来的4byte变成了8byte,而因为这3部分的大小加起来刚好是8byte的3倍,因此不需要额外的padding,也就没有了刚才第4部分。
这2步就证明了之前的推论。
至于为什么要这么做,原因也很简单,因为计算机的内存资源向来都是硬件资源中最昂贵的资源之一,如果有手段将原本占用内存太大的部分进行有效合理的减少,那当然是一件值得庆幸的事情。
02
—
指针压缩支持的内存范围
结语
——
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

