<dependency>
    <groupId>org.apache.spark</groupId>
    <artifactId>spark-core_2.11</artifactId><!--提供SparkContext对象-->
    <version>2.3.2</version>
</dependency>
<dependency>
    <groupId>org.apache.spark</groupId>
    <artifactId>spark-sql_2.11</artifactId><!--提供SparkSession对象-->
    <version>2.3.2</version>
</dependency>
<dependency>
    <groupId>org.apache.spark</groupId>
    <artifactId>spark-hive_2.11</artifactId><!--提供spark连接hive-->
    <version>2.3.2</version>
</dependency>object Spark2ConnectHive3 {
def main(args: Array[String]): Unit = {
val conf = new SparkConf().setMaster("local")
conf.setAppName("connect_hive")
val sparkSession = SparkSession.builder().config(conf)
.enableHiveSupport()
.getOrCreate()
val result = sparkSession.sql("select * from doi_data limit 2")
result.show()
sparkSession.close()
sparkSession.stop()
}
}
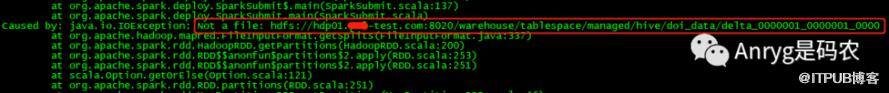


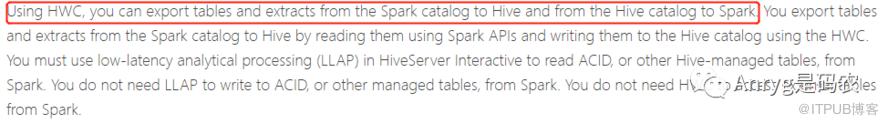

<dependency>
    <groupId>com.hortonworks</groupId><!--nexus私服自定义jar-->
    <artifactId>spark2-hive3-connector</artifactId>
    <version>1.0.0</version>
</dependency>object Spark2ConnectHive3 {
def main(args: Array[String]): Unit = {
val conf = new SparkConf()
conf.setAppName("connect_hive")
val sparkSession = SparkSession.builder().config(conf)
.enableHiveSupport()
.getOrCreate()
//val result = sparkSession.sql("select * from doi_data limit 2")
val hive = HiveWarehouseSession.session(sparkSession).build()//获取HWC对象
val result = hive.executeQuery("select * from doi_data limit 2")//查询hive表数据
result.show()
sparkSession.close()
sparkSession.stop()
}
}
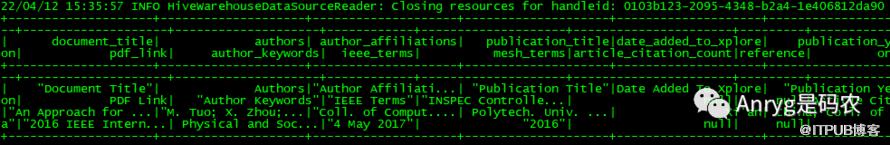
为什么这里是提交到集群,因为在本地运行的话,会报一堆缺少依赖包而导致的各种报错,这也是这个版本的坑之一。
可以看到,现在已经能够正常跟hive进行通信了。
另外,在文档中其实还要求hive中的表必须满足ACID特性,才能用这种方式进行操作,只不过hive3的ACID特性默认开启,所谓的ACID属性,主要指下面几个配置:
hive.strict.managed.tables=true
hive.create.as.insert.only=true
metastore.create.as.acid=true
因为hive3默认已经打开,暂时不需要你做额外操作。
我看网上有文章说用非ACID的表也可以解决该问题,我亲自论证了一下,是不行的,如果不用HWC,即便你用到一种没有ACID属性的表,直接spark读取hive是行不通的,不信,你可以验证一下。
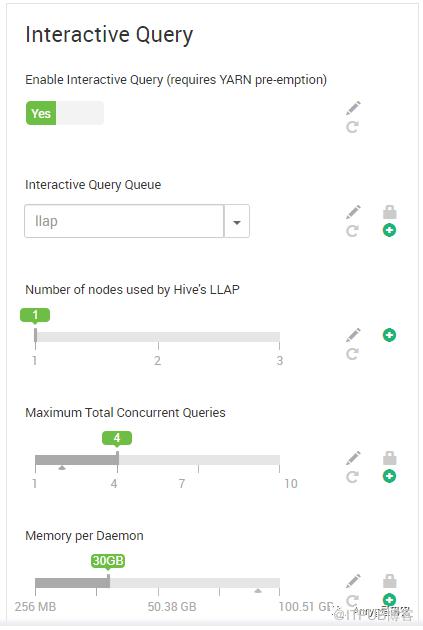
必须启用llap功能,而llap必须要启动若干个守护进程,对集群资源有一定的侵占性;
需要额外引入HWC的jar包,用hwc提供的api对hive进行操作,但是经过我们一段时间的使用,不是特别好用,不时出现一些莫名其妙的bug,典型的如:无法在本地ieda环境直接运行代码,必须要提交到集群环境;还有就是通过该方式写数据到hive分区表的时候,明明已经制定好了分区字段,但是总能出现少许出乎意料的分区(已经确认不是数据问题),如下图所示:
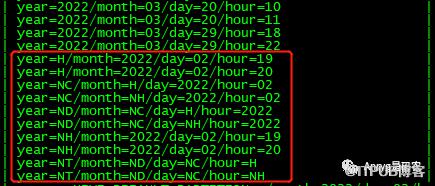
出现分区错乱
llap的守护进程是用来承载hive数据的写入和读取工作的,但是这个守护进程占用的资源必须提前配置,需要提前对后续数据的写入和读去提前预估,而这个预估其实很难,如果资源配置过高(CPU和内存),会导致占用过多的yarn资源而造成浪费。如果配置过低,当集群中出现多个并行的spark操作hive的任务时,可能因为llap进程内存资源不足而导致OOM,而此类情况,我们已经遇到多次;
某些服务如果挂掉,比如hiveserver2 interactive,如果想重启,有时候特别困难,或者重启时间很长;
只支持ORC存储格式的表,且必须拥有ACID属性;
<dependency>
    <groupId>org.apache.spark</groupId>
    <artifactId>spark-core_2.12</artifactId><!--提供SparkContext对象-->
    <version>3.2.0</version>
</dependency>
<dependency>
    <groupId>org.apache.spark</groupId>
    <artifactId>spark-sql_2.12</artifactId><!--提供SparkSession对象-->
    <version>3.2.0</version>
</dependency>
<dependency>
    <groupId>org.apache.spark</groupId>
    <artifactId>spark-hive_2.12</artifactId><!--提供spark连接hive-->
    <version>3.2.0</version>
</dependency>object Spark3ConnectHive3 {
def main(args: Array[String]): Unit = {
val conf = new SparkConf().setMaster("local")
conf.setAppName("connect_hive")
val sparkSession = SparkSession.builder().config(conf)
.enableHiveSupport()
.getOrCreate()
val result = sparkSession.sql("select * from doi_data limit 2")
result.show()
sparkSession.close()
sparkSession.stop()
}
}
我一直觉得hive的ACID属性是个鸡肋,这个像是让其功能更加贴近RDBMS而强加进去的,除了能让你对hive表进行update、细粒度的insert之外(效率很低),并不能实现像传统数据库那样的事务功能。
CREATE EXTERNAL TABLE `as_bgp_bak`(
   `as_start` string,
   `as_end` string,
   `id` int)
 ROW FORMAT SERDE
   'org.apache.hadoop.hive.ql.io.orc.OrcSerde'
 STORED AS INPUTFORMAT
   'org.apache.hadoop.hive.ql.io.orc.OrcInputFormat'
 OUTPUTFORMAT
   'org.apache.hadoop.hive.ql.io.orc.OrcOutputFormat'
 TBLPROPERTIES (
  'transactional'='false'
)
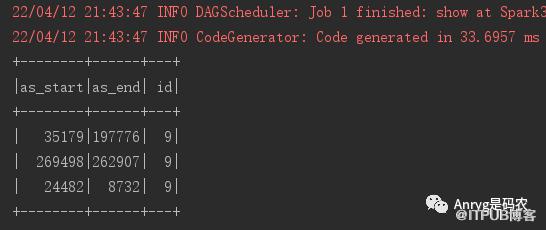
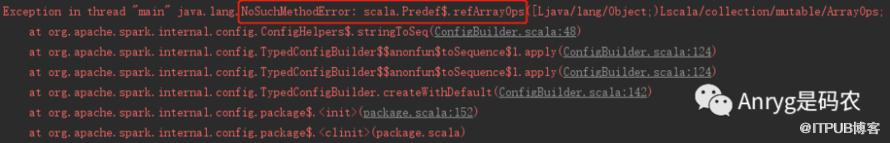
可能有同学有疑问,说spark升级难道不需要升级spark服务吗?我的经验是:不需要,因为它不像hive、HDFS这一类[强服务]的组件,spark是[弱服务]的,升级对应的jar包即可,具体如何升级,后面文章会具体说明。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

