为什么说无损,是因为如果用官方提供的Ambari自带的升级方案目前只能支持整个HDP组件的升级,也就是说你目前部署的所有组件都要升级到一个新的版本,这个改变实在是有点太大,而且很多时候并没有必要。而在此期间,我也专门查了一些关于集群中spark升级的文章与资料,发现其中描述的升级步骤过于繁琐与复杂,存在大量的修改与替换,把原本一件可以很简单的事情硬生生给整麻烦了。
而本篇文章试图通过对spark运行过程的剖析,来解构如何以一种[狸猫换太子]的方式,高效简单地完成低版本的spark到高版本的升级过程。先给结论:完成从spark2到spark3的升级,无修改只替换,仅需2步,希望你能耐心看完。
想要完美的升级一个技术组件,就必须要搞清楚这个技术组件的运行过程与原理,尤其是那种与其他技术组件有耦合与关联关系的,务必要清楚哪些部分需要[动],而哪些部分可以[不动]。上一篇文章说到spark是一个[弱服务]的技术组件(为了怕你误会,这里特指spark on yarn模式),怎么理解呢?它跟HDFS、Hive这种[强服务]的组件不一样的地方在于,客户端要想跟HDFS或者Hive进行交互,你就必须要先跟其服务(比如HDFS的NameNode或者Hive的Metastore)进行[打交道],你得有这么个[中间人]才能办后面的事情,比如你要往这里面写数据或者查找数据,你的请求信息是先发个这个[中间人],然后由这个[中间人]再告诉客户端,应该往哪写,应该往哪读。而写完,读完的数据,最后又交由这个[中间人]来管理。但spark则不一样,它不依赖于任何一个自身的服务,只是提供了一套运行其任务时必要的SDK。虽然spark提供了spark history server和spark thrift server这两种服务,但是在我看来,其功能寥胜于无,根本丝毫不影响你spark任务的提交与运行。
来,千言万语不如一图来的痛快,看下图所示spark任务的提交过程:
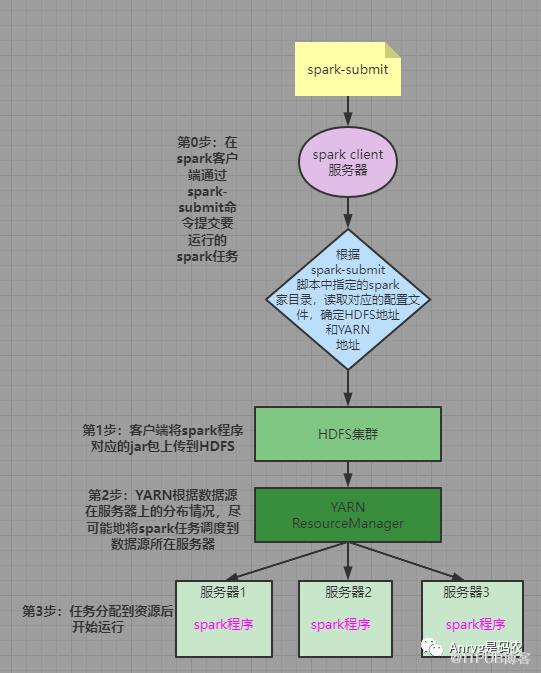
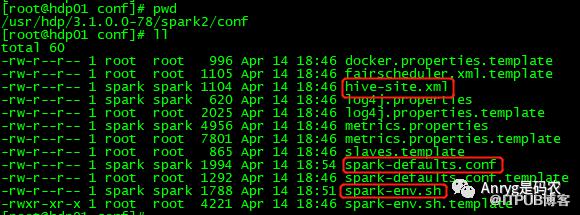
可以看到在spark任务提交到YARN过程中,跟spark相关的地方有如下2处:1,spark的home目录:这里涉及到跟spark有关的jar包和配置,比如Hadoop地址,yarn地址、zookeeper地址、hive地址等,通过它来找到对应的服务位置;
2,spark运行过程中依赖的jar包:这里除了你用spark-submit提交时候指定的jar包外,spark还会给你额外添加一些依赖包。在哪呢?每次你提交spark任务时,仔细观察提交的日志,可以看到这里有明确的信息告诉你,额外依赖了HDFS上的其他2个依赖包;

既然受影响的地方是这两处,也就是说,在升级时候注意这两个地方就可以了,如果目录或者依赖包有前后有变化咱就[更换],如果没有变化那就不动。对于spark这种[弱服务]组件来说,升级本质上只需要替换对应的jar包和对应的配置就可以了。在升级服务器上相关的内容之前,我们先看下,如果只升级本地开发环境的的spark依赖会怎么样?来,验证一下,在我只升级本地开发环境的jar包后(从原来spark2的jar包升级到spark3),直接提交到spark2的集群环境中,看下效果:报错原因其实就是新老版本的jar包冲突导致,当你在客户端提交了spark3的代码后,此时spark-submit会同时将HDFS上原来存在的spark2的依赖包一并给放到你的运行环境中,因此就出现了无数个新类和老类同堂的局面,因为类名相同,而此时类加载器很可能就加载了一个错误的类而导致这种失败。这个时候一定不要去纠结这个错误的具体细节,否则你会陷入一个一直追究类错误而无法自拔的泥潭中。
既然是HDFS中提供的依赖包导致的问题,那我们把这个依赖包升级到新版本,是不是就可以解决问题了呢?
带着这个疑问,来,继续验证,我们先只升级HDFS的依赖包试试(暂时不升级spark客户端),我们把下面这两个依赖包换成最新的版本:

第1步:到spark官网下载你要升级的spark软件包,我选择的是3.2.0版本:
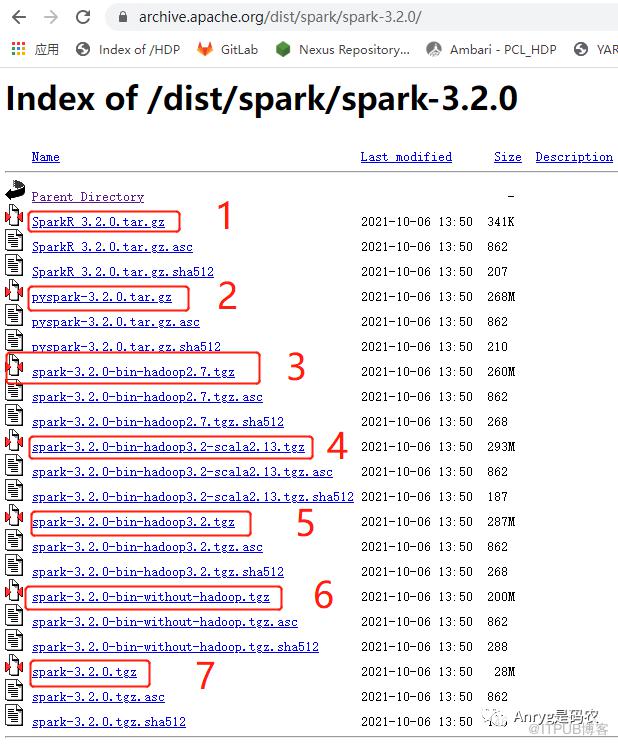
但是可以看到,一共有7个spark3.2.0的软件包,怎么选呢?来,我们用排除法,第1、2两个先排除,因为是spark的基础软件包,一定是Scala版本,即原生版本(因为spark就是Scala写的嘛),而这两个是提供R接口和Python接口的,排除;第3个因为对应的Hadoop是2.7,而我们现在HDP对应的Hadoop对应的可是Hadoop3,也排除;然后7也被排除,因为其提供的是所有spark的源码,如果使用还需要重新编译;剩下的再看4、5、6,这3个的区别在于,除了spark本身的jar包外,是否有含对Hadoop3的依赖,其中4跟5的区别仅仅在于Scala的版本不一样,4依赖的是Scala2.13版本,而5依赖的是Scala2.12版本,于是接下来我们只需要确定到底是否要下载含有Hadoop依赖的版本?至于如何确定,我们把原来HDFS中依赖的/hdp/apps/3.1.0.0-78/spark2/spark2-hdp-yarn-archive.tar.gz下载下来打开看一下,你会发现这个压缩包其实装的全是spark用到的jar包: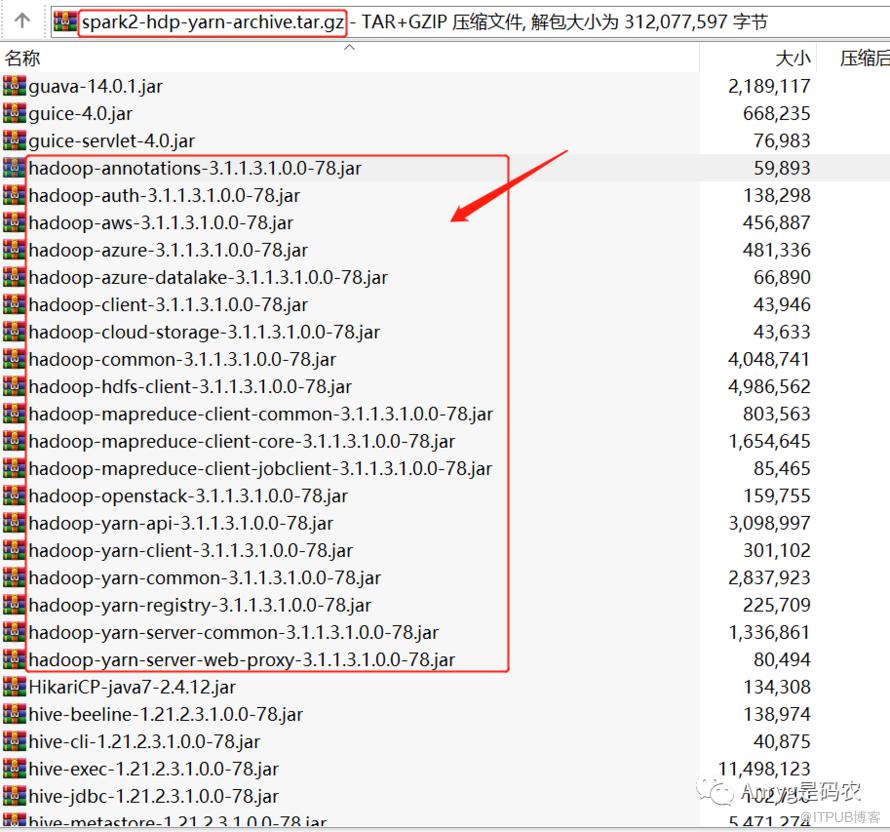
可以看到,之前的spark依赖包中是含有Hadoop依赖的,因此我们新的版本也一样需要Hadoop依赖。于是需要下载4或者5,至于选哪一个?看你喜欢哪个Scala的版本喽?为了防止后续频繁升级Scala,因此我选择的是Scala版本最高的那个,也就是4。第2步:将选定的spark软件包下载完成后,解压到spark的client服务器
然后进入到解压后的jars子目录中,将该目录下的所有jar包进行打包,打包后的包名跟HDFS中依赖的包名spark2-hdp-yarn-archive.tar.gz保持一致。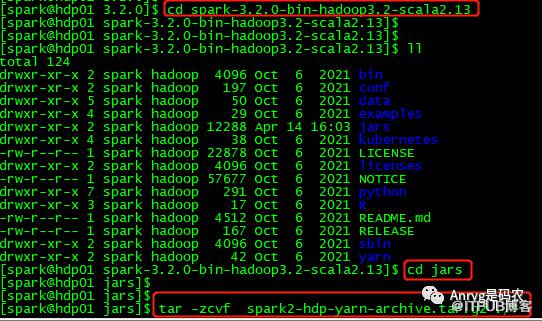
第3步:备份原本HDFS上老的spark2-hdp-yarn-archive.tar.gz(万一升级不成功还可以回退不是),然后删除掉,接着把新打包的给传上去。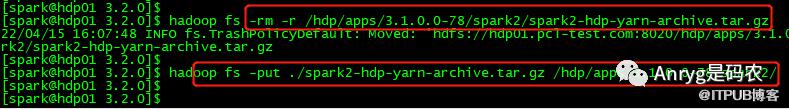
好了,这样HDFS上spark依赖的依赖包就升级完成了。可能有人会说,咦?HDFS上不是应该依赖有2个包吗?spark2-hdp-yarn-archive.tar.gz和spark2-hdp-hive-archive.tar.gz不是吗?怎么另外一个不升级呢?那是因为另外一个包只是关于hive的,跟spark无关,因此不需要升级,不信,你可以把这包打开看下里面的内容确认一下。
接下来,咱就提交代码到集群看一下,是否能运行成功:
很不幸,还是报错了,但是这次的错跟升级HDFS上依赖包之前报的错是不一样的,这个错是说本地的软件版本跟集群上的软件版本因为不一致而导致的不兼容,而这种情况又多半是因为Scala版本不一致导致的,但是我检查了下我开发环境的Scala版本,跟HDFS上是一样的啊,不信你看。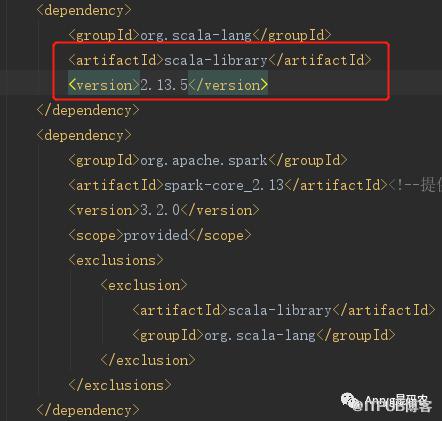
来,打开spark的客户端目录,可以看到这样一个目录结构: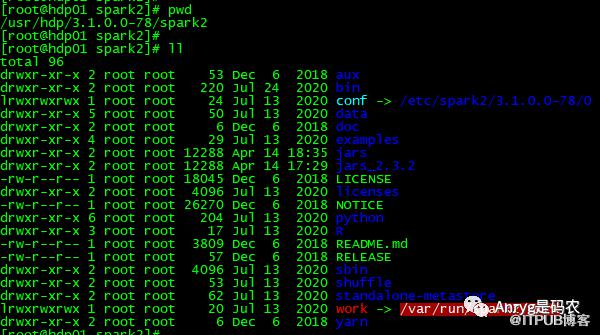
我们需要把这个目录下的所有内容全部替换成spark3的(老规矩,替换前先备份老的),我这里把之前的目录重命名,然后把新的spark3的内容全部拷贝过来。
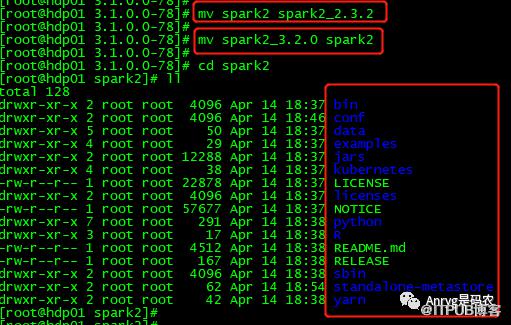
其中spark2_3.2.0就是刚才我们下载的spark包,只不过我换了个名字,希望你能看懂。其实还差最后一小步,配置文件,因为我们是把整个新的spark3目录拷贝过来的,配置文件肯定还是原始的状态,为了跟原来的目录结构保持一致,我们用建立符号链接这种方式。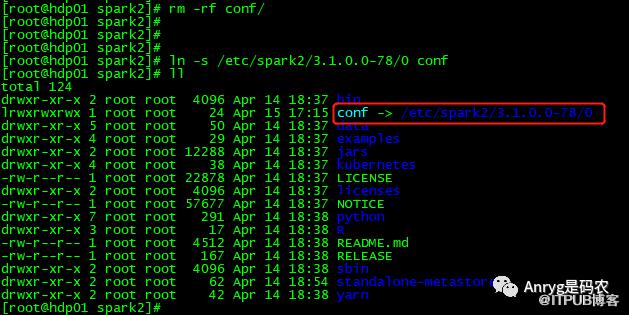
用符号链接最大的好处在于统一管理,配置文件只需要一份,但是可以将其链接到多个不同的地方,避免了一次改动,需要多处同步的局面。

看到网上有人在升级时候,只对2个版本不同的jar包进行替换以及对配置文件进行修改,然后重命名,这样虽然也可以,但是我认为效率太低,而且容易出错。
目前这个是我摸索出的[最简]升级方式,可以看到为了最简,有些地方我都没有去修改,比如Ambari页面中显示的spark版本,这个需要你去修改一个专门的配置文件,将原本的spark2改为spark3,但我觉得无所谓,这些丝毫不影响你的spark使用。另外,在spark的服务节点,比如我开启了spark的history服务,在其服务器对应的spark家目录下必须要一个standalone-metastore目录,而这个在spark3中是没有的,需要从原来的spark2中拷贝过来,不需要做任何修改。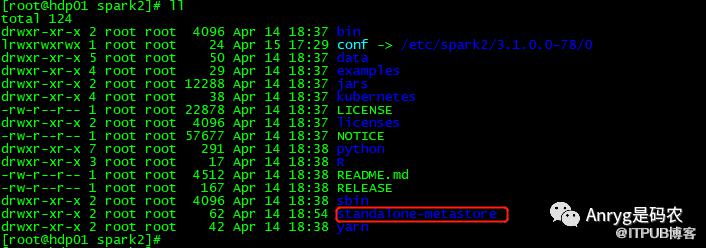
这样就可以顺利启动spark history server了,但是如果你想省略这一步也没有什么关系,毕竟我前面说过,这个服务就是个鸡肋,想要看spark的历史任务,去yarn的界面看就好了。
啰嗦了这么多,其实整个升级过程总结起来就2个步骤:1,升级HDFS的spark2-hdp-yarn-archive.tar.gz包;2,升级spark客户端或者服务端的本地目录,全部替换成新的,然后把对应的conf目录用符号链接到原来的配置目录;
写这么多主要是想告诉你,升级一个软件,核心需要抓住哪些地方,当你掌握了这一点,以后就可以[以不变应万变],类似的升级你都不在话下了。
因公众号无法留言,如果你觉得我讲的还凑合或者有任何疑问,欢迎找我交流探讨...
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。


