我们知道,升级spark之后,一般都需要升级对应的Scala版本,而之前我用spark2的时候,对应的Scala版本为2.11,但是升级到spark3之后呢,就要求Scala的版本必须得是2.12或者2.13。
怎么知道的呢?咱来看下maven的中央仓库就清楚了。
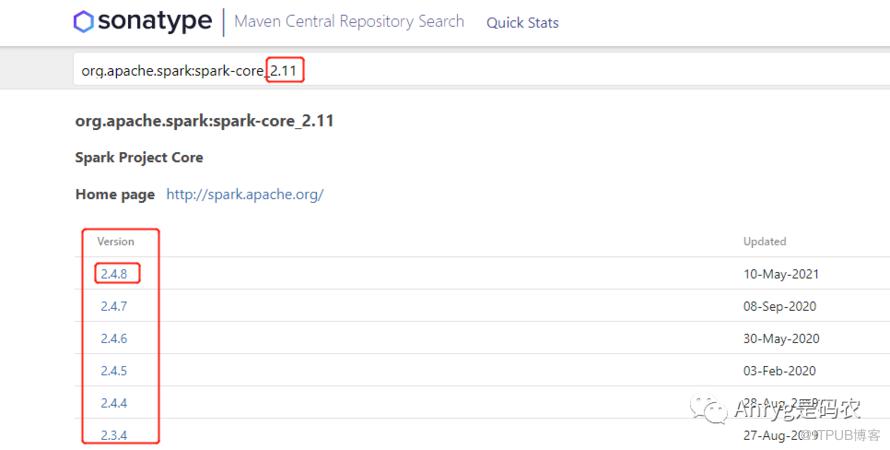
对于Scala2.11来说,最高支持的spark版本为2.4.8。
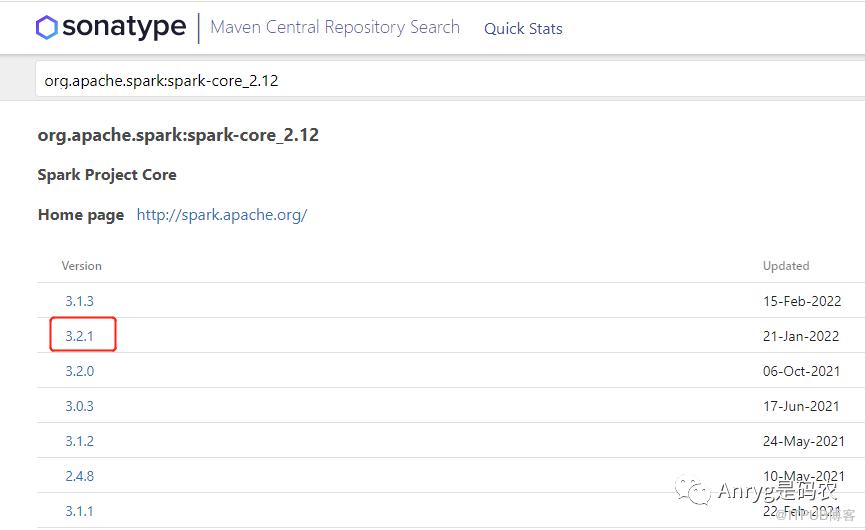
而对于Scala2.12来说,则最高可以支持到3.2.1,也就是当前spark的最高版本。
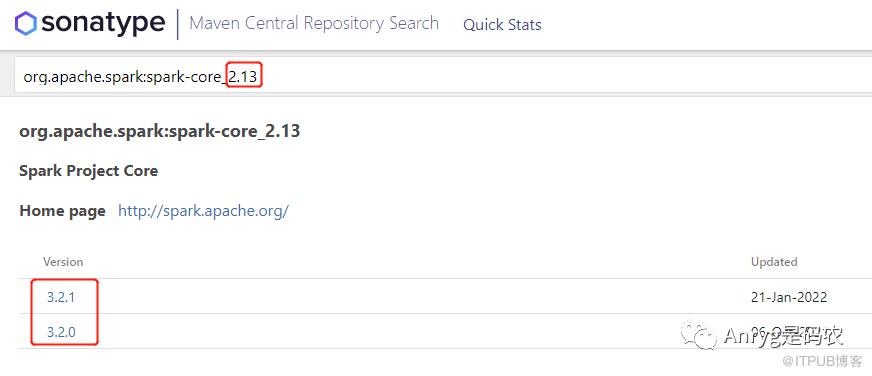
但是如果是Scala2.13,目前只支持最高的两个spark版本。
一开始,我是直接把Scala升级到了最新版本,想着以后再次升级spark的子版本的时候(3.x内的小版本升级)就不需要再动Scala了,但是发现现实很快就打脸了。发现Scala2.13存在诸多的坑。
当我把软件包中所有的跟Scala相关的版本升级到2.13之后,准备编译代码时候发现了这么个玩意。
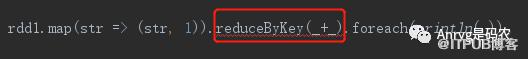
居然对于这种常用的二元组数据结构(key,value),但凡涉及到对key进行聚合的函数全部飘红,说不符合语法,一时间搞的我是一头雾水,去网上查了半天资料也没有找到什么有效信息,心想,估计可能是太新了吧,或者2.13不不支持这些玩法了?
其实Scala2.13带来的api变化远不止这些,为了避免修改太多api而导致当前现有的软件工作造成一些不可控的影响,再者,官方论坛上对于spark配Scala2.13的资料实在太少,于是决定放弃Scala2.13这个较高的版本
因为不想在这个事情上浪费太多时间,心想,咱不是还有2.12版本嘛,于是果断降级到2.12的版本。
但是,即便Scala换到了2.12版本,问题依然不少,来看下面几个关键的变化:
常用的Java与Scala集合对象之间进行转化的类由这个
scala.collection.JavaConversions
-
变成了这个
scala.collection.JavaConverters
而且集合对象在代码中使用时候,需要用asJava或者asScala进行显示转化

将Java对象转化成为Scala对象
原来的Scala编译打包插件也不再适用,需要升级,这个是升级前的插件版本
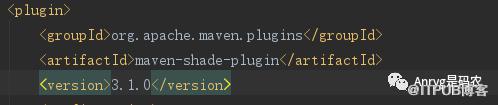
打包时出错:
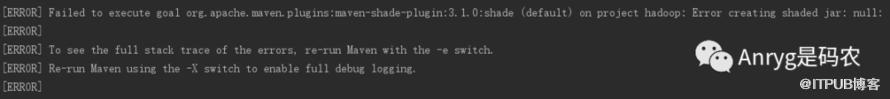
这个时候需要将打包插件这个3.1.0的版本升级到3.2.0,问题解决。
-
项目中依赖的es-spark需要做相应的升级,但是因为之前我们用的es为7.6版本,而es-spark3对应的最es最低版本是7.12

以我的经验,像这种api与服务之间的版本差异如果不大的话,是可以相互兼容的,事实证明也确实是可以。
对DataFrame直接进行foreach操作会出现编译无法通过的bug,
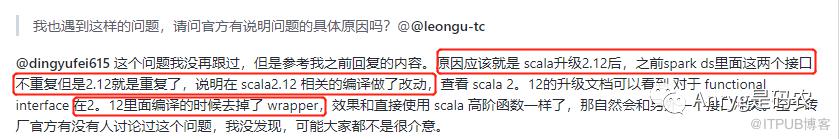
解决办法是将其转化成为rdd再操作,原因我没有去仔细研究,就搬运下论坛里的回答吧:
而像这种多组件协助的软件工程,但凡有其中一个组件有大版本的升级,除了带来表面的我们容易看到的变化外,还会带来一些潜在的我们无法直接感知到的内在变化(子依赖的改变),比如一些非关键组件之外的jar包冲突。
比如下面这个错:
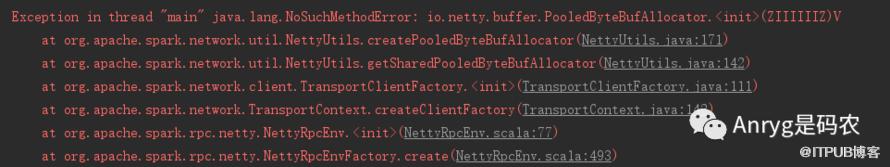
无法找到一个类中的init方法,也就是构造方法,这是一种典型的jar包冲突问题。
一般我在利用maven的配置文件引入jar包依赖时,每引入一个jar包都会习惯在maven中央仓库去看这个jar包内部还存在哪些子依赖,如果这些子依赖中有部分在当前的软件工程中已经存在,那么就把这个子依赖它给排除掉,尽量保留高版本的那一个,虽然这样做比较费时费力,但是当你的软件项目越来越庞大之后,就可以有效的避免jar包冲突问题的出现,长久来看是一种划算的做法。
怎么定位?遇到这种问题先不要慌。
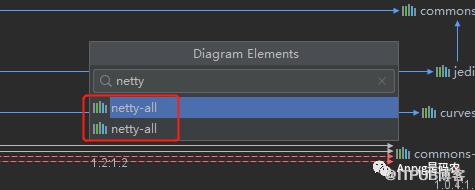
先在软件工程中找到跟该类有关的jar包看有哪些(利用IDEA快捷键Shift+Ctrl+Alt+N来查找)?
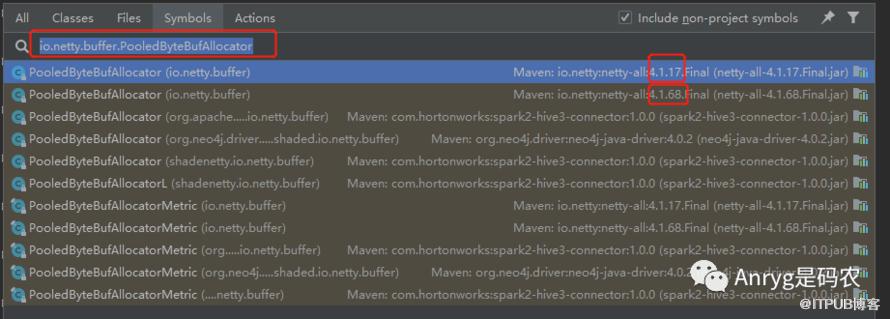
可以看到有两个一模一样的netty-all的包,但是版本不一样,于是这个时候就需要去掉一个。
但是去掉哪个呢?是不是心里没谱,因为这两个版本既不跟Scala的版本保持一致,也不跟spark的版本保持一致,怎么办?
那就去spark的家目录中的jars子目录去瞅瞅,找到对应的netty-all对应的版本,这里的版本一定是兼容当前spark运行环境的,来看一下:
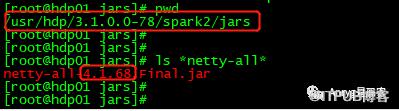
可以看到当前使用的版本为4.1.68.Final,于是毫不犹豫,将软件工程中的其他版本给排除掉。
排除掉的方法很简单,如果这个jar包是单独引入的,直接把这部分的配置删除。但是,如果这个包是另一个包的子依赖,这个时候为了方便,可以借助IDEA的工具来进行排除。
具体做法,把光标移动到你的pom文件里,右键打开菜单,如下图所示:
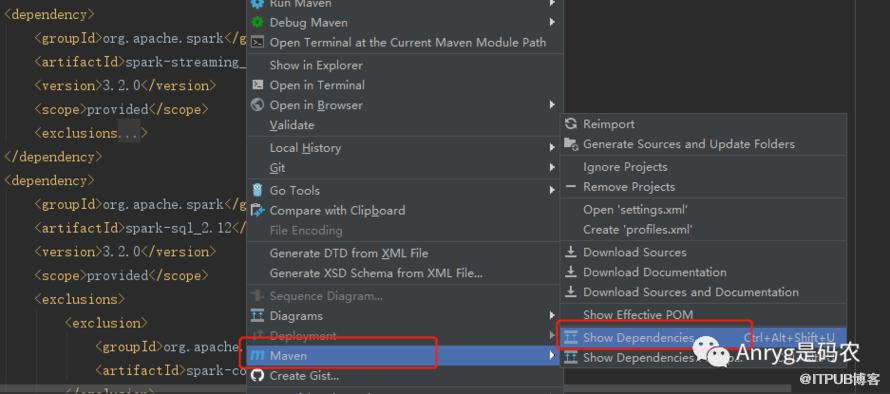
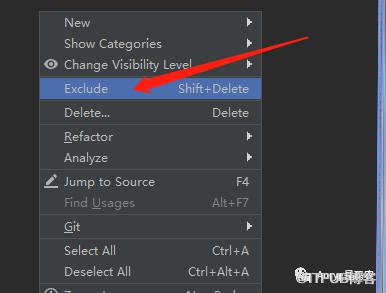

这个时候,这个不需要的jar就被排除掉了,但是请需要注意一点的是,当排除完这个jar包之后,最好再用刚才的方式检查一遍当前软件项目中netty-all包的版本,确保是我们期望的那个,因为有的时候你通过这种方式排除,虽然你只操作了一次,但是很有可能把这个包的所有版本都给排除掉了,导致项目因缺少了这个包的依赖而报错,而你却不自知。
另外,你以为就完了吗?
要知道现在这个调试还只是在你的本地环境,想要确保本次软件升级彻底成功,还得提交到集群上测试一下才可以,把你的spark程序打包提交到spark的客户端服务器,用集群模式运行,如果运行一切OK,那么说明本次升级工作告一段路。
但是如果提交到集群发现有报错,排除代码逻辑和数据源本身的问题外,那多半是因为本地的软件包环境跟HDFS上的软件包环境不一致导致,如果出现该情况,那就需要你将本地开发用的所有软件包的版本跟HFFS上依赖的版本进行一一核对。
我估计很多同学都不太清楚这一点,如果你的spark是通过spark on yarn的方式运行的话,spark-submit会除了把你命令中带的相关jar包上传到HDFS之外,同时会融合HDFS上一个特定的压缩文件,两者一起组合成当前程序在集群上运行的新的依赖。
这个目录对于HDP集群来说是这个(具体可见上篇文章 Spark2无损升级Spark3)。

HDFS中spark运行时依赖的jar包
我经常感慨,说大数据开发过程中,最难的并不一定是利用这些api把数据源处理成业务需要的结果,而是面对诸多技术组件同时出现在一个大的软件工程中,在它们之间进行协助与通信时,你不得不去面对它们随时可能因为版本间的不兼容而导致的各种代码冲突、以及不可思议的[灵异]事件。
而当集群中如果突然对其中的某个组件进行升级,这种问题会一时间更加的凸显,能够把这种问题及时,有效的搞定,是很考验开发者功力和经验水平的。
对于类似问题的出现到解决,好像用文字描述时三言两语就完事了,但是你要知道当这个问题真正摆在你面前的时候,你的思考路径可远不止这点文字能表达的。
可能对于大多数大数据开发的同学来说,我的这些问题显得有些[杞人忧天],因为你面对的开发环境早就有人替你准备好了,把这些坑给趟平了,你自己写业务API就好了,对于这些相对[底层]一点的东西,你却无法感知,而这恰恰是拔高你专业能力的关键点。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

