在开始之前,我们先来看下的为什么会有所谓的jar包冲突问题产生?
我们知道,对于大数据项目来说,你的代码为了满足各种对数据处理的要求,maven依赖中一定会引入非常多的对应功能jar包,而不同的jar包中,还会同时存在很多的子依赖,而在各个子依赖中,可能同时引用了同一个名称(包名相同)但是不同版本的jar包(当然还会存在不同的jar包之间,有着一模一样类名的时候,但是这个情况不多)。
来看下面这个图:
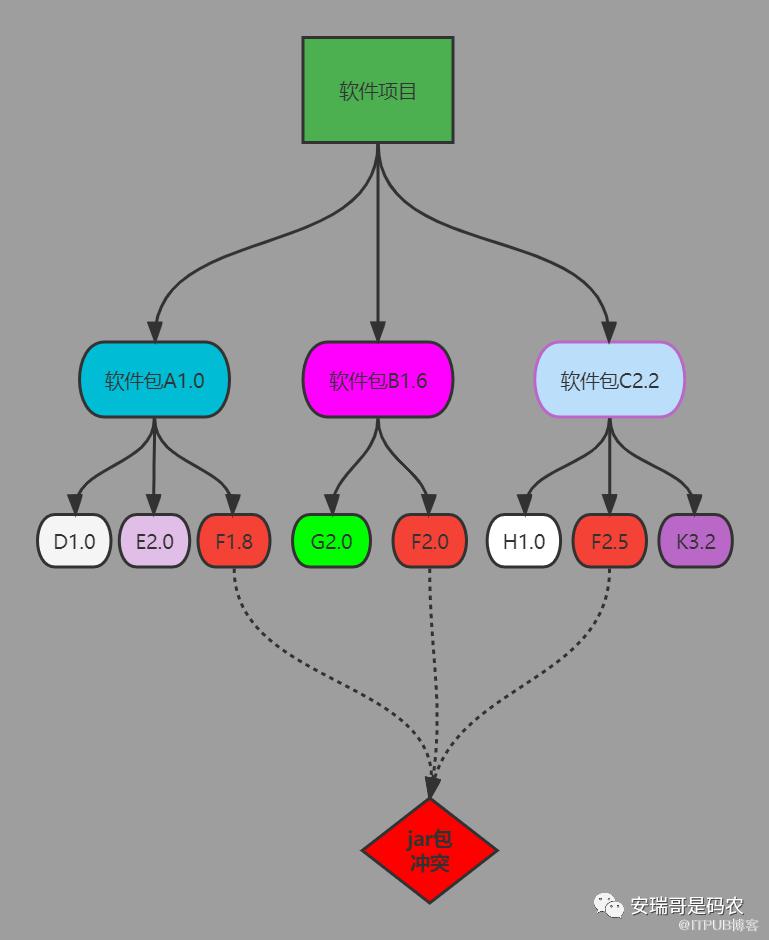
一个软件项目的jar包依赖示意图
该项目同时依赖了包A、B、C,而它们彼此又有很多子依赖,在众多子依赖中,它们同时依赖了一个叫F的jar包,但是彼此之间的版本各不相同,而如果我的项目想要正常运行,只能加载F的2.5版本,但是你无法保证每次程序运行时,其类加载的顺序是按照你的要求来,假如它加载了F的1.8版本,而这个版本的某个类跟2.5的版本相比有较大的改动,比如缺少某个功能,或者没有某个关键函数,就会导致程序运行报错。
而这个时候的报错行为,我们就称之为jar包冲突。
了解了jar包冲突的原理后,我们先来个开胃菜,举个简单的jar包冲突例子。
来,先看这个最简单的spark程序。
import org.apache.spark.{SparkConf, SparkContext}
object Demo {
    def main(args: Array[String]): Unit = {
        val sparkConf = new SparkConf()
        sparkConf.setAppName("jar包冲突测试")
        sparkConf.setMaster("local")
        val sparkContext = new SparkContext(sparkConf)
        val seq = Seq("a","b","c","d")
        val rdd1 = sparkContext.parallelize(seq)
        rdd1.foreach(data => println(data))
    }
}
再瞅一眼其maven依赖情况:
    <dependencies>
        <!--提供基础的scala运行环境,类似Java的JDK-->
        <dependency>
            <groupId>org.scala-lang</groupId>
            <artifactId>scala-library</artifactId>
            <version>2.11.7</version>
        </dependency>
        <!--提供SparkConf和SparkContext对象-->
        <dependency>
            <groupId>org.apache.spark</groupId>
            <artifactId>spark-core_2.12</artifactId>
            <version>3.2.0</version>
        </dependency>
    </dependencies>
好,来运行一下看看,会不会出什么幺蛾子:
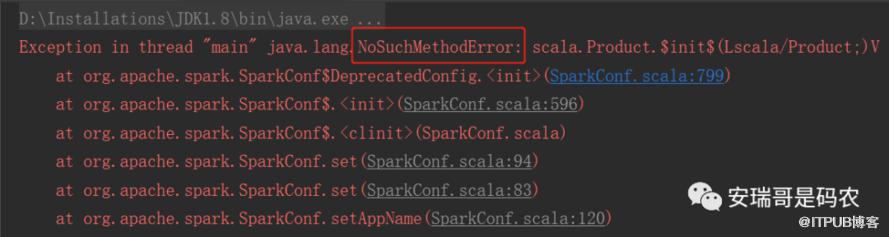

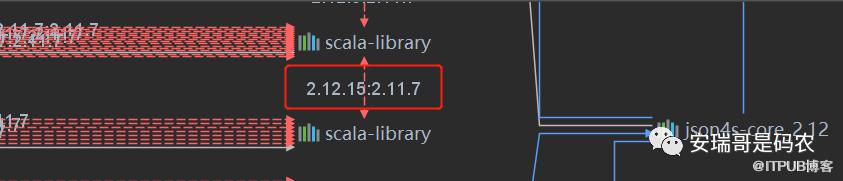
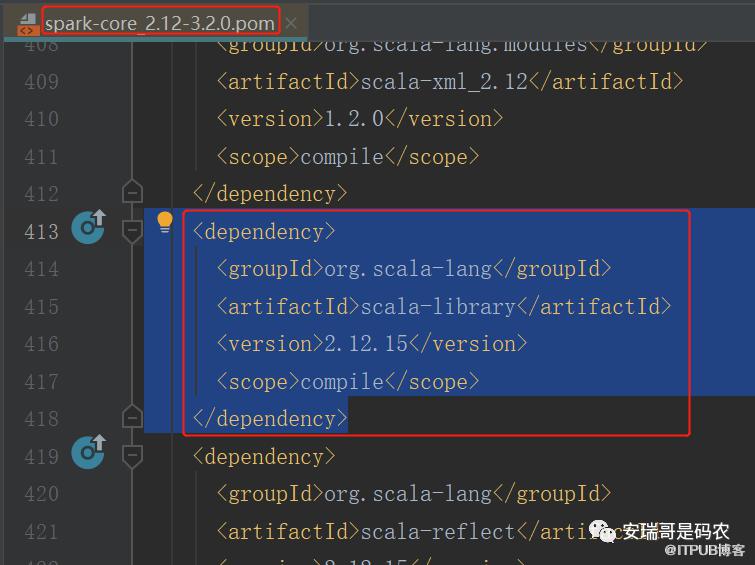
object BigdataDemo {
    def main(args: Array[String]): Unit = {
        val sparkConf = new SparkConf()
        sparkConf.setAppName("jar包冲突测试")
        sparkConf.setMaster("local")
        val sparkContext = new SparkContext(sparkConf)
        val seq = Seq(1,2,3)
        val rdd1 = sparkContext.parallelize(seq)
        rdd1.foreach(println(_))
    }
}
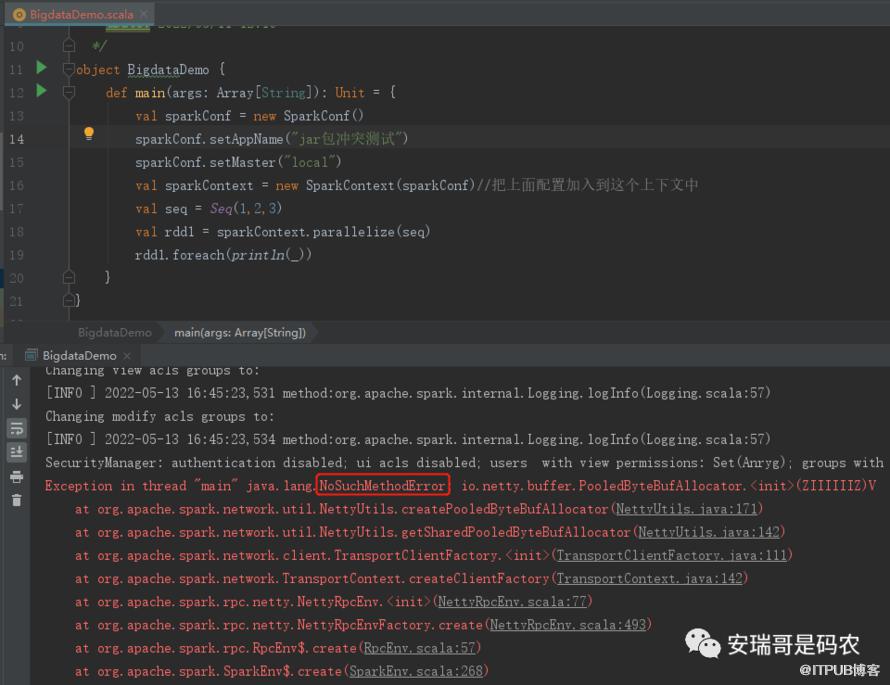
以我的经验,凡是报错说NoSuchMethodError的几乎都是jar包冲突导致。
既然告诉我类io.netty.buffer.PooledByteBufAllocator没有某个方法,那我们就来看下哪个或者哪几个jar包中含有这个类。
来,还是通过IDEA的快捷(Ctrl+Shift+Alt+N),看下查找效果:
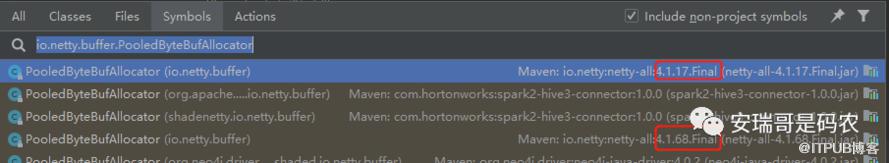
可以看到,出现了2个版本的netty-all,说明我们当前的软件工程中是存在两个不同版本的netty-all的,那我们来进一步验证一下,当前这个module中,其依赖的所有jar包中,是否也含有netty-all的版本?
怎么看?通过IDEA的工具,打开当前module中maven依赖的依赖树,查找当前module中依赖的netty-all的版本,具体方式这里不赘述:
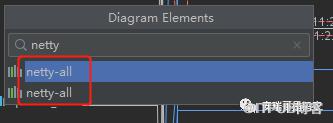
可以看到,我能找到2个不同版本的netty-all,其中一个是4.1.17另一个为4.1.68,这里我只能留一个,留哪个?
那是那句话,得根据项目的主体来定,我们这个项目的主体是谁?是spark对不对,一个最简单的方法,就是打开服务器spark的home目录,然后查看里面的lib目录下的jar包情况,找到其中netty-all的jar包,跟其保持一致,就错不了。
打开之后可以看到,是这样的:
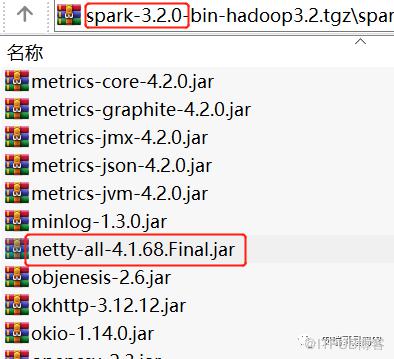
赫然显示4.1.68版本,因此,果断将原来的4.1.17给排除掉,具体排除方式这里也不赘述。
排除后发现只剩下一个netty-all的版本了:
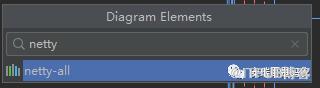
我们再来运行下代码试试:
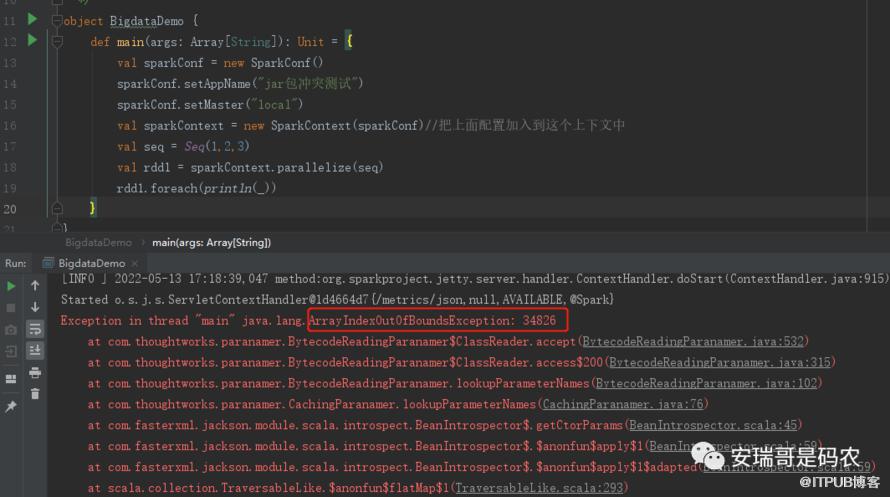
啊哦... 还是报错了,但是这次错不一样了,提示居然说数组下标越界?
纳尼? 我这代码中没有对数组进行下标操作啊,怎么就下标越界了呢?
如果你一直把问题纠结在代码处理的数据上,就正好就中了这个问题给你设下的圈套。
首先要非常明确的知道,这个肯定不是我代码处理数据的问题,但是在代码的一层层调用过程中,当调用到某个类的某个方法时,才抛出的这样的异常。
那我们是不是可以来看下这个抛出异常的类,叫BytecodeReadingParanamer.java,我们把他打开来看看:
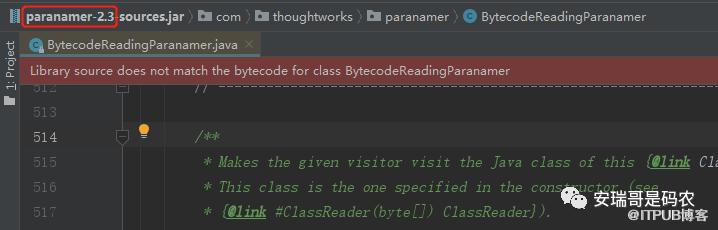
可以看到,这个类属于一个叫paranamer-2.3的jar包,按理说这样一个不怎么起眼的包,正常情况下是不会有问题的,难道是调用的版本不对吗?
验证一下,还是用刚才的办法,在当前module的依赖树中找出这个包:

果然,发现有2个不同的版本,一个2.3另一个2.8,我们排除一个试试,排除哪个?
还是用刚才那招,看spark家目录中对应的这个包是哪个版本:

确定是留2.8,那么就把2.3的版本给排除掉:
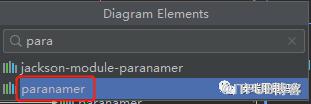
排除之后,我们再运行下程序试试:
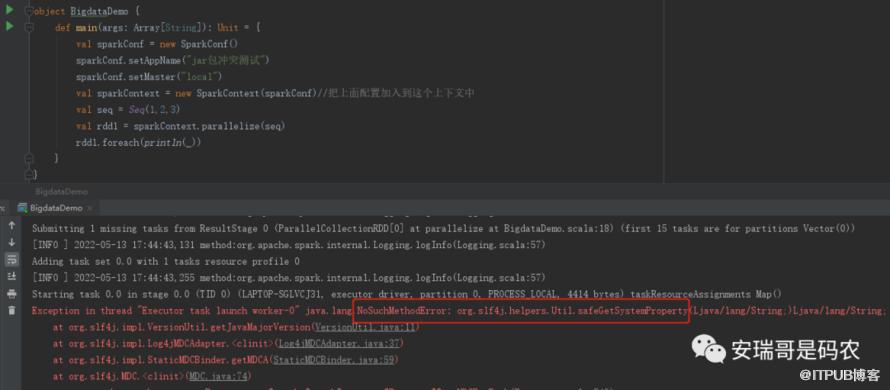
我还沉浸在解决刚才那个冲突问题的喜悦中呢,又报错了,又是一个NoSuchMethodError,又一个典型的jar包冲突问题。
还是老方法,先查看该类对应的jar包:
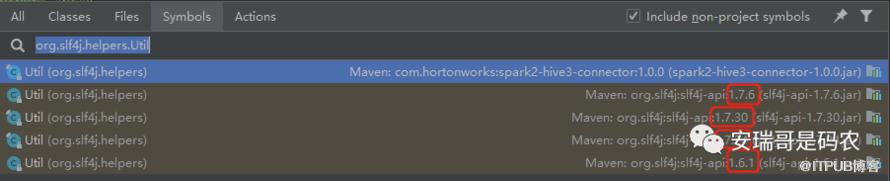
可以看到好几个不同的jar包版本,留哪个?老规矩,看spark家目录中对应的jar包版本,把低版本的给排除掉。
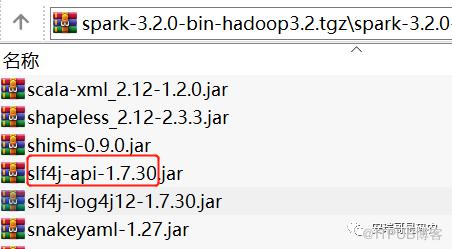
那我们就只留1.7.30,其他版本的给排除掉(具体方法不赘述),再试试:
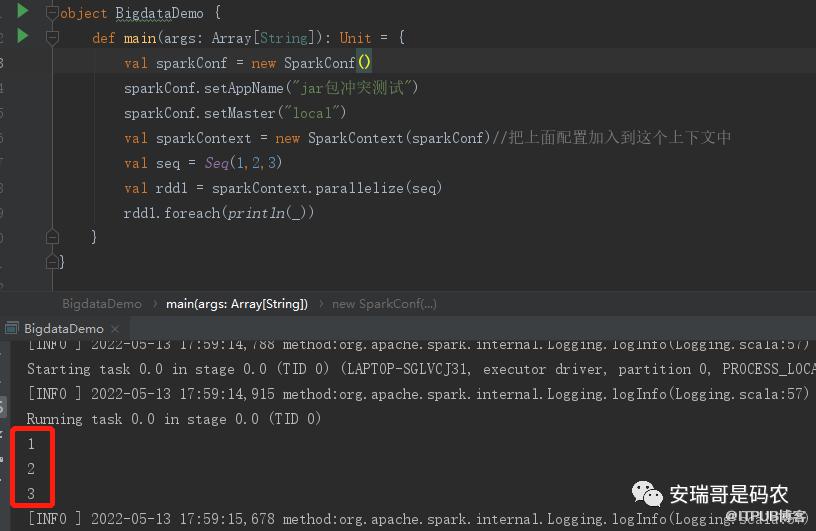
终于,经过了3次jar包的版本调整,总算运行成功了,就为了这3个数字,容易嘛我。
得说明一下,这个是发生在我项目中的真实案例,并不是为了攒出这篇文章而故意营造的代码事故。
而且更值得说明的是,在我解决这个jar包冲突问题之前,代码虽然无法在本地IDEA中运行,但是如果打包提交到yarn集群上,却一点事也没有,进一步增加了jar包冲突问题的不可预料性。
我之前还遇到过更棘手的情况,就是两个不同名称的jar包,出现了同一个类名,但实现却不相同,而且这个两个jar包在项目运行中缺一不可,当时的解决办法是将有冲突的那个类进行重命名,然后让程序只加载需要的那个类,具体实现,以后有机会再讲。
对于jar包冲突问题的解决,最难的点在于对问题本身的识别,你要能知道当下这个报错就是因为jar包冲突导致,而不是别的原因。
识别到了,解决起来就简单了。
对于jar包冲突的案例,以上的场景基本上能覆盖到你的大数据开发项目中的90%以上。
以上内容,希望对你有所帮助。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

