大家对普通的那种C/S架构服务模式应该不陌生,就是我通过一个客户端(C端),向服务端(S端)发送请求,该请求会遵循某种协议(比如http、tcp等等),发送到服务端。
然后服务端,根据请求内容对其进行响应,然后将结果返回给客户端。
但是yarn并不是这么玩的,如果说你仅仅只是利用yarn的状态查询API,在IEDA编写好对应的代码,然后连接yarn的ResourceManager,来获取当前yarn队列中任务运行情况,这个没有问题。
但是如果你想通过yarn来提交你要运行的分布式任务,用这种直接通讯的方式是行不通的。
为啥呢?因为yarn并不是一个简单的通过客户端请求,然后根据请求内容响应对应结果的服务啊。
它是一个任务管理和资源调度框架,它只是用来将你提交给它的可运行代码,通过对运行时需要的硬件资源进行评估,然后分配到若干台服务器上并发运行的一个调度服务。
所以这里有个很重要的前提,就是如果你想在yarn上面运行你的分布式任务,必须向其提交你运行时需要的所有环境依赖,这里面既包括你代码开发中需要的第三方jar包依赖,还需要运行时需要的对应配置。
当你向yarn提交你的spark任务时,你知道整个过程的细节是什么样的吗?
比如当你在一个spark客户端运行如下命令时:
spark-submit --master yarn --deploy-mode cluster --conf spark.driver.memory=512m
--class com.anryg.MainClass --executor-cores 2 --num-executors 3
--executor-memory 1g --name Spark_App --jars /the/path/to/first/jar/1.jar /the/path/to/second/jar/2.jar
你的任务经历了哪些阶段后,才在yarn上面正式运行起来了呢?
如何理解spark客户端?
就是一个包含有spark配置文件目录,jar包目录,一堆可执行命令目录的这样一个SDK,因为计算引擎的本质上就是一堆可以提供各种api接口的SDK啊。
来看这样一张图:
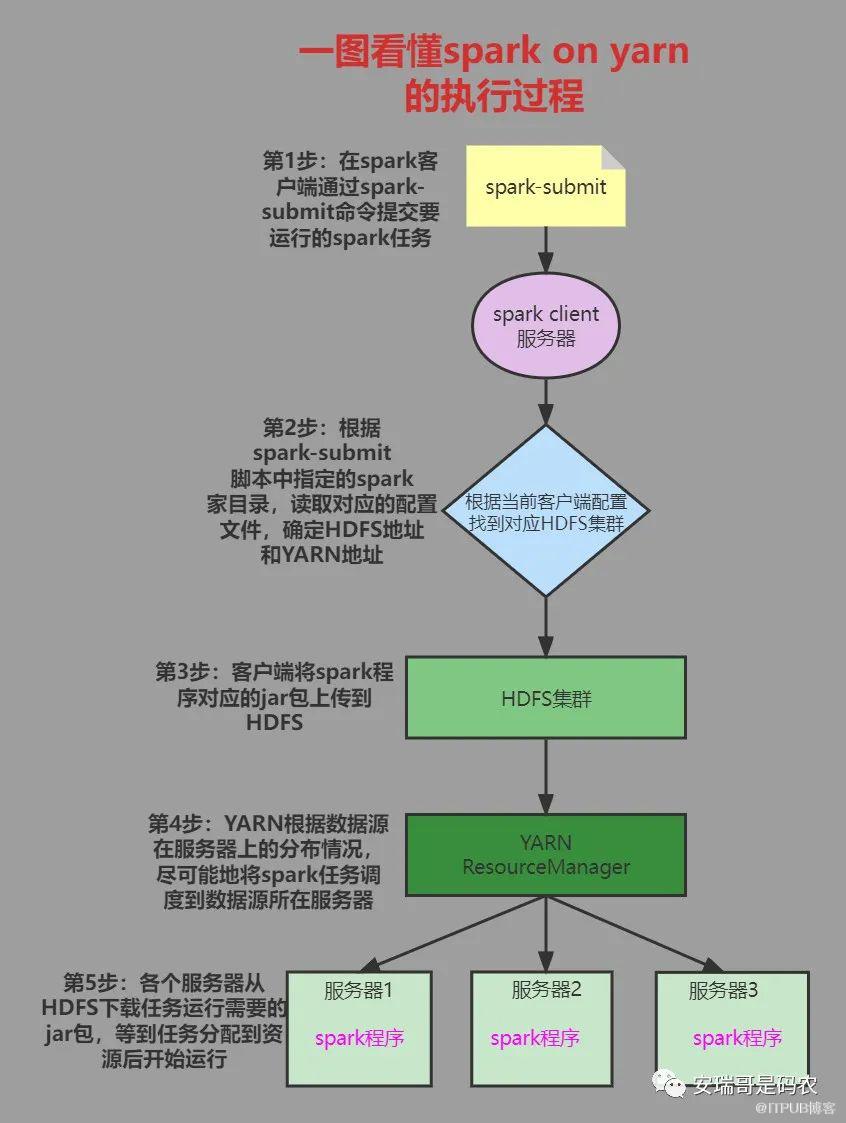
spark on yarn的执行过程
来,咱一步步来分析下:
当你在spark客户端敲下spark-submit时,因为spark-submit是个脚本,打开脚本里面的内容可以发现,它会先确定当前运行的spark版本,然后找到并运行spark-evn.sh脚本,确定spark的home目录、Hadoop的home目录以及对应的配置文件;
通过配置文件中配置的内容,确定hdfs的通讯入口、yarn的通讯入口,以及hive的连接方式等;
客户端将spark程序运行需要的jar包依赖上传到HDFS的staging临时目录,为分布式运行做好准备;
客户端连接上YARN的资源管理服务ResourceManager(后面简称RM),得知当前YARN集群当前的机器数量、资源使用情况等,然后找一台资源相对空闲的机器注册运行ApplicationMaster(后面简称AM),然后AM根据当前YARN集群资源剩余情况和当前提交的spark任务对资源的要求,并结合spark任务需要的数据源情况,尽可能向RM申请把spark的executor注册运行在有数据源的子节点中;
当确定了当前spark任务运行的机器以及角色分工后,AM就是当前这个spark任务的老大,管理当前这个分布式任务的生命周期,AM主要维护着SparkContext对象或者SparkSession对象,以及保存广播变量等,不参与业务数据的处理,当任务完成或者fail告知RM释放资源退出;
分析完了整个提交流程,咱再来看一眼一个spark任务提交的日志,看是不是这么回事?
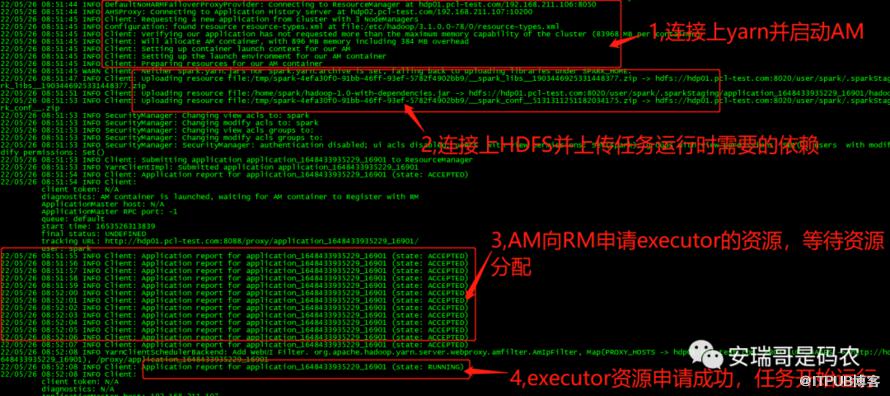
根据运行日志观察其运行步骤
从日志中的执行步骤可以看出,大致跟上面描述的一致。
object Spark2YarnRemotely {
    def main(args: Array[String]): Unit = {
        val conf = new SparkConf()
        val spark = SparkSession.builder().config(conf)
                .master("yarn")
                .config("spark.yarn.jars","F:\\Project\\demo\\spark-coding\\target\\spark-coding-1.0-SNAPSHOT-with-dependencies.jar")//提供yarn运行时的依赖
                .config("spark.hadoop.fs.defaultFS","hdfs://hdp01.xxx-test.com:8020")/**告诉程序,用来上传当前运行的jar包*/
                .config("spark.hadoop.yarn.resourcemanager.address","hdp01.xxx-test.com:8050")
                .config("spark.driver.host","192.168.25.220")//指定driver
                .getOrCreate()
    }
}

我知道很多同学在编写spark任务时,为了解决配置问题,喜欢一股脑将各个组件(hdfs、yarn、hive)的配置文件都放到项目的Resource目录下,来防止程序在运行过程中因为无法跟某个集群通讯,就像这样:

但是我不建议你这样,原因如下:
不够优雅,你程序的目的只是为了连上某个服务,你只需要告诉程序去哪个地址哪个端口通信就好了,没有必要拖上这么一大堆的配置,因为你实际上可能只是用到了其中的一到两个而已;
没有必要,因为比如yarn、hdfs、hive这些跟spark强联系的配置其实在你运行spark-submit的时候就已经加载到你任务的环境变量中了,无需再次指定(spark的conf目录已经有了);
这种胡子眉毛一把抓的方式,虽然最后问题解决了,但是你根本不知道是哪里的配置起的作用,还以为是自己英明神武呢,殊不知,你添加的配置文件可能根本就没有用上;
如果你会说,对于其他配置呢,比如spark写数据到Elasticsearch,ES这个配置怎么办呢?
很简单,直接在代码中指定,但不是让你在代码中写死,而是像这样:

用一个专门的配置类来管理,而这个配置类可以管理你大数据集群中用到的所有配置,而这个配置类再读取一个配置服务,这个配置服务会提供如下图这样的一个配置界面:
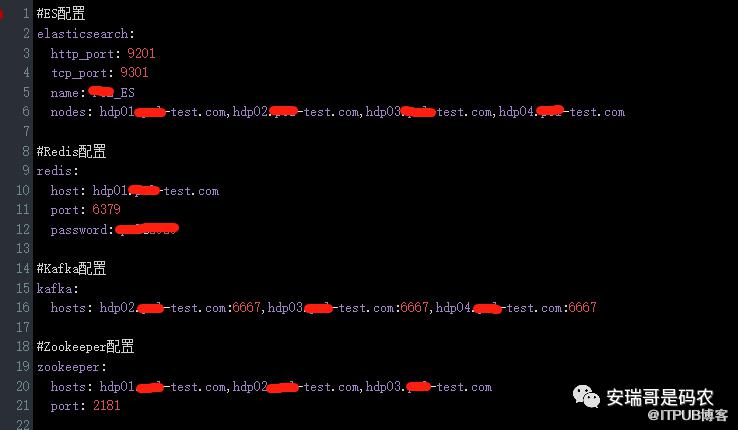
将集群中所有配置全部放在一个地方管理
通过这样一个服务来维护集群中所有需要用到的配置项,后续如果某个服务地址有更改,直接改这一个地方就可以了,与你的项目代码完全解耦。
这样,你就可以只用一套代码,运行在多个不同的集群环境中,无需因为集群环境的差异而对代码进行重复性修改,增加代码的灵活性。
至于这个配置服务怎么玩,我在下期文章中会展开讲。
任何一个计算引擎,之前的MR也好,现在的spark也罢,本质上就是一套SDK,只要有对应的jar包依赖,这个引擎就可以运行起来。
但是如果你想实现分布式,就必须要借助其他的手段,而yarn就是让其实现分布式运行的手段之一,也是目前最为流行的手段。
我知道很多同学虽然写过很多spark任务,也都在yarn上运行,但是清楚这其中的运行原理或者过程细节的恐怕不多,谨以这篇文章,希望对你理解该过程有所帮助。
还是那句话,你如果有任何相关问题,欢迎找我交流。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

