统计出每个上网的目的IP(target_ip),都是通过哪些客户端IP(client_ip)登录的,以及每个客户端IP的登录次数分别是多少?
需求很简单,一个SQL就可以搞定的事情,但是在现实场景中,大概率会出现某几个热门target_ip被特别多的客户端进行访问,其访问数量远超其他的target_ip,这个时候就出现了所谓的【数据倾斜】问题,如果数据量太大,你用普通SQL要么查询出来很慢,要么可能直接卡死或者OOM。
为了方便演示本次数据倾斜出现的问题,我用RDD作为本次数据处理的数据模型,因为如果你通过SQL语法本身是无法处理该问题的,这个时候,算子的优势就发挥出来了。
为了展示出对数据倾斜优化前后的对比,我通过优化前和优化的代码来做一个直观的比较。
|优化之前
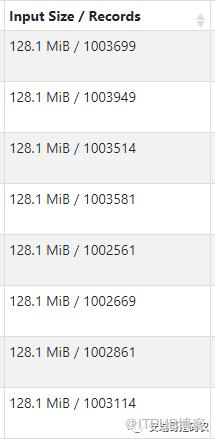
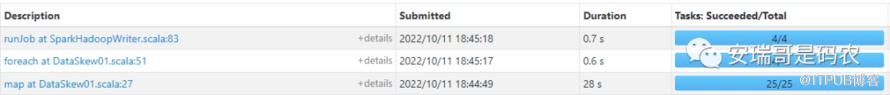
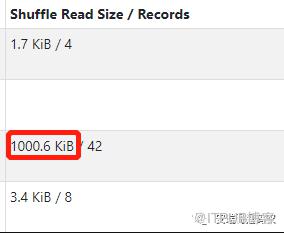
对于本次的需求,正常的做法都会通过target_ip进行分组聚合,然后将所有访问当前target_ip的client_ip进行聚合统计,最终得出结果,优化前的spark代码如下:
package com.anryg.bigdata.test.data_skew

import java.util

import org.apache.spark.{SparkConf, SparkContext}

/**
  * @DESC: 一个数据倾斜的例子
  * @Auther: Anryg
  * @Date: 2022/10/10 17:00
  */
object DataSkew01 {

    def main(args: Array[String]): Unit = {
        val conf = new SparkConf().setAppName("DataSkewTest01")/*.setMaster("local[*]")*/
        val spark = new SparkContext(conf)

        val rawRDD = spark.textFile(args(0))//读取数据源

        val filteredRDD = rawRDD.filter(line => { /**筛选满足需要的数据,已到达数据倾斜的目的*/
            val array = line.split(",")
            val target_ip = array(3)
            target_ip.equals("106.38.176.185") || target_ip.equals("106.38.176.117") || target_ip.equals("106.38.176.118") || target_ip.equals("106.38.176.116")
        })


        val reducedRDD = filteredRDD.map(line => {/**根据目的ip进行汇总,将访问同一个目的ip的所有客户端ip进行汇总*/
            val array = line.split(",")
            val target_ip = array(3)
            val client_ip = array(0)
            val index = client_ip.lastIndexOf(".")
            val subClientIP = client_ip.substring(0, index) //为了让后续聚合后的value数据量尽可能的少,只取ip的前段部分
            (target_ip,Array(subClientIP))
        }).reduceByKey(_++_,4)//将Array中的元素进行合并,然后将分区调整为已知的4个


        val targetRDD = reducedRDD.map(kv => {/**将访问同一个目的ip的客户端,再次根据客户端ip进行进一步统计*/
            val map = new util.HashMap[String,Int]()
            val target_ip = kv._1
            val clientIPArray = kv._2
            clientIPArray.foreach(clientIP => {
                if (map.containsKey(clientIP)) {
                    val sum = map.get(clientIP) + 1
                    map.put(clientIP,sum)
                }
                else map.put(clientIP,1)
            })
            (target_ip,map)
        })

        targetRDD.foreach(println(_))
        targetRDD.saveAsTextFile("/tmp/DataSkew01") //结果数据保存目录
    }
}

package com.anryg.bigdata.test.data_skew

import java.util

import org.apache.spark.{SparkConf, SparkContext}

import scala.util.Random

/**
  * @DESC: 一个数据倾斜的例子
  * @Auther: Anryg
  * @Date: 2022/10/10 17:00
  */
object DataSkew02 {

    def main(args: Array[String]): Unit = {
        val conf = new SparkConf().setAppName("DataSkewTest02")/*.setMaster("local[*]")*/
        val spark = new SparkContext(conf)

        val rawRDD = spark.textFile(args(0)) //读取原始数据源

        val filteredRDD = rawRDD.filter(line => { /**筛选满足需要的数据,已到达数据倾斜的目的*/
            val array = line.split(",")
            val target_ip = array(3)
            target_ip.equals("106.38.176.185") || target_ip.equals("106.38.176.117") || target_ip.equals("106.38.176.118") || target_ip.equals("106.38.176.116")
        })

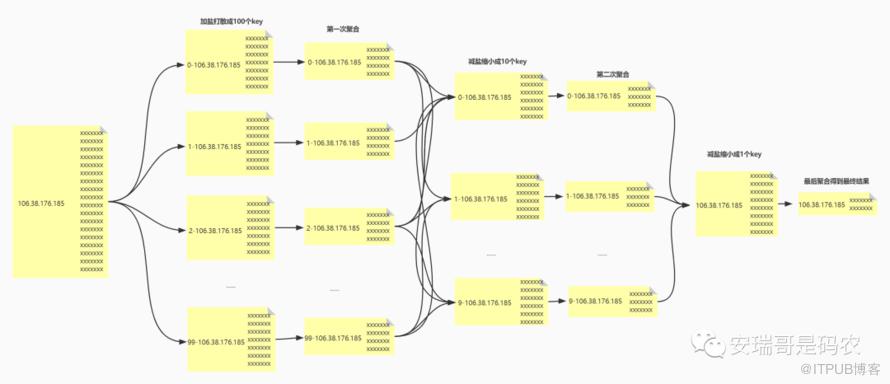
        val reducedRDD_01 = filteredRDD.map(line => {/**解决倾斜第一步:加盐操作将原本1个分区的数据扩大到100个分区*/
            val array = line.split(",")
            val target_ip = array(3)
            val client_ip = array(0)
            val index = client_ip.lastIndexOf(".")
            val subClientIP = client_ip.substring(0, index)//为了让后续聚合后的value数据量尽可能的少,只取ip的前段部分
            if (target_ip.equals("106.38.176.185")){/**针对特定倾斜的key进行加盐操作*/
                val saltNum = 99 //将原来的1个key增加到100个key
                val salt = new Random().nextInt(saltNum)
                (target_ip + "-" + salt,Array(subClientIP))
            }
            else (target_ip,Array(subClientIP))
        }).reduceByKey(_++_,103)//将Array中的元素进行合并,并确定分区数量

        val targetRDD_01 = reducedRDD_01.map(kv => {/**第二步:将各个分区中的数据进行初步统计,减少单个分区中value的大小*/
            val map = new util.HashMap[String,Int]()
            val target_ip = kv._1
            val clientIPArray = kv._2
            clientIPArray.foreach(clientIP => {//对clientIP进行统计
                if (map.containsKey(clientIP)) {
                    val sum = map.get(clientIP) + 1
                    map.put(clientIP,sum)
                }
                else map.put(clientIP,1)
            })
            (target_ip,map)
        })

        val reducedRDD_02 = targetRDD_01.map(kv => {/**第3步:对倾斜的数据进行减盐操作,将分区数从100减到10*/
            val targetIPWithSalt01 = kv._1
            val clientIPMap = kv._2
            if (targetIPWithSalt01.startsWith("106.38.176.185")){
                val targetIP = targetIPWithSalt01.split("-")(0)
                val saltNum = 9 //将原来的100个分区减少到10个分区
                val salt = new Random().nextInt(saltNum)
                (targetIP + "-" + salt,clientIPMap)
            }
            else kv
        }).reduceByKey((map1,map2) => { /**合并2个map中的元素,key相同则value值相加*/
            val map3 = new util.HashMap[String,Int](map1)
            map2.forEach((key,value) => {
                map3.merge(key, value, (v1,v2) => v1 + v2) //将map1和map2中的结果merge到map3中,相同的key,则value相加
            })
            map3
        },13)//调整分区数量

        val finalRDD = reducedRDD_02.map(kv => {/**第4步:继续减盐,将原本10个分区数的数据恢复到1个*/
            val targetIPWithSalt01 = kv._1
            val clientIPMap = kv._2
            if (targetIPWithSalt01.startsWith("106.38.176.185")){
                val targetIP = targetIPWithSalt01.split("-")(0)
                (targetIP,clientIPMap)//彻底将盐去掉
            }
            else kv
        }).reduceByKey((map1,map2) => { /**合并2个map中的元素,key相同则value值相加*/
            val map3 = new util.HashMap[String,Int](map1)
            map2.forEach((key,value) => {
                map3.merge(key, value, (v1,v2) => v1 + v2)
            })
            map3
        },4)//调整分区数量

        finalRDD.saveAsTextFile("/tmp/DataSkew02")
    }
}

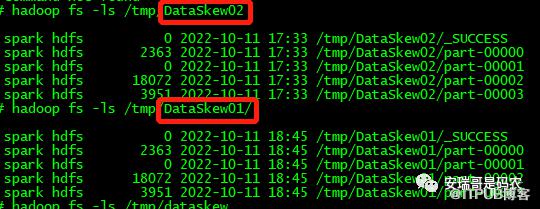
|最后
别以为这样一篇看似简单的案例实现起来很容易,因为既要考虑到场景的普适性、业务的易理解性,还要考虑到满足数据倾斜的条件,是需要提前对数据做很多准备工作的。
因此,我希望你读完这篇文章后,如果对数据倾斜的解决方案感兴趣,请务必要动手实践起来,因为只有实践起来,你才会发现解决这类问题其中的奥秘,否则,永远只能停留在概念上的纸上谈兵。
如果,你对本篇文章有任何疑问,欢迎找我交流,或者在讨论群里发表你的看法。
(PS:文章参考代码已同步到GitHub,欢迎下载)
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

