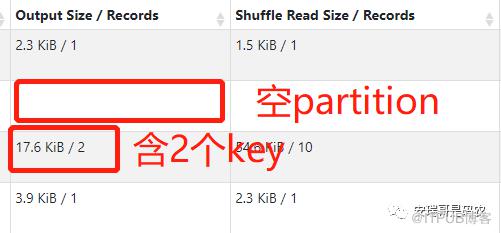
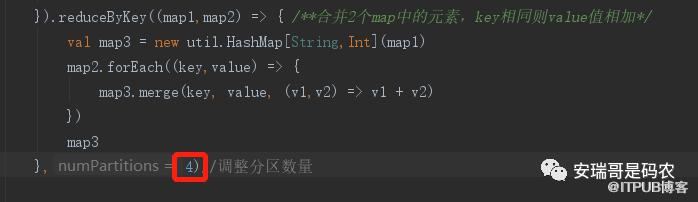
上一篇文章讲了个具体的解决数据倾斜的案例(大数据项目——解决数据倾斜的案例),很多小伙伴也都进行了实践。但我认为,最好的实践,一定是先看一遍我写过的代码,先理解我的思路,然后再自己去亲自实现一遍。在实现过程中,就不要去看代码了,完全根据自己的思考来,先甭管实现的好还是不好,能把代码跑起来,让结果出来,我认为你就成功了一大半。接下来就是优化的事情,要始终记住一件事情:好的代码一定是调试、优化出来的,不是一蹴而就的,如果你完成某个功能,代码写一遍就搞定了,并且毫无破绽,那只能说明这个功能过于简单,不是什么值得骄傲的事情。在上篇那个数据倾斜的案例中,其实有个地方是可以进一步优化的,不知道大家发现没有,最后的结果数据只有4个key,在最后的reduceByKey之后,这4个key进入了3个不同的partition中,也就是说有2个key进入了同一个partition中。
这样就导致虽然分配了4个partition,但是有1个partition是空的,从spark运行的UI也可以看出来:
那么这么来看,这个优化是不彻底的(虽然实际影响并不大),因为我们解决数据倾斜的目的就是为了让单个partition之间的数据尽可能的平均,如果能让这4个不同的key落地到4个不同的partition中是最理想的状况。
但是,这里必须有个但是,生产上就是这样的,会有各种意外情况发生,其中就有2个key落到同一个partition中了。那为什么会这样呢?这里就涉及到数据的分区策略问题,我在代码中虽然指定了用4个分区,原本想着让4个不同key各进入不同的partition中。

但是因为spark默认的数据跟partition之间的对应关系(分区策略),并没有按照我想象的那样去执行。数据跟partition之间的关系是:取key的哈希值,然后跟分区数取模,最后得到的数值就是partition id。
这样,每条数据就跟其partition绑定起来了,那么对于这个案例的4个key,他们的partition id分别是多少,代码逻辑如下:
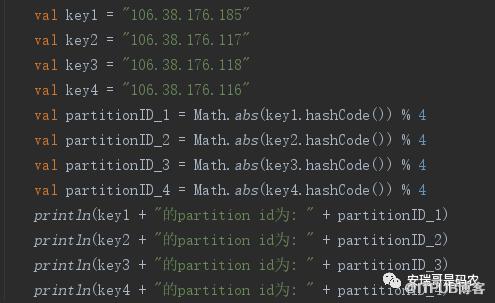
运行后,得到的key与partition id的对应关系如下:
可以看到,106.38.176.185跟106.38.176.116这两个key的partition id是一样的都为2,那我们来证实一下看最后数据输出的结果是不是符合这个逻辑:
从最后输出的结果来看,可以清楚地看到,数据文件的数量是根据partition个数来的,有多少个partition就会输出多少个数据文件,且文件名跟partition id一一对应,每个文件中的内容包含了与之对应的key的数据。清楚了数据的分区规则,那么如果我想让不同的key落到不同的partition中,该如何去优化呢?
作为思考题,留给你,我会在下一篇文章中写出我的解决方案。
但在此之前,我希望你能认真思考解决方案,因为这个,就是考验你如何对数据处理优化(spark调优)的能力,也只有这样,在面试中被问及解决实际问题的案例时,你才有话说。(提示:重写Partitioner,实现自定义的分区策略)
我这有一个高质量的大数据学习讨论群,不怎么扯淡、偶尔活跃气氛、大部分时间都在讨论技术,你在群里的几乎任何大数据相关的问题,都可以得到解答,要不要进来试试呢?拉你进群啊...
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。