上篇文章我写了 Zookeeper 的内部选举机制(),例举了 zookeeper 集群在启动之初的选举方式,以及启动之后,leader 挂了之后的选举方式。
可能大家对在集群启动之初,一台台节点启动过程中逐渐选出 leader 的步骤没有什么争议,因为整个过程的选举顺序清晰,规则严明。
但是对后者,当集群在运行过程中,leader 挂掉之后的选举方式,可能有些同学会有那么一点点不好理解透彻。
继续祭出这张图:
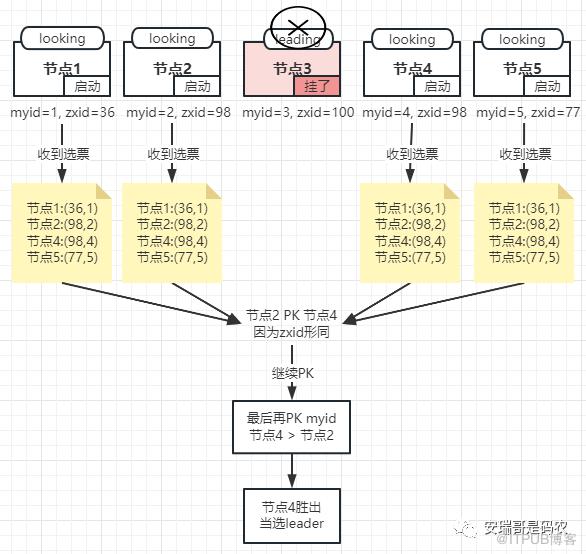
上篇文章说过,这张图是在一种相对理想的情况下,选出的 leader,也就是正好1、2、4、5这4个节点,能够在一个未超时的选举时间周期内,刚好彼此都收到了大家的选票凭证(zxid, myid),才选举出来的结果。
那假如我们现实中,万一出现个什么意外情况,假如节点4就是因为某些网络原因,导致它没法及时跟其他3个节点通信(在某个选举时间周期内超时),那么情况可能就变成了下面这样:
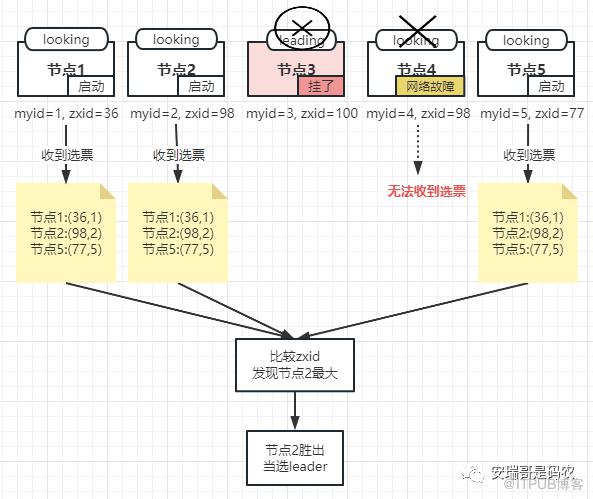
这个时候,leader 的候选人自然就变了,因为有3个人是正常的,且人家已经满足了投票过半原则。
当然,如果这个时候故障的是其他节点(1、2或5),情况也一样,只要满足过半原则,任意3个人就可以把谁是老大这件事给定了。
但是有的同学可能依然会疑惑,你现在就把 leader 给定了,那如果原来那个 leader 突然活过来了,咋整?
那就只能让他体验一把什么是“人走茶凉、物是人非”,你既然都跟大家玩失联了(通信时间超时),大家自然也不会一直等你,因为这个团队一开始就规定了(ZAB协议),老大失联多久之后就,就要重新开始选新的。
也就是说,即便当你再次回归团队,你也必须要认清现实,把姿态放低一点,先搞清楚状况,因为你不在的这段时间,指不定团队都发生了什么呢,如果说这个时候团队已经有了新老大,那你就只能识趣地去当一个 follower,老老实实的从小弟干起,后续再伺机翻盘。
而如果当你回归团队时发现,此时新老大还没有被选出来时,先别高兴太早,那仅仅只是大家在投票时意见没有达成一致,这个时候你要做的就是参与新的选举,因为你都挂过了,所以大家自然也就不那么信任你了,因此需要选新的(依然是ZAB协议约束)。
而对于其他中途挂掉的小弟也是一样的,它们恢复服务的第一件事就是,先搞清楚当下集群有没有老大,如果有,自己自觉成为 follower,而如果没有,那就参与到选举中,说不定自己有机会当选。
最后:
有球友要我说说 zookeeper 的ZAB协议原理,对于 Zookeeper 来说,ZAB的应用就体现在两个地方:
1,leader 的选举:上一篇跟这一篇都讲玩了;
2,数据的原子广播:也是就如何保证数据的强一致性,我放到了视频号,有兴趣可以看看:
对于这种两方面的技术,你要是想看这种纯理论的东西,网上很容易就搜到了。
但是那种一板一眼给你讲的技术内容,你真的能记住,能吸收吗?我表示一丢丢怀疑。
像这种复杂的,步骤繁多的大数据技术,个人认为想记住他们最好的办法,除了多实践验证之外,就是跟现实的生活场景进行类比,想办法让这些枯燥的技术原理沾染上一丝人性的温度。
这样,它才能与你的大脑皮层有种天然的亲和力,你也就更容易理解和记住它们。
还有就是,学习这种技术,特别不建议一上来就去看什么源码、论文,这些除了显示你装X之外,基本没有任何实际效果。
你觉得呢...
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

