前两天看讨论群里有小伙伴提起这两个概念,问它们分别是什么含义,以及他们之间的区别与联系。
确实,对于这两个概念的解释,网上有很多很专业的阐述,但是好像越是专业,越是很难让人听懂,貌似说了一大堆,但如果你看完,又好像跟没说一样。
那么这篇文章,我就想用自己的理解,来对这两个概念做一个相对通俗的解释,希望对你有用。
0.缘起
首先要知道,这两个表呢,都是我们数仓建模时,必须要考虑的两个重要概念。
对于数仓系统来说,目的就是存储和分析大量的业务数据,但是对于业务系统来说,它只管产生自己的事实数据,至于你怎么来把我这个产生的数据进行组织、归类,那是你数仓建模的事情。
那数仓建模该怎么建,表的内容如何分配,表关系如何确定,都需要根据当前系统的数据量、业务种类、数据特点等来设计。
1. 什么是事实表
从字面上理解,它就是用来反映业务系统产生功能行为时,对功能行为的记录,甚至说就是一种功能行为日志。
一个人在购物网站上买了件衣服,那么对应的就会产生一条购物行为数据,比如这个数据长这样:
(用户ID、用户名称、用户性别、商品ID、商品名称、商品种类、商品价格、购买时间、...)
再比如,对于一个上网监控系统来说,一个人在网上的所有浏览行为,鼠标的每一次点击动作,都会产生一条上网行为数据,比如这条数据长这样:
(上网设备IP、上网设备地理位置、网络运营商、访问的网站、网站性质、网站运营者、网站访问时间、网站响应时间)
以上这两个不同的业务系统,通过其系统功能源源不断记录业务事实而产生的,这种反映业务事实数据而形成的表,我们就把它就做事实表,因为这种数据的生成跟流水一般,源源不断,因此也常被叫做“流水表”。
拿上网监控系统为例,那么它源源不断产生的事实数据大致如下:

数据是我手动造的,可能没那么严谨
如果说你的这个网络监控系统本身很小,一天到晚也产生不了几条上网数据,那没什么好说的,你直接把这些数据一股脑灌到你的数据库中就可以了,根本就不需要什么表设计。
但是,万一你监控的是一个地区、一个城市、或者是一个国家的上网行为,想想这个数据量级,是不是得把你吓死。
那既然这样,我们就不能像刚开始那么蛮干,否则一味简单粗暴的入库,且后续的所有数据操作都落到这一个表里面,那这张大表早晚会被你干崩掉。
于是,咱必须得对该表的数据进行规划和设计。
2. 拆分策略
既然一张表的数据量太大,严重影响了对其查询和修改的效率,比如原本 qq.com 是一个即时通讯网站,如果突然某一天马化腾不开心,把它变成了一个电商网站(开个玩笑),那这个网站性质就得跟着变。
就需要对这个拥有超大数据量的表进行全量update操作,那这个效率你想想,估计会让你非常的酸爽。
那为了解决这一窘境,我们能想到的最好办法就是对其进行“拆解”,让它由大变小。
而对于一个数据库表来说,拆解一般有两种典型的思路:
一种叫横向拆解;
另一种叫纵向拆解;
所谓横向拆解:就是把一张表给横着“切一刀”,比如原本一张表有1亿条记录,切一刀之后,变成2张5千万条记录的表,表的字段数不变。
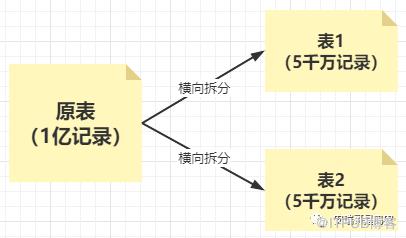
这种拆解方式呢,虽然能够有效减少单张表的数据量,让落到单个表的查询和update效率提升,但是表的数据总量其实没有变,而且它还带来了新的复杂度,那就是查询或者update的时候,需要提前对查询进行路由,要不然他查谁呢?
如果两张表一起查,那跟拆之前有什么区别。
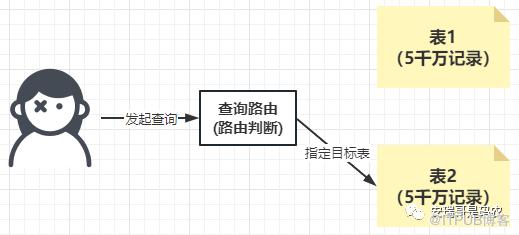
所以,这种拆解方式会多出一个中间路由的过程。
什么又是纵向拆解:所谓纵向,就是对表“竖着切”,切一刀或者几刀都行,通过减少原本表的字段数量来达到“瘦身”的效果。
但是这个切法需要观察表的特点,也就是看当前表的众多字段中,有哪些字段具有相同属性,或者表中的数据哪些会经常重复,我们可以把这种有着形同业务属性的字段,或者经常数据重复的字段给单独“拎出来”,形成新的表。
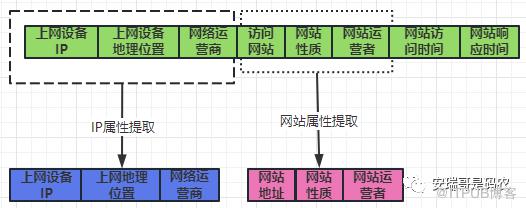
这种拆解方式最大的好处在于,除了可以有效减少单个表的数据量外,总的数据量也会随着减少,因为消除了很多重复数据。
缺点就是,每次在使用数据的时候,可能需要把之前拆出去的表数据给关联回来,有一定的性能损耗。
今天,咱们重点来讲第二种,纵向拆分法。
2. 什么是维度表
这里不想直接解释维度表的概念,因为太生硬,咱继续上面的内容。
我们在拆的时候会发现,其中前3个字段:上网设备IP、上网设备地理位置、网络运营商,它们完全属于IP信息的范畴,因为只要一个IP确定了,那么它的对应的地理位置,以及网络所属的运营商就确定了。
同时,对于:网站地址、网站性质、网站运营者,这3个字段也同属于网站信息的范畴,因为一个网站地址如果确定了,那么它这几个信息也是确定的。
而且从表中数据来看,里面还有大量的数据重复内容:
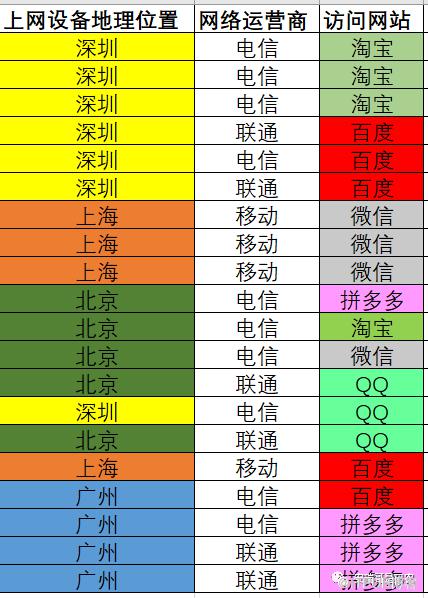
基于这两点,将这份上网行为数据进行纵向拆分的理由,就非常充分了。
那么将这份上网行为数据根据刚才分析的,就可以将原本的1张表,给拆分成如下的3张:

而拆分之后的IP信息表,和网站信息表,因为分别隶属于IP维度,和网站信息维度,所以我们也把这额外的2张表叫做维度表。
细心的同学可能发现了,这个IP信息维度表的字段,跟之前的原表字段并不完全一样,由上网设备IP给改成了IP范围。
原因很简单,如果我们把所有的IP地址跟其地理位置和运营商信息,都一条条存储到IP信息表中,那么这张表得极其巨大(考虑到光IPv4就有256^4个不同IP,你受得了吗)。
而IP跟地理位置,以及运营商信息,通常都是一段段对应的,如果用这种方式去存储的话,那么存储的数据量就可以呈指数级下降。
但是,不知道你有没有发现,这个IP信息表是不能用普通的数据库来直接存储的,因为按照普通的数据库关联操作,你是不能将一个具体的IP地址,跟一个IP范围段进行join的。
比如,你的原始数据表中的IP地址为:192.168.10.16,但是你的IP信息表里面只有: 192.168.10.1-192.168.10.255 这个IP范围,因此你没有办法直接关联。
那怎么办呢?
可以查看我的大数据实战项目,其中对于IP信息的维表就是这么设计的,需要放到一种树状数据结构中,来解决这种范围查找问题。
(PS: 你可以把这部分操作,作为优化你大数据项目中的亮点,写到简历中)
3. 总结
从这个例子中我们可以发现,所谓事实表就是能直接反映业务行为事实的表,它的数据是实时产生和动态变化的。
而维度表,则可以理解是用来辅助对事实表中的数据加以说明,补充的,是对事实表数据的一种延伸,它的特点就是数据量相对较小,且相对静态、不轻易变化。
以上是我自己给事实表以及维度表下的定义。
你同意吗?

原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

