昨天聊到了数据库建模过程中,关于事实表跟维度表的联系与区别,那么今天咱再来掰扯掰扯,跟数据库的存储格式相关的问题。
我们知道,对于一般的数据库来说,数据存储格式分为行存储,以及列存储。
对于行存储,多半适用于传统关系型数据库(RDBMS),也就是OLTP系统。
而对于列存储,多半适用于非关系型数据库(NoSQL数据库),也就是OLAP系统。
但是如果你是做大数据开发的,你一定还见识过另一种特殊的数据库—Hive(这个我在之前的一期视频里对hive的特性做过阐述,有兴趣的同学可以去看看)。
如果你把hive当做数据库来理解的话,它的特殊之一在于,这玩意能够支持多种不同的数据存储格式,用的最多的有:ORC、Parquet、TextFile。
其中ORC跟parquet是列式存储自不必多说,但是你觉得TextFile,它是什么存储格式的呢?
有同学说是行存储?真的吗?
0.
不知道你有没有留意,不管是我们正常的行存储,还是列式存储,它都是针对的那些“正经数据库”。
比如传统的MySQL(行存储),Hbase(列存储),他们都有一个共同的特点:如果想往其中存储数据,你需要通过特定的存储API写入才可以,而且写入之后的数据,是没有办法直接查看的二进制文件。
也就是说,无论你的数据写入是行存储格式,还是列存储格式,数据在写入磁盘之前,必须要经过“特定的组织”才可以,只有你把他组织成一行行,或者一列列的形式写入数据库。
它才是行存储格式的,或者列存储格式的。
1.
那么这些行存储或者列存储,对应到磁盘中的位置是什么样的呢?
我们知道对于任何一块磁盘来,或者说文件系统(将磁盘进行格式化,就成了文件系统),它上面都是有一个个规划好了的“格子”的,类似我们装衣服的衣柜,如果你想把数据存进去,就必须根据这些“格子”的规范来存储。
对于一般的Linux文件系统来说,当你在格式化磁盘的时候,如果不做特殊说明(比如ext4文件系统),这个格子大小一般为4KB,你可以通过命令来查看:

也就是说当你的数据“塞满”4KB之后,就必须往另一个格子去塞。
假如有这么一份数据,有3个字段,为了方便后续说明和演示,我们假设(注意只是假设)第一个字段的每个值大小为1KB,第二个字段的值为1.5KB,而第三个字段的值为0.5KB:
| Name |
City |
Age |
| Matt |
Los Angeles |
27 |
| Dave |
San Francisco |
30 |
| Tim |
Oakland |
29 |
| Jim |
NewYork |
17 |
2.
对于这样一份业务数据,如果是行存储,那它在硬盘中应该是怎么摆放的呢?

行存储在磁盘中的示意图
因为行存储是根据“行”为单位进行组织,因此对于1个block(每个为4KB)来说,只能存储“行”的整数倍,所以就会出现图中每个block剩余1KB空间的情况,且这个空间无法后续利用,因此对行存储来说,空间会显得有些浪费。
但它优点就是,每次取数据的时候,如果是想查询若干行的数据,IO效率很高,因为你取的数据本身就是根据“行”组织好的。
3.
那如果这份数据是用列存储,那它在硬盘中的摆放位置又是什么样的呢?
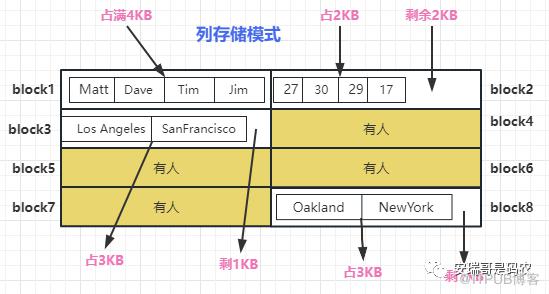
列存储在磁盘中的示意图
对于列存储来说,一个“列”的数据就是一个集体行动的单位,他们总是抱团出行,如果一个block塞不下,才不得不分开给塞到另一个block里面,但是相对于行存储来说,他们每个block的空间并不会直接被浪费掉。
比如对于保存age的列来说,当前block还剩2KB的空间,如果这张表还有后续数据插入的话,依然是可以接着往后面写,把剩余的这部分空间给利用起来的,但是行存储就做不到这一点。
因此列存储在空间利用率上,理论上要比行存储要高很多,而且因为以列为单位,其数据类型一样,更利于以“列”为单位的数据分析业务(OLAP)。
4.
现在我们来想想,对于这种没有任何“数据组织”形式的Text来说,它在磁盘中的存储应该是什么样的呢?
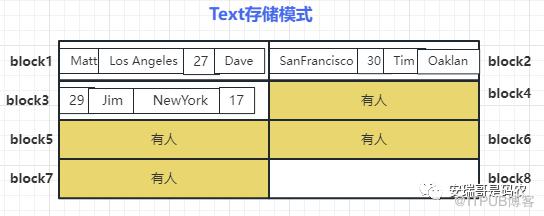
没有进行任何组织的存储方式
像这种普通的Text数据文件,我们一般的做法,要么就是通过流的方式给写到磁盘中,要么就是通过copy的方式直接给复制到磁盘里。
这里需要注意的是,因为是Text格式,那么就根本不存在所谓的数据类型差别,大家都是类型一样的字符。
而又因为它的存储根本就不存在所谓的“数据组织”形式,只能以磁盘的block为单位,“一坨一坨”地挨个去保存,一个block满了,就移步到下一个,对磁盘空间的利用率非常的高,所以它既不能叫行存储,也不是列存储。
这也是为什么,我们如果在Text格式的数据中查询目标数据时,有仅只有一种办法:那就是把它全部读取到应用程序的内存中之后,再对其进行时间复杂度为O(n)的匹配。
这种存储方式,程序只能通过“全量IO”来检索你想要的数据,想想如果你的hive数据保存的是textfile,是不是查询起来要比orc或者parquet慢很多。
5.
以上,是我对行存储、列存储,以及普通text文本存储数据格式的理解,并不一定十分准确和严谨。
但希望能透过我的这些解释,能够帮助你对数据库底层的各种数据存储格式,有一个更加深入和全面的理解。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

