有段时间没聊技术了,再不提及一下,恐怕你们都忘了这原来是个技术号。
前段时间有球友提及 zookeeper 相关的一些问题,于是就想着把这块相关的知识点给复习一下。
0.
zookeeper 在整个大数生态中是一个比较“特殊”的存在,特殊在哪呢?
它是因为别的分布式系统存在,而存在的这么一个技术组件,专门用来解决分布式系统中出现的各种“矛盾纠纷”问题,是一个公平公正的“第三方机构”,有点类似我们现实生活中的“法官”,或者“热心邻居”的角色。
zookeeper 第一次进入大家的视野是作为一个“协调者”身份(coordinator)而出现在大数据技术中的,因为只有分布式系统这种具备复杂架构的软件,在运行过程中才会涉及到诸如:角色分配、元数据管理等等复杂问题。
我们知道,zookeeper 其中一个非常重要的功能,就是用来选举分布式系统中的 master(一把手),确定哪个是 active master,哪个是standby master的,也就是解决所谓的脑裂问题。
(PS: 至于什么是脑裂问题,可以去看我视频号中有一期对脑裂问题的解释)
也就是说,分布式系统为了防止脑裂问题的发生,又引入了一个新的分布式系统 zookeeper,但因为 zookeeper 也是这种 master-slaver架构,于是也会有类似这种分布式系统存在的担忧。
这种设计思想,颇有一种“弃车保帅”的战略意味。

那既然这样,zookeeper 又是如何防止自己发生脑裂的呢?这将是这篇文章接下来要聊的重点。
1.
如果说 zookeeper 本身不能很好的解决“脑裂”这个问题,那贸然引入它,就陷入了一个类似“鸡生蛋、蛋生鸡”的死循环中。
对于 zookeeper 的设计思想,如果跟传统的分布式系统一样,也是通过配置文件来指定,谁是“老大”,谁是“小弟”的这种方式,那一旦配置多个老大(传统分布式系统的方式),决定谁为主,谁为副,则又需要引入另一个第三方机构来裁决,这就陷入了一个死循环。
于是,zookeeper 在选举自己的“老大”时,用的是另一种设计思想,不用在配置文件中指定,也不用额外引入“第三方机构”,自己在集群启动过程中,以及“老大”挂了之后,内部会通过一种“民主选举”机制来搞定谁是“老大”,谁是“小弟”的问题。
于是,zookeeper 就是通过这种机制,斩断了这种“蛋生鸡、鸡生蛋”的依赖链。
要想把 zookeeper 自己内部的选举机制说清楚,咱得从下面几个方面来着手讲:
zookeeper的角色
在说其选举机制之前,不得不聊一下zookeeper各个节点承担的角色,以及对应的角色状态,因为是他们的存在,才构建了 zookeeper这样一个健全、健壮的协作体系。
leader:zookeeper 集群中的“老大”,提供集群的所有写请求和读请求,在成为leader前,有参与投票权,无论你的 zookeeper 集群有多大,它只会有一个,而且这个leader是动态指定的,具体是谁,你得看人家怎么投票的;
follower:zookeeper 集群中的“小弟”,只提供读请求,不提供写,有投票权,如果不小心收到了写请求,会将请求转给leader,自己不管。同样的这个角色也是动态指定的,一旦leader确定了之后,剩下的自动成为follower;
observer:zookeeper 集群中的“小小弟”,有点像follower小弟,但是却比它身份更加的卑微,只有提供读数据的义务,而没有投票选“老大”的权利,百分之一百的付出型选手,有点可怜。
对于observer这个角色的介绍,很多文章都介绍得都很模糊,这里就多说两句:
之所以要引入它呢,目的就是为了在不降低集群写效率的情况下,同时还能提高集群的读请求量,但是因为这个角色比较特殊,它并不是集群在启动过程中投票决定的,而是需要你在配置文件中指定,明确告诉它:你,给我当observer。
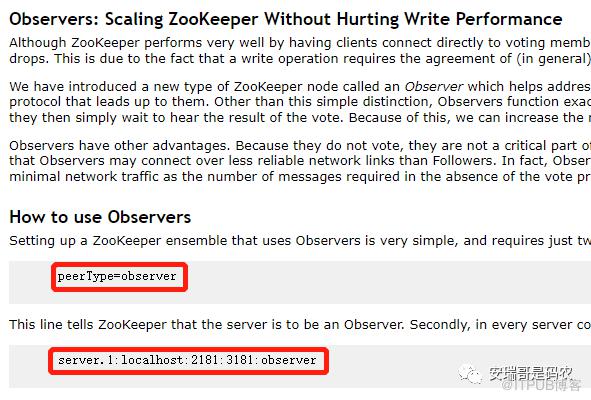
因为 observer 没有投票的权利,所以它对集群的影响可谓是“有百利而无一害”,挂掉了,丝毫不影响集群的稳定性,正常运行,则可以提高整个 zookeeper 集群的读效率,活脱脱一个雷锋人设。
zookeeper的状态
其实 zookeeper 的状态,跟上文提到的角色是一一对应的,有对应的leading、following、和observing,3种角色对应3种不同的状态,合情合理。
但是,你要知道以上说的3种状态,是在集群已经角色确定,正常运行的情况下有的,那如果我的集群只是刚刚开始启动,或者leader突然挂掉,让集群处于一种角色不确定(leader不确定)的情况下时,该怎么办?
于是,就引入了第4种状态:looking 状态。
意思是,我还不知道自己是个什么东西呢,正在寻找自己的“定位”,于是当集群还没有确定谁是leader的情况下,所有的节点(除observer外),都是looking状态。
zookeeper 在looking状态下,因为群龙无首,啥也干不了。
于是这个时候,就需要通过 zookeeper 的“选举机制”,把leader给投票出来。
zookeeper的选举机制
这里的选举,其实跟我们上学时候选班长原理是差不多的,也是少数服从多数(过半原则)。
我们那会选班长,比的是谁学习成绩好,以及谁比较有人缘,那这个zookeeper 集群选leader,也是根据两个指标,一个是zxid,另一个叫myid。
先来看什么是myid:
它是 zookeeper 集群中各个节点的编号,这个编号是在集群第一次启动之后就确定了的,不用额外配置,且后续不再变动。

再来看什么是zxid:
它代表着每个 zookeeper 节点的事务处理编号,因为每个节点所接受的读或者写请求数量是不一样的,因此每个节点上的zxid编号也会大概率不一样。
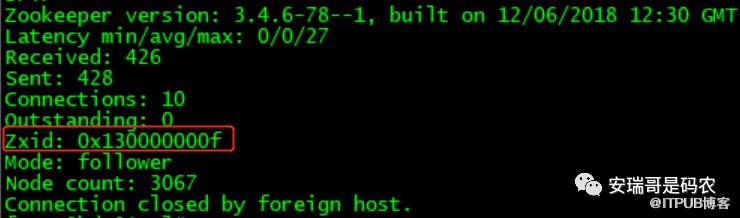
网上很多查看这个zxid的文章都是错的,这才是正确的姿势
因为每个节点接受的客户端请求数量在一直增加,因此,这个编号也是一直在动态变化的(越来越大)。
了解了这两个选举凭证,那选举的具体条件又是什么呢?
先节点间比较各自zxid的大小,谁最大就选谁当leader,如果zxid一样大(比如集群刚从关闭状态启动的时候),那就再比较myid的大小,谁大,就选谁,且除observer外(没有选举权),只要票数过半就最终通过,没有被选上的人,则自动沦为follower。
为了进一步搞清楚这个过程,咱从两个不同条件出发来描述一下:
1. 集群从关闭状态启动时
这个时候呢,zookeeper 中的节点一定是一台一台按照顺序来启动的,那么在这个过程中,它是怎么投票的呢?
咱来看下面这些图,相信你一眼就能瞅明白,因为这个过程不涉及到observer(没有投票权嘛),因此图中不会出现这个角色:
1.1 当第1个节点启动时:
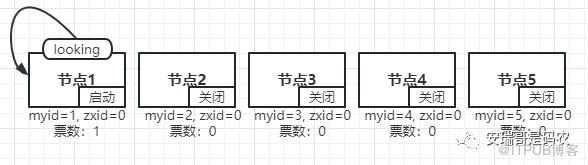
myid是真实的,但是zxid现实中不可能为0,但是初始值都是一样的,这里只是示意
节点1发现就自己活着(跟其他节点通信不了),没有leader,于是把自己的状态设置为looking,投自己一票(没别人了呀),但是因为集群有5个节点,没有办法完成过半投票的规定,因此leader选不出来,本次投票作废,继续...
1.2 当第2个节点启动时:
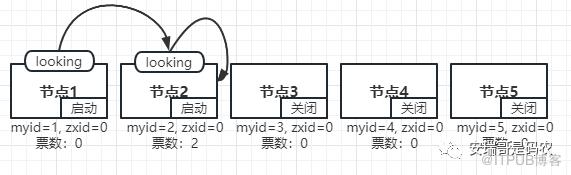
当第2个节点启动时,它也发现没有leader,于是也把自己的状态设置为 looking,然后跟节点1一起投票,他俩分别把自己的zxid和myid通过小纸条递给对方,发现zxid一样的,完蛋,于是只能比myid了,发现节点2的myid最大,于是都把票投给节点2。
此时的节点2就有了两票,但是依然不够半数(5个节点要3票才可以),于是宣布本次投票失败,继续...
1.3 当第3个节点启动时:
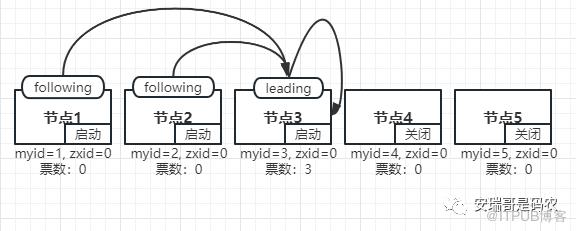
这个时候,节点3发现也是没有leader,于是也把自己的状态设置为looking,然后跟节点1和节点2一起开始投票,同样的,大家彼此通过传小纸条得知3个人的zxid和myid,最后发现节点3的myid最大,于是就把票投给了节点3,同时这个时候满足了票数过半原则(大于等于3),于是节点3顺利当选leader,投票停止。
节点3被选上leader之后,自然非常的开心,然后就理直气壮的把自己的状态给设置为leading,并告诉其他节点1、2说:我已经是leader了,叫大哥。于是节点1、2就识趣的把自己的状态给改为 following,从此听候节点3的差遣。
1.4 当第4,5个节点启动时:
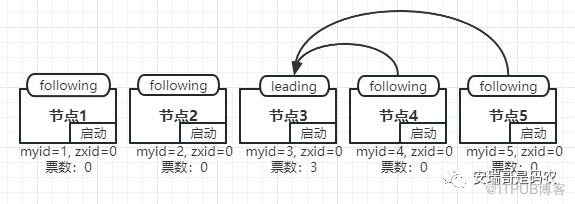
由于在节点3启动之后,leader已经被选了出来,整个集群大局已定,于是节点4和节点5,在收到当前集群已经有 leader 这个信息后,也都识趣的把自己的状态改为following,成为新的小弟。
以上,是zookeeper集群从关闭到启动过程中leader的选举过程,那假如集群在运行过程中,突然间leader挂了,这个选举又怎么进行呢?
2. 集群运行过程中leader挂掉
当 zookeeper 在运行过程中,突然因为网络故障,或者硬件原因导致的leader进程挂掉,这个时候,集群就变得群龙无首,无法对外提供服务。
这肯定是不行的,于是新的一轮民主选举即将拉开帷幕,怎么整呢?
因为leader一挂,所有跟他保持通信的小弟(follower)瞬间就知道了,怎么办?原地哭吗?当然不是,好不容易老大这个位置空出来了,大家都想去抢。
于是新的一轮投票就又开始了。
跟上面集群在启动过程中的投票方式有点不太一样,因为所有的 follower 现在都是启动状态,于是它们只需要做下面几件事情:
第1步:把自己的following状态马上改为looking,代表当前团队群龙无首,大家正在寻找新的接班人;
第2步:马上把自己手里的投票凭证(zxid, myid)发送给其他小弟,并同时接受其他小弟发给自己的投票凭证;
第3步:根据手上的投票凭证,然后选出谁才是真正的leader。
来,我们看下面这个图:
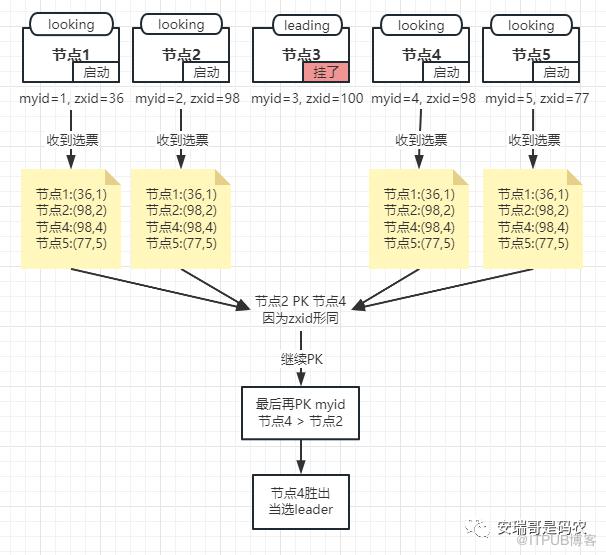
从图中可以看出来,最终节点4获得leader的当选资格,但是上图是我简化之后的一个流程,实际流程比这要更复杂一些。
因为每一个节点不可能是在同一时间,同时收到其他所有节点的投票凭证的,在实际实现过程中,只要收到了投票凭证它就开始投,且只要服从过半原则就可以决定leader是谁。
但我觉得不重要,先搞清楚大致原理,有兴趣的话,再下去深挖技术细节。
2.
你可能会问,为啥选leader的条件是先比较zxid,而且选最大的那个?
我是这么想的,zxid越大,代表着这个节点接受的请求量越大,那为什么请求量越大呢?大概率是因为它的硬件资源、网络状况、系统负载状况、请求响应时间都优于其他节点。
正所谓能者多劳嘛,既然你能承担比别人多的工作量,那么leader这杆大旗理应由你来抗。
如果zxid一样了,那为了最终选出这个leader,就只能找另外一个参考指标,那就是myid,因为它是确定的,而且节点之间一定会不一样。
所以这两个条件的组合,就一定可以把leader选出来。
3.
看完整篇文章,你会发现,咦?怎么都没有提ZAB协议呢?
其实以上的投票过程,就是ZAB协议应用的过程,只不过我不想用那些生涩的文字进行描述,没劲。
希望通过以上文字的描述,能让你对 zookeeper 集群的内部选举规则,以及为什么它可以防止脑裂问题,有个比较清晰的认识。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

