(PS:这是我的实战大数据项目最新一期的更新内容)
在这个大数据实战项目中,给定的原始数据里,有几个外网IP字段,而这个IP字段我们知道,它是可以延伸出一些跟它相关的维度信息的。

比如跟IP地址绑定的有地理位置信息,这其中包括国家、省份、城市,另外还有对应的运营商,这样一来就可以让原本的数据扩充更多的有用信息。
但是IP这个信息相关的维度,并不能像我们普通的维度表那样,保存在普通的结构化数据库表中,因为我们不能让事实表中的IP跟维度表中的IP一一对应。
原因在于,IP地址是一个非常庞大的数据集合,拿IPv4来举例的话,要知道,每个IP占用4byte,而每个ip位占用1byte,其取值范围为0-255,那么所有IPv4的总和就是256^4,约40亿+条数据,你要是把这些记录都用普通方式存储到一张表里面,那在使用的时候再通过ip字段join关联,你可以想象那样会带来多大的性能损耗。
关键像IP地址跟地理位置的关系,一般都是以IP段范围来一一对应的,也就是某个区间范围的IP,会对应相同的地理位置信息,比如像这样。

1. 对其数据结构的思考
如果我们能直接通过存储这种IP范围跟地理位置的信息,并且还能支持我们单个IP对其地理位置查找的话,那么我们要存储的数据量就一下子少了太多太多。
而像这种数据结构的查询,就需要动用我们的算法思维了,而基于这种范围的查询,我们第一个想到的就是二分查找,对于二分查找来说,第一步就需要排序,而且排序跟查找的算法都需要自己来写,这个对于开发来说,工作量有些大,而且二分查找说起来容易,真正要写出没有bug的二分查找,在现实中并非易事。
那我们能不能换一种思路,比如用一种可查找的树形结构来存储这些数据,因为可查找的树形结构本身在数据写入过程中就是排好序的,那么对于后续的查找来说,根据其排序规则查找起来就非常容易。
而且我们能不能直接找到支持这种树形结构的软件,通过把数据直接写进去就能把问题解决呢?
有,Redis的zset就支持这种数据结构。
zset我们知道,它本质上是一个skiplist,也就是刚才我们说的支持查找的树形结构。

可以看到,除开最后一排蓝色框框的是数据体外,上面红色框框的都为索引,而我们可以利用这种数据结构,将IP的地址作为索引,然后整条记录作为数据体。
这样一安排,我们就可以根据需要的IP地址,利用这种数据结构,找到对应的地理位置记录。
2. 写入Redis的zset
确定好方案后,我们就开始将数据写入到Redis的zset数据结构中,IP范围跟地理位置的关联数据格式如下图所示(其实是我将几份IP跟国家,IP跟城市,IP跟运营商的数据文件关联之后生成的这份数据):
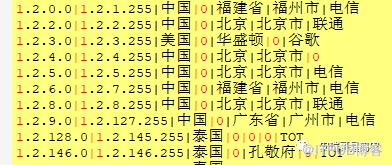
大概数了一下,一共约65万条,也就是说这65万条数据集就可以囊括你对40多亿个IPv4的查询要求,而且这点数据量对于Redis来说,也根本不在话下,是不是屌爆了。
将这个数据文件ip.merge.txt写入到Redis的zset代码如下:
/**
     * @DESC: 将本地ip.merge.txt文件中的IP地址导入到redis zset中
     * @param filePath : IP地址与地理位置关系文件
     * @param dbNo : redis的数据库名
     * */
    public static void ipCountryImport(String filePath, int dbNo) throws Exception {
        FileInputStream inputStream = new FileInputStream(filePath);
        BufferedReader bufferedReader = new BufferedReader(new InputStreamReader(inputStream));
        String line = null; /*读取文件中的每一行*/
        HashMap<String,Double> map = new HashMap(1024,1); //key为数据体,value为ip范围的结束ip地址
        int i = 0;
        while((line=bufferedReader.readLine()) != null){
            String[] args=line.split("\\|");
            String ipStart=args[0];
            String ipEnd=args[1];
            //Long ipStartLong= IPUtils.ip2Long(ipStart);
            Long ipEndLong= IPUtils.ip2Long(ipEnd); //将每条IP地址范围的结束IP地址,转换为long类型的数值
            String country = args[2];  //获取国家信息
            String province = args[4]; //或者省份信息
            String city = args[5];  //获取城市信息
            String operator = args[6]; //获取运营商信息
            StringBuilder rowBuffer  = new StringBuilder(11); //用来存放组装后的IP地址与地理位置信息
            rowBuffer.append(ipStart).append("-").append(ipEnd).append("-").append(country).append("-")
                    .append(province).append("-").append(city).append("-").append(operator);
            map.put(rowBuffer.toString(),ipEndLong.doubleValue());
            ++i;
            if (i == 1024) {/**每1024个为一批*/
                toRedis(RedisClientUtils.getSingleRedisClient(),map, dbNo,"ipAndAddr");
                map.clear();
                i = 0;
            }
        }
        if (map.size() > 0) toRedis(RedisClientUtils.getSingleRedisClient(),map, dbNo,"ipAndAddr");
    }
这部分代码已经更新并提交到原来的GitHub地址,有需要的同学可自行下载,至于这个IP范围与地理位置信息的数据文件,需要你私信我才能发给你哈。
(https://github.com/Anryg/internet_behavior_project.git)
3. 查询效果
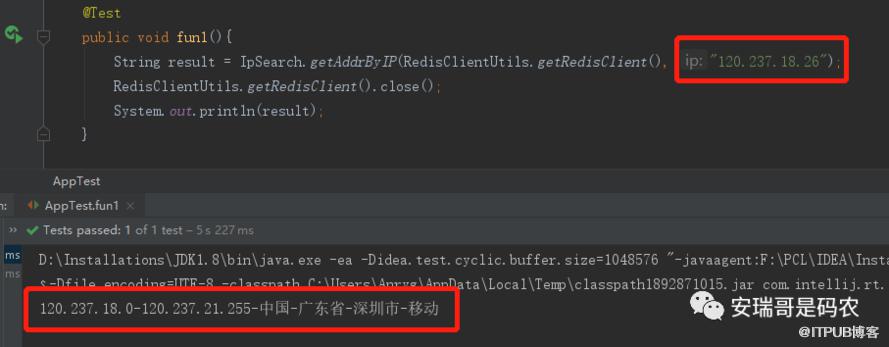
既然数据已经写入到Redis中,那么我们就可以根据Redis的zset特性对其中的ip地址进行查询测试,比如我们拿 120.237.18.26 这个IP测试,通过API,测试结果如下:
我们再来通过IP地址查询网址,来验证一下这个IP的地理位置信息是否正确:
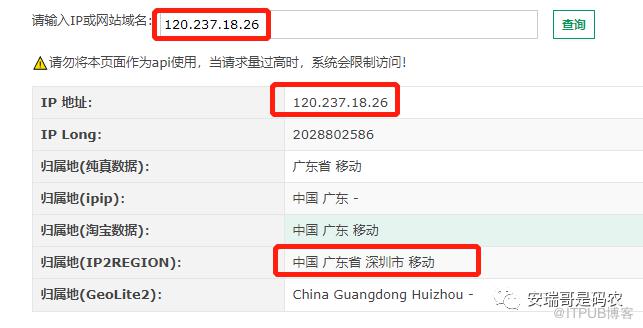
可以看出来,这个通过Redis的查询结果跟在线的查询结果一致(经过我的项目使用经验证明,这个方式的查找结果完全可信)。
从这个网站的页面提示可以看出来,它其实是限制了你对ip查询的次数的,也就是说,如果你的应用是在一个相对高并发的情况下用这种方式进行查询,那不好意思,这招恐怕行不通。
另外,我还看到现在网上有一个专门开源的包,也是可以通过调用Java api的方式来查询IP对应的地理位置信息,虽然能满足功能,但是其使用方式过于单一,无法支持多场景多API的情况。
但是,如果你能把这部分的数据通过这种“自建”后台数据库的方式,那么就不会有任何访问的限制,将足够应对你的高并发需求,以及适配其他编程语言的API,而这就是当前方案的最大优势。
4. 最后
我们需要思考的是,对于不同场景的维度数据,需要根据其数据特点进行合理的存储,以及对应的使用。
希望通过这个案例,让你对维度表数据的使用方式有个新的认知。
最后,如你正在做我的这个实战项目,希望你能够认真对待,用心挖掘其中的亮点,把它作为你的实战项目经验,为你的面试加分。

原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

