上篇文章讲到,在我的大数据实战项目中,我们把IP关联的地理位置信息给存储到了Redis的SkipList中。
那么这篇文章,咱再来讲讲该如何通过分布式计算引擎,去使用存储在其中的数据?
因为这个数据是存储在Redis数据库中的,所以我们只能在计算引擎内部,通过跟数据库先建立连接,然后再通过Redis的数据读取API,来查询到我们的目标数据。
方法论很简单,但是,这里面比较难处理的,就是这个数据库的连接问题,对于一个大数据应用来说,如果你的分布式计算引擎在使用过程中,需要跟查询第三方数据库不断地有读写交互,那么如果这个连接管理没有做好的话,会直接导致你的分布式计算引擎在数据处理过程中效率缓慢,或者因为连接数太多而导致数据库崩溃。
0. 应用场景
来看这个实战项目的一个具体应用场景,数据处理流程如下图所示:
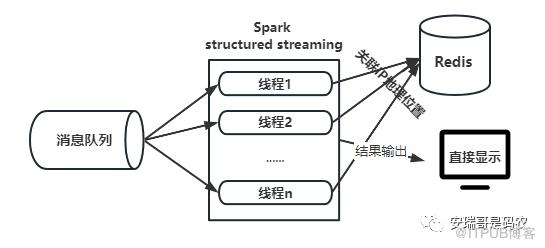
这里为了简化,我通过structured streaming读取kafka消息队列数据,对数据做一个简单的处理后,然后通过每一条数据的IP地址信息,直接关联Redis中IP的地理位置数据,最后直接通过控制台输出(当然,你可以为了实际需要把结果写其他数据库)。
对于这个简单的场景,代码怎么来写呢?
1. 优化前的代码
你现在能看到在GitHub上的关于Redis的工具类代码,主体部分是这么写的:
public class RedisClientUtils implements RedisParam {
    private static volatile JedisPool jedisPool = null;/**用连接池进行管理*/
    private static volatile Jedis jedis = null; /**使用单例客户端*/

    /**
     * @DESC: 初始化连接池
    * */
    private static void initPool(){
        JedisPoolConfig config = null;
        try {
            config = new JedisPoolConfig();
            config.setMaxTotal(MAX_ACTIVE);
            config.setMaxIdle(MAX_IDLE);
            config.setMaxWaitMillis(MAX_WAIT);
            config.setTestOnBorrow(TEST_ON_BORROW);//使用时进行扫描,确保都可用
            config.setTestWhileIdle(true);//Idle时进行连接扫描
            config.setTestOnReturn(true);//还回线程池时进行扫描
        } catch (Exception e) {
            throw e;
        }
        jedisPool = new JedisPool(config, HOSTS.split(",")[0], PORT, TIMEOUT, PASSWD);
    }
    /**
     *@DESC: 多线程环境下确保只初始化一个连接池
     */
    private static void poolInit() {
        if (jedisPool == null){
            synchronized (RedisClientUtils.class){
                if (jedisPool == null) initPool();
            }
        }
    }

    /**
     * @DESC: 获取连接池对象,适用多线程时,利用其获取多个jedis客户端
     * */
    public static  JedisPool getJedisPool(){
        poolInit();
        return jedisPool;
    }
    /**
     * @DESC: 同步获取Jedis实例,适合单线程
     * @return Jedis
     */
    public static Jedis getSingleRedisClient() {
        poolInit();
        if (jedis == null){
            synchronized (RedisClientUtils.class){
                if (jedis == null) {
                    jedis = jedisPool.getResource();
                }
            }
        }
        return jedis;
    }
    /**
     * @DESC: 释放jedis资源,将资源放回连接池
     * @param jedis
     */
    public static void returnResource(final Jedis jedis) {
        if (jedis != null && jedisPool != null) jedis.close();
    }

}
可以看到,这里用到了Redis的连接池(一个就够了,所以是单例模式),这个好处在于能够提前初始化连接,加速获取连接的效率。
但是,你同时也可以看到,这里的Redis连接,也就是Jedis,同样用了单例模式,当初考虑这么做的目的在于,对于一个分布式任务而言,为了确保一个JVM进程内部,避免因为多次调用getRedisClient方法而产生多个Redis连接,一次考虑只用一个Jedis对象,也就是一个单例的连接。
这样做最大的好处在于,避免开发人员在编码时,因对getRedisClient这个方法使用不当,而让Redis产生过多的连接,从而导致Redis不可用。
当这种方式运行在多个executor,且每个executor只分配一个CPU核心时,是没有问题的,因为这意味着运行多个JVM,但是每个JVM是单线程模式。
但是,如果你让这种连接管理方式运行在单JVM,多线程的情况下,问题就出现了,原因很简单。
因为多个线程,就意味着需要多个Redis连接同时进行,但是现在这种方式限制了在一个JVM内部,只能有一个连接实例。
我们来证明一下,代码如下:
/**
  * @DESC: 读取kafka数据,并通过Jedis单例模式
  * @Auther: Anryg
  * @Date: 2022/9/1 09:53
  */
object StreamingWithThreadLocal {

    def main(args: Array[String]): Unit = {
        val conf = new SparkConf()
                .setAppName("StreamingWithThreadLocal")
                .setMaster("local[*]")//本地运行模式,如果提交集群,注释掉这行
        val spark = SparkSession.builder().config(conf).getOrCreate()

        val rawDF = spark.readStream
                .format("kafka") //确定数据源的来源格式
                .option("kafka.bootstrap.servers", "192.168.211.107:6667") //指定kafka集群的地址,理论上写一个broker就可以了
                .option("subscribe","test")  //指定topic
                //.option("group.id","test9999") /**不再用该方式来绑定offset,而是每个程序有个唯一的id,该id跟checkpointLocation绑定,虽然group.id属性在运行中依然保留,但是不再跟offset绑定*/
                .option("failOnDataLoss",false)  //如果读取数据源时,发现数据突然缺失,比如被删,则是否马上抛出异常
                .option("fetchOffset.numRetries",3)  //获取消息的偏移量时,最多进行的重试次数
                .option("maxOffsetsPerTrigger",500)/**用于限流,限定每次读取数据的最大条数,不指定则是as fast as possible*/
                .option("startingOffsets","earliest")  //第一次消费时,读取kafka数据的位置
                .load()

        import spark.implicits._
        val ds = rawDF.selectExpr("CAST(value AS STRING)")  //将kafka中的数据的value转为为string,原始为binary类型
                .map(row => {
            val line = row.getAs[String]("value") //获取row对象中的field,其实也只有一个field
            val rawJson = JSON.parseObject(line)      //原始string是一个json,对其进行解析
            val message = rawJson.getString("message")  //获取业务数据部分
            val msgArray = message.split(",")  //指定分隔符进行字段切分
            msgArray
        }).filter(_.length == 9)  //只留字段数为9的数据
                .filter(array => array(2).length >= 8)//确保日期字段符合规范
                .map(array => {
                    val ipAndAddr = IpSearch.getAddrByIP(RedisClientUtils.getSingleRedisClient,array(0)) //使用普通单例方式管理Jedis的模式
                    //val ipAndAddr = IpSearch.getAddrByIP(RedisClientUtilsV2.getRedisThreadLocal.get(),array(0)) //使用ThreadLocal方式管理Jedis的模式
                    (array(0)+array(1)+array(2),array(0),array(1),ipAndAddr)
    }) //将其转化成为元组,为了方便下一步赋予schema
                .toDF("id","client_ip","domain","ip_addr") //给裸数据添加字段名

        ds.printSchema() //打印schema,确认没有问题

        val query = ds.writeStream
                .outputMode(OutputMode.Append())  //指定数据的写入方式
                .format("console")
                .trigger(Trigger.ProcessingTime(10,TimeUnit.SECONDS))/**每60秒执行一次,不指定就是as fast as possible*/
                .option("checkpointLocation","hdfs://192.168.211.106:8020/tmp/offset/test/StreamingWithThreadLocal") /**用来保存offset,用该目录来绑定对应的offset,如果该目录发生改变则程序运行的id会发生变化,类比group.id的变化,写hive的时候一定不要轻易变动*/
                .start()

        query.awaitTermination()
    }

}
简单起见,我直接在本地用多线程的方式演示,很快它就报错了(事实上,如果你在集群运行,如果让每个executor也跑多个线程,报错是一样的,这部分等你来验证):
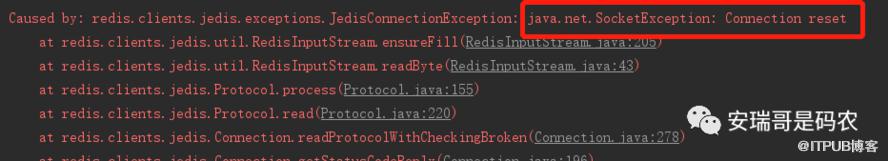
这个报错的信息非常的扑朔迷离,很难让你一下子知道根本原因在哪,但是好在,咱是知道的。
2. 优化后的代码
既然上面这种连接的单例管理模式不行,无法满足在单JVM多线程的情况下运行,那咱是不是得想个两全的办法来解决这个问题呢?
于是,我想到了Threadlocal,这个玩意的使用场景之一,就是用来解决单例模式下连接在多个线程之间的传递问题,而且可以保证单个线程内部,每次获取的连接都是同一个,且不同线程之间的连接属于不同的copy。
于是,Threadlocal的这个功能,正好可以用来解决当下我们遇到的这个问题,在此之前,我查阅了很多相关的资料,很多文章虽然也都说可以用这种方式来解决,但是几乎没有一篇文章能够给出明确的解决方案的(可运行的代码),大家都说的一样,就是不给你落地。
所以,任何技术,不要光听别人说,一定要自己去实践,去验证。
来,优化后的Redis连接管理工具类代码如下:
/**
 * @DESC: 通过ThreadLocal来存储Redis的连接对象,满足多线程情况下的多连接需求
 * Created by Anryg on 2018/5/9.
 */
public class RedisClientUtilsV2 implements RedisParam {
    private static volatile JedisPool jedisPool = null;/**用连接池进行管理*/

    private static  Jedis jedis = null;
    private static final ThreadLocal<Jedis> threadLocal = new ThreadLocal<>();


    /**
     * @DESC: 初始化连接池
    * */
    private static void initPool(){
        JedisPoolConfig config = null;
        try {
            config = new JedisPoolConfig();
            config.setMaxTotal(MAX_ACTIVE);
            config.setMaxIdle(MAX_IDLE);
            config.setMaxWaitMillis(MAX_WAIT);
            config.setTestOnBorrow(TEST_ON_BORROW);//使用时进行扫描,确保都可用
            config.setTestWhileIdle(true);//Idle时进行连接扫描
            config.setTestOnReturn(true);//还回线程池时进行扫描
        } catch (Exception e) {
            throw e;
        }
        jedisPool = new JedisPool(config, HOSTS.split(",")[0], PORT, TIMEOUT, PASSWD);
    }
    /**
     *@DESC: 多线程环境下确保只初始化一个连接池
     */
    private static void poolInit() {
        if (jedisPool == null){
            synchronized (RedisClientUtilsV2.class){
                if (jedisPool == null) initPool();
            }
        }
    }

    /**
     * @DESC: 获取连接池对象,适用多线程时,利用其获取多个jedis客户端
     * */
    public static  JedisPool getJedisPool(){
        poolInit();
        return jedisPool;
    }
    /**
     * @DESC: 同步获取Jedisd ThreadLocal实例
     * @return ThreadLocal<Jedis>
     */
    public static ThreadLocal<Jedis> getRedisThreadLocal() {
        poolInit();
        if (threadLocal.get() == null){
            synchronized (RedisClientUtilsV2.class){
                if (threadLocal.get() == null){
                    jedis = jedisPool.getResource();
                    threadLocal.set(jedis);
                }
            }
        }
        return threadLocal;
    }
    /**
     * @DESC: 释放jedis资源,将资源放回连接池
     * @param jedis
     */
    public static void returnResource(final Jedis jedis) {
        if (jedis != null && jedisPool != null) jedis.close();
    }

}
可以看到,核心的改动就是获取Jedis这个动作,由之前的单例模式,改成了获取包含Jedis的Threadlocal对象模式。
虽然在代码上看,好像也只用了一个Jedis,但是当你在不同线程中从Threadlocal这个变量中去取Jedis对象的时候,就变成了多个不同的Jedis连接对象。
来,看下新的spark代码,如下:
/**
  * @DESC: 读取kafka数据,并通过ThreadLocal获取Jedis模式
  * @Auther: Anryg
  * @Date: 2022/9/1 09:53
  */
object StreamingWithThreadLocal {

    def main(args: Array[String]): Unit = {
        val conf = new SparkConf()
                .setAppName("StreamingWithThreadLocal")
                .setMaster("local[*]")//本地运行模式,如果提交集群,注释掉这行
        val spark = SparkSession.builder().config(conf).getOrCreate()

        val rawDF = spark.readStream
                .format("kafka") //确定数据源的来源格式
                .option("kafka.bootstrap.servers", "192.168.211.107:6667") //指定kafka集群的地址,理论上写一个broker就可以了
                .option("subscribe","test")  //指定topic
                //.option("group.id","test9999") /**不再用该方式来绑定offset,而是每个程序有个唯一的id,该id跟checkpointLocation绑定,虽然group.id属性在运行中依然保留,但是不再跟offset绑定*/
                .option("failOnDataLoss",false)  //如果读取数据源时,发现数据突然缺失,比如被删,则是否马上抛出异常
                .option("fetchOffset.numRetries",3)  //获取消息的偏移量时,最多进行的重试次数
                .option("maxOffsetsPerTrigger",500)/**用于限流,限定每次读取数据的最大条数,不指定则是as fast as possible*/
                .option("startingOffsets","earliest")  //第一次消费时,读取kafka数据的位置
                .load()

        import spark.implicits._
        val ds = rawDF.selectExpr("CAST(value AS STRING)")  //将kafka中的数据的value转为为string,原始为binary类型
                .map(row => {
            val line = row.getAs[String]("value") //获取row对象中的field,其实也只有一个field
            val rawJson = JSON.parseObject(line)      //原始string是一个json,对其进行解析
            val message = rawJson.getString("message")  //获取业务数据部分
            val msgArray = message.split(",")  //指定分隔符进行字段切分
            msgArray
        }).filter(_.length == 9)  //只留字段数为9的数据
                .filter(array => array(2).length >= 8)//确保日期字段符合规范
                .map(array => {
                    //val ipAndAddr = IpSearch.getAddrByIP(RedisClientUtils.getSingleRedisClient,array(0)) //使用普通单例方式管理Jedis的模式
                    val ipAndAddr = IpSearch.getAddrByIP(RedisClientUtilsV2.getRedisThreadLocal.get(),array(0)) //使用ThreadLocal方式管理Jedis的模式
                    (array(0)+array(1)+array(2),array(0),array(1),ipAndAddr)
    }) //将其转化成为元组,为了方便下一步赋予schema
                .toDF("id","client_ip","domain","ip_addr") //给裸数据添加字段名

        ds.printSchema() //打印schema,确认没有问题

        val query = ds.writeStream
                .outputMode(OutputMode.Append())  //指定数据的写入方式
                .format("console")
                .trigger(Trigger.ProcessingTime(10,TimeUnit.SECONDS))/**每60秒执行一次,不指定就是as fast as possible*/
                .option("checkpointLocation","hdfs://192.168.211.106:8020/tmp/offset/test/StreamingWithThreadLocal") /**用来保存offset,用该目录来绑定对应的offset,如果该目录发生改变则程序运行的id会发生变化,类比group.id的变化,写hive的时候一定不要轻易变动*/
                .start()

        query.awaitTermination()
    }

}
运行之后,再也没有报错,正常打印的结果如图所示:
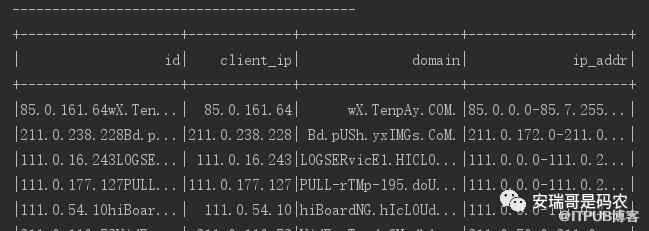
然后,我们再来验证一下Redis的连接数量,看前后有什么变化,先看下这个spark任务运行之前的Redis连接情况:
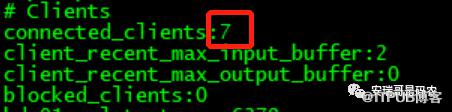
可以看到,在这个Spark任务启动前,其客户端连接数量为7。
而当该spark任务启动正常运行之后,其连接数量如下图所示:
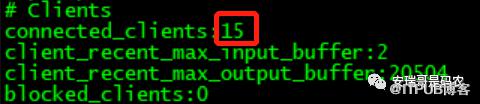
而且,一直会维持15这个数量不变,说明这个任务会长期保持8个连接,而这8个连接,刚好跟我启动的线程数量保持一致,因为我在代码中用的是local[*],这个*指的是当前电脑的总核心数量,而我用的这台电脑,刚好CPU的核心数量就是8。
3. 最后
不知道做这个项目的小伙伴们,在你们的代码验证过程中有没有发现这个问题呢?这个问题,其实就是涉及到了很多Java的基础。
比如像Java的单列模式如何书写,Threadlocal在连接管理时,该如何使用等等。
所以,以后不要再问学大数据,要不要学Java了,早就说过这些就是基础,你只有把基础打牢了,才会在程序员这条路上走的更远。
最后,如果你把这篇文章的内容吃透,完全可以把它作为程序优化的亮点写在你的简历中,作为你的项目贡献,而且,一定是一个加分项。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

