上篇文章咱聊到了clickhouse的单机部署,有的同学觉得单机部署其实挺简单的,根据官方那样一步步去操作,确实不难。
但是吧,如果想把这其中的每一个步骤背后的一些原理性的东西都搞清楚,也就没有那么容易了,当然了,大部分同学可能也没有那个耐心。
认为不就是个安装部署嘛,叮铃哐当一顿操作猛如虎,反正装上就行,服务能起来就行,能用就可以了,管它那么多呢。
Emm... 也不能说不对,但是根据我的经验,对任何一项新接触的技术,咱尽可能做到“先慢后快”,保持一定的好奇心,凡事多思考一步,多验证一下,会让你对新技术的理解更加高效和深刻。
可以看到昨天那篇文章,就是一个简单的单机部署,我却给自己加了那么多戏,当然不是闲的,因为那个过程能让我对一个新技术快速消除陌生感。
clickhouse既然是个数据库,在部署完成之后,那就应该让他干数据库该干的事情。
1. 无数据时存储目录的变化
通过客户端连接到clickhouse的server之后,进入到与该数据库的交互界面:

但是可以看到,这里面有2个warning,一个是Linux关于透明页面的管理,目前默认是打开的,clickhouse希望你能关上。
另一个是说当前机器允许的并发线程数比较低,其实指的就是文件句柄的并发打开数量比较低,这样如果并发查询太大时,服务器就会对其进行限制。
但是,没关系,目前这两点都不是问题,暂时不可能有那么高的并发。
因为咱需要往数据库里写数据,那就先看一下我们存储数据的目录长什么样:

因为这台机器挂载了单独的数据盘,所以我需要把clickhouse的数据存储目录给修改到数据盘挂载的目录下。
虽然目前为止,我一条数据都还没有写入呢,但是可以看到这个目录下已经有了多个文件夹以及文件,并且已经占据了超过一百MB的空间:
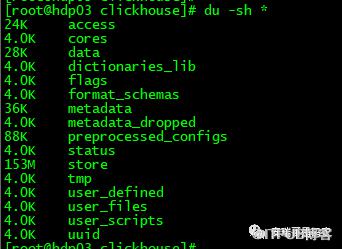
都装了些啥啊,我这都还没写数据呢,所以再结合之前的部署模块和步骤,可以看得出来clickhouse(以下称CK)还是“挺重”的一个数据库。
此外,再仔细观察一下你会发现,这里面有两个目录:一个叫data、另一个叫store。
分别打开之后你会发现,data目录下的子文件夹名字就是CK的数据库名称,但是再次进入到以数据库名命名的文件夹里面发现,它是一个个该库下面的表名,但是这个表名又都是一个个指向store目录下子目录的符号链接:

也就是说,真正存储表数据的是在store目录下,而且你要想找到对应表的数据位置,必须先找到data目录下对应的表,再通过该表指向的符号链接,找到对应的数据位置。
Emmm... 够折腾的,当然,也许这么做,另有目的。
2. 写入数据后的存储目录的变化
接下来,我根据官网要求建个表,先建个空表,
然后看下数据目录下的变化:

可以看到,对应的表名的目录下,多了一个空文件夹,以及一个格式版本文件,里面就写了个数字。
接着,我根据示例,往里面写入4条数据,这4条数据呢,我大概数了一下,也就不到500个字符,按照正常的编码规则,在Linux中也就占个不到500byte的存储空间。
但是,当我把这个数据写入到这张表之后,你猜它要占多大空间,足足要36K:

这里倒不是说这4条数据写入到数据库之后,存储变大了很多,而主要是,你每写入一次数据,它都要给你生成一堆各种奇奇怪怪的文件,你看,他们都长这样:

我大概一数,我滴妈,有足足8个文件呢,有实际数据文件,有的是索引,有的是记录字段名的,也有记录当前分片数据量的等等,然后我还在文档中看到了这么一行说明:

啥意思呢,就是你每insert一次数据到CK的表中,CK都会把这个数据作为一个批次写入到一个part中,也就是说,你每写入一次数据,都会生成一个新的part,那咱来验证一下这个part是个啥。
于是,我又用同样的方式再次insert一条数据到这张表试试:

写入后,再来看数据目录的变化:
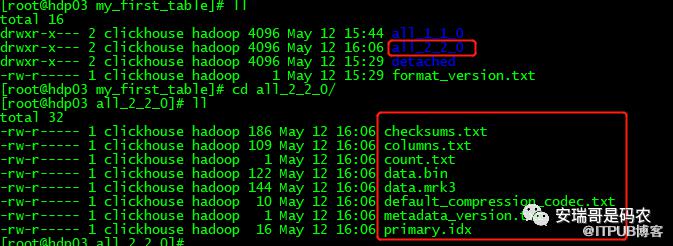
果然,又多了个文件夹,里面文件跟之前一毛一样,也是8个。
这不禁让我想起了hive,都知道hive每写入一次数据,就会生成一个新的文件夹以及新的数据文件,但是你这CK每次不管写入数据量的多少,都不由分说的干出来8个文件,是不是有点太多了(会产生小文件问题)。
那如果我用计算引擎的streaming方式写入CK表,是不是也意味着会有大量的小文件产生呢?
这个暂时不清楚,等待后续验证。
当然,还有后续有没有可以合并的策略,先留个悬念,后面咱再验证。
3. 写入较大数据后的存储变化
如果说刚才写入的几条数据是小打小闹,那么接下来,咱多写入一些数据来看看,存储还会有哪些变化。
接着,我根据官网提供的数据集,找了一份新冠的数据集,然后把它写入到了一张新建的表中:
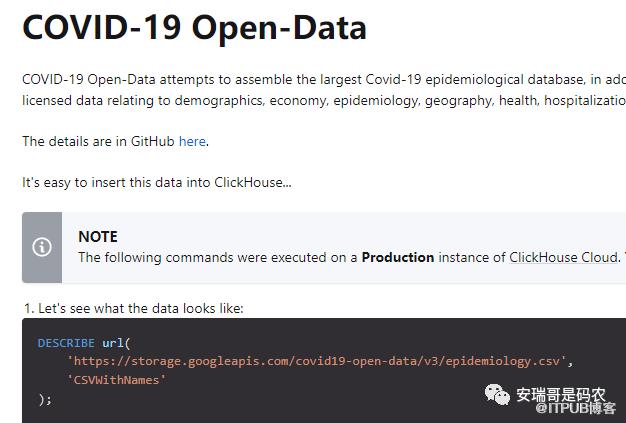
写入之后,查看了一下,有超过千万条:

那我们再来观察下,这些数据在磁盘目录中的组织情况:
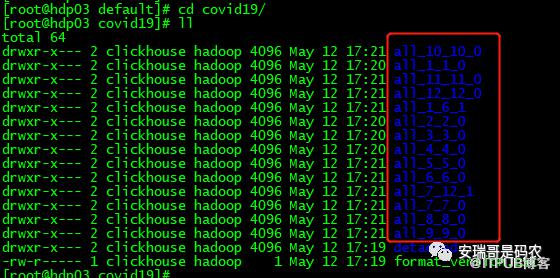
可以看到,这里生产了14个文件夹,但是这批数据我明明是一次性写入的啊。
如果说上一张表的数据生成了2个数据目录是因为我insert了两次,但是这个表我明明只insert了一次啊,为什么就有14个文件夹呢,这个拆分依据又是什么?
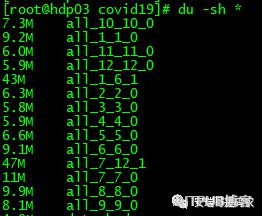
而且最关键的是,你拆分成这14个文件夹,它里面的数据大小又不是平均的,这个多少有点让人不好理解。
而且还有,当我进入到文件夹里面发现,里面的文件数量不再是我一开始认为的固定的8个,而是很多个:
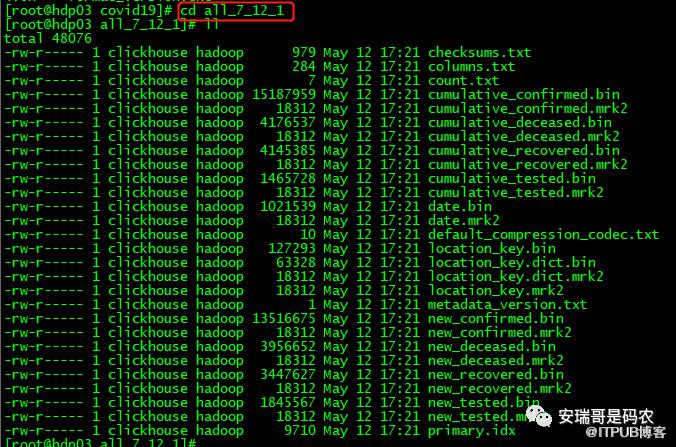
仔细观察可以发现,里面多出来的很多文件,都是以这个表的字段来命名的。
但是上一张数据量少的表,可没有发现这个现象,莫非是因为数据量的原因而区别对待的?
上面不是说不清楚CK有没有小数据合并策略吗? 当我这会再回头看这个之前生成14个文件夹的表数据时,发现,咦... 它真的合并了。
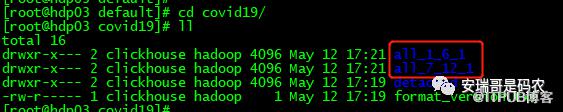
由之前的14个,给合并缩小为2个,而且这两个文件夹的大小也平均了:
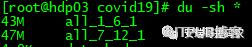
看到了这个现象,我一下子就放心了。
这个合并虽然是后台自动的,但是不知道这个最终的合并个数是否可以通过参数来设置,还是说最终就是给合并为2个文件夹。
因为最开始那个只有5条记录的表,我insert了两次,一开始是两个文件夹,现在还是2个,没有变化。
好了,今天因为事情比较多,暂时只能研究到这里,咱们下篇继续...
你可以添加我的私人微信,拉你入技术讨论群,跟一群热爱技术的小伙伴一起成长...
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

