0.
上两篇文章聊了下CK的单机基本部署和基础建表操作时,数据存储的变化情况,其目的在于从细节处观察CK的运行原理。
那么今天咱就准备着手CK的集群部署,CK的集群跟以往的普通分布式数据库很不一样,以往的普通分布式数据库其架构在最初设计时,就是master-slaver形式,因此你在部署时,必须指定每个运行实例的角色。
但是CK不一样,它在运行时候,没有这种主从的概念,即便是多个实例一起运行,大家都是平级的,公平得厉害。
于是,如果你想让CK以集群的方式协作运行,其做法就是平行部署多个单点的CK实例,然后通过zookeeper这么个中间媒介把这些单点的CK给串联起来,实现集群的功能。
于是接下来,就是在其他服务上用之前相同的方法,去平行部署单节点的CK服务,但是,就是这种相同的部署方式,在另外的机器上,坑出现了。
当我把上一台部署用过的压缩包传到另一台机器之后,前面的clickhouse-common-static模块以及clickhouse-common-static-dbg模块都能通过install目录的doinst.sh脚本运行来成功部署。
但是当我信心满满接下来运行clickhouse-server模块中install目录的doinst.sh脚本时,出问题了:

说是有个叫clickhouse-extract-from-config.old的文件在/usr/bin目录下没有找到,按理说这个目录下放的都是可执行命令,而且我找到了clickhouse-extract-from-config这个命令啊,那为什么要报这个错呢?
为了验证这个问题是否是个例,我又找了另外一台机器来试,发现问题是一样的,为了不想在这个问题上面卡太久,我用了另一个解决办法 。
1.
那就是换成了rpm包来部署,于是我又去官网下载了对应这些模块的rpm包到当前机器:

结果用rpm -ivh一试,果然这个问题就不存在了。
当然,部署完成后,相应的配置(/etc/clickhouse-server/config.xml)需要你再去检查和修改一下来满足你当前服务器的要求。
部署完成后,我们现在就有2台CK实例了,那么接下来,咱们来利用这两台服务器创建一个主—备集群。
我们知道,对于单节点的CK来说,如果当前实例一旦挂了,那么这个数据就没有办法访问了,也就是存在单点故障,那么这个主—备集群就是用来做解决这个问题的,它会在另一台机器上将原来的数据复制一份,来满足高可用。
因为是两个单独的CK实例,要想让这两者之间能够进行通信和数据交流,那么这个时候就需要一个“中间人”来作为沟通的桥梁,而这个中间人就是zookeeper(其实用CK提供的另外一个模块clickhouse-keeper也可以实现这个功能)。
这个时候,打开其中一台机器的主配置文件/etc/clickhouse-server/config.xml,然后找到zookeeper配置的那一行,修改这个地址为当前集群的zookeeper地址:
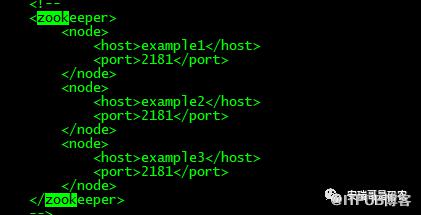
网上有很多教程说什么要在config.d目录下额外配置这个zookeeper,然后在启动的时候指定这个额外的配置文件,我是觉得没有必要,就这样直接在主配置文件上改,更方便一些。
修改完这个配置文件之后,同步到另一台机器中,然后重启这两个CK的server服务(zookeeper集群不用重启):

重启之后,可以看到在zookeeper的根节点下,多了一个clickhouse节点:
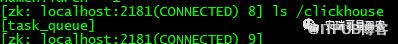
且该路径下已经注册了一些其他信息,代表zookeeper配置修改成功。
2.
主—备需要的“中间人”配置好之后,接下来就是如果创建主备表了。
这里面又要吐槽一下官方文档,它这个主备表需要用到的表引擎说明,在默认的docs首页找不到入口,也就是说没有顶级目录:
必须要通过网页提供的查找功能去搜索,才能找到:

而这一点对于新手来说,个人认为是非常不友好的,我都不知道你CK有哪些功能,你要我去搜索啥呢?
那么接下来,咱来看看这个主—备的表如何创建?

这个是官方给的引擎模板,这里面很有意思的一点是:CK是通过表引擎来区分数据的分布状态的。
这个跟我们普通的分布式数据库可太不一样了,用什么样的表引擎,就决定了你这个表是什么类型:单点的本地表、还是存在多台机器上的主—备表、或者是将一张表数据打散到多台机器上的分片表。
而且从文档来看,就算是主—备这种表引擎,它又细分为如下这些:

至于这些细分的引擎,咱后面有机会再说。
继续来看这个看上去有点膈应人的建表语句,字段部分不用多说,主要是在指定引擎的时候,我们还需要在后面括号指定这个表在zookeeper中元数据存储的路径,当然,这个路径也不是随便乱取的,它最好跟你当前的表有一定的关联性。
我们来看文档怎么说的:
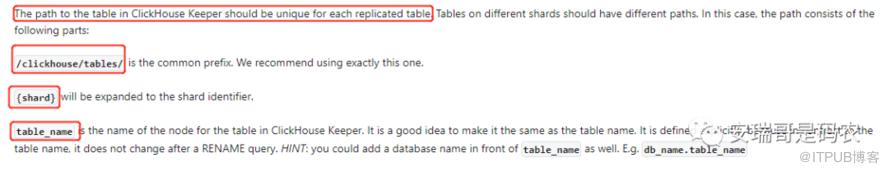
意思是这个路径必须要跟其他主—备表区分开来。
/clickhosue/tables: 表示zookeeper的基础路径,官方要求最好保持这样不变,因为开始我们知道,zookeeper中已经有了一个clickhouse的根目录了;
shard:表示这张表的分片序号,因为我们当前要建的表没有分片(非分片表),于是这个参数就是0;
tablename:当前表的表名,最好跟create语句的表名保持一致,目的在于以后好识别该表,因为如果原表名被rename了,但是这里不会变;

replica:这个官方文档没有做详细的解释,我的理解这个变量就是你给数据副本起一个名字,而且在不同的机器上去执行的建表语句这个名字不能一样。
以上这几个参数,除了可以在建表语句中指定外,其实也可以在配置文件中指定:
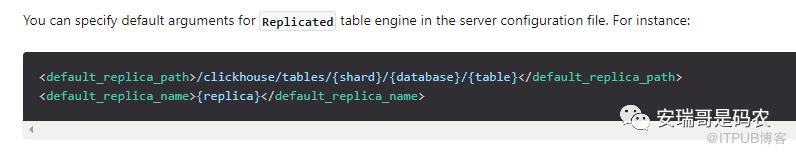
但是为了灵活,还是推荐在建表时指定。
3.
弄清楚了创建主—备表的各种规则之后,我们就开始建一张主—备表试试。
建表语句如下:
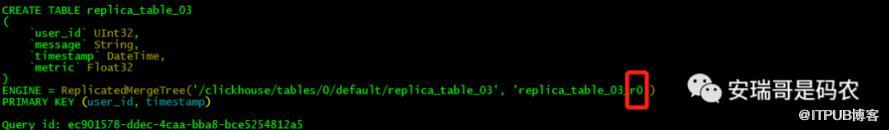
建表语句一
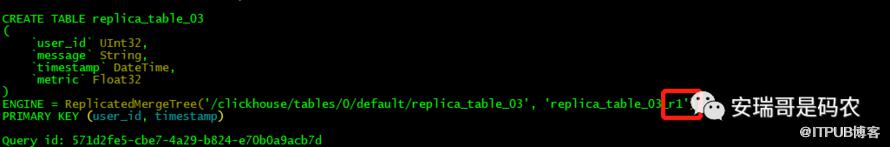
建表语句二
这里面需要注意的是,这两个建表语句需要到连接到2个不同的CK实例中执行,只不过不同的实例保留的是不同的备份,其中一个叫r0,而另一个叫r1。
从其中一个客户端来写入一条数据试试:
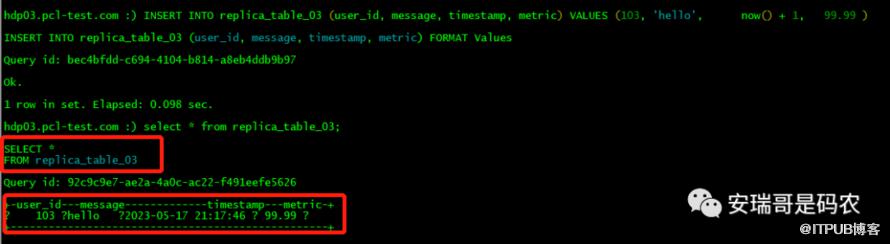
在另一个客户端查看:
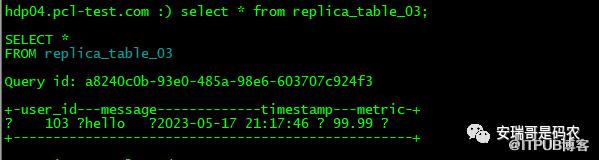
可以看到,当从一个客户端往一个CK实例写入一条数据后,再通过另一个客户端从另外一个CK实例中也能查询到这条数据。
以上步骤则完成了一个CK表基于副本引擎的简单实现。
4.
可能到这里,你会觉得:就尼玛一个表的主—备复制,咋就这么费劲呢。
但也许这就是CK与众不同的地方,虽然目前为止,我还没有发现它比其他分布式数据库在设计上有哪些过人之处。
基于Clickhouse的更多功能,咱下一篇接着聊...
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

