0.
因为我个人对新技术一向都保持着一种“钝感”,所以即便Clickhouse已经出来好多年了,在考虑到它的特性和功能后,我最近才决定开始正式把它用起来。
这个并不能说明我不思进取,而是对于当下的大数据生态来说,早就过了那个非谁不可的年代,尤其对于数据库产品来说,现在市面上涌现的各种琳琅满目的产品,针对各个场景的解决方案几乎全部都囊括了。
对于现在来说,已经有了非常多老牌的、优秀的数据库软件,基于小数据量存储的有MySQL、Redis,Neo4j... 满足大数据量的有Hive、HBASE、Elasticsearch、MongoDB等等。
我是个从来不喜欢贪多的技术人,更喜欢把一项已经在用的技术,给尽可能用到极致,因为只有这样,才让我对技术有种掌控感和通透感。
更何况,这些数据库彼此之间还可以配合起来使用,它们的表现已经足够应付我所经历的所有大数据项目,所以也就迟迟没有去启用新的组件。
这次决定启用Clickhouse,是因为看到一些球友已经在他们的生产环境部署了,而且使用过程中遇到了一些问题,于是,决定自己也来试试。
我会以我习惯的学习方式,将学习clickhouse的过程全程记录下来,希望对你有所帮助。
1. 先看官网
先要给clickhouse的官网点个赞,因为不用“梯子”就可以非常顺畅的打开。
对于任何一项新技术的学习,我们的标准做法应该是,先打开官网的docs文档部分,然后直接找到“Get Started”选项,选择“Quick start”。

然后快速根据里面的步骤实操一遍,而且在浏览的过程中还发现,这个clickhouse官网页面居然还同时支持中文。
吐槽1:但是,这个中文版的页面我不建议你去用,因为它阉割掉了很多内容,相比之下,还是英文版的全面,看来clickhouse官方在汉化这点上没有用心,差评!
2. 最简部署方式
另外,当你准备部署安装的时候呢,你会发现,官网提供给了你多种部署方式的选择。
最开始,它给你一种最简单粗暴的方式(Quick Install方式),该方式不区分操作系统的子类型(无论是CentOS、Ubuntu还是openSUSE等),只要Linux就行。
通过以下这区区3个操作,就把一个单节点的clickhouse环境部署好了(server端和client端),并且同时启动了server端和client端(注意:中文版的文档就把这部分内容给阉割掉了)。
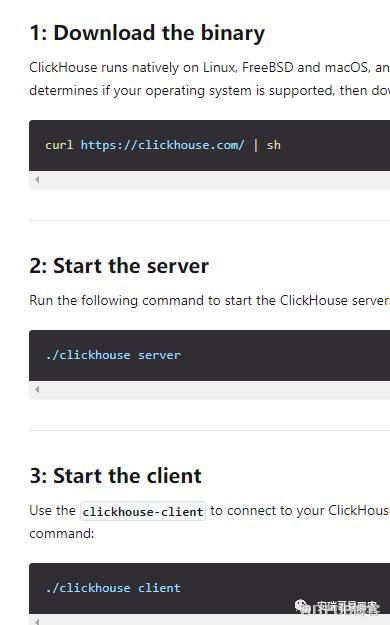
当你启动好客户端之后,就可以开始对clickhouse操作CRUD了,跟操作MySQL的交互方式几乎一样。
但是,这种方式呢,也就只适合让你以最快的速度来给clickhouse扫个盲,知道一下它最基本的操作方式。
这种方式向使用者屏蔽了很多部署细节,比如配置参数等。而且需要服务器有比较好的网络环境,因为第一步的下载操作需要下载一个超过2G的二进制文件,而如果你的服务器没有外网,那就嗝屁了。
因此,不是很推荐。
3. 生产部署方式的选择
想要正规地部署你的clickhouse,必须通过其他方式来进行。
当然,官方文档也给你提供了多种部署方式,但是...
吐槽2:虽然官方文档区分了Quick install和Production deployment两大部分。
但是,在production deployment部分,不同的Linux版本之间的说明,没有做很明显的标题层级区分,对于首次阅读的人来说,有些不友好,必须要看标题下面的小字,才能分清楚当前文档内容属于哪个版本的Linux。

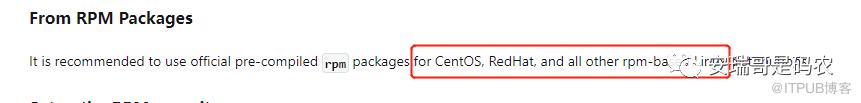
在这一点上,跟Apache生态下的大数据组件说明文档,个人认为有些差距。
那既然这样,就只能辛苦一点,把这些内容全部过一遍,找到跟你当前Linux版本匹配的内容描述。
对于现在来说,一个成熟的软件,想要占领一定的市场份额,一般都会提供如下几种主流的部署方式:
1,源码安装方式:下载量最小,可以根据当前操作系统编译个性化部署,因为可能涉及到一些操作系统的底层依赖问题,因此对部署人的Linux技能有一定要求。
2,Linux自带的包管理方式:这里面其实又包括两种不同方式,一种是通过配置安装包的源来进行,比如CentOS的yum安装,以及Ubuntu的apt-get。另一种则是通过下载具体的rpm包,然后通过rpm命令来进行,但其实这两种本质没有区别,一般为了方便,更推荐前者的方式;
3,压缩包方式:这种方式其实就是第1种通过源码在相应的Linux系统上编译之后,而生成的一系列目标目录和文件,我们把它下载下来之后,可以根据个人喜好,把它放到系统的任何地方进行管理;
4,docker镜像:最近几年,好像但凡是主流的软件,都支持这种部署方式,而这种方式也逐渐取代了之前的sandbox;
4. 部署方式选择
以上这些部署方式呢,在使用不同的软件时我都用过,从个人经验来看,我最偏爱的是第3种,因为使用简单,而且最易管理,数据存储位置,日志位置、配置文件位置可以根据喜好任意摆放。
虽然表面上Linux自带的包管理方式部署要更简单一些,但是它最大的缺点就是:数据文件、配置文件、以及相关命令写得到处都是,无法根据自己的个性化要求来管理。
不要小看这个限制,很多时候对于于一个生产服务器来说,如果你的数据盘跟系统盘是分开的、且挂了多块数据盘的话,软件的目录划分必须遵循你的服务器磁盘管理要求来,否则后续会非常麻烦。
那既然clickhouse支持这种压缩包方式的部署,我这里肯定就选择这种部署方式,但是呢,又出现槽点了。
吐槽3:官方文档给出了我们需要下载5个压缩包(为什么不直接给整合到一个呢?),其中这5个压缩包分别叫做:clickhouse-common-static、clickhouse-common-static-dbg、clickhouse-server、clickhouse-client、clickhouse-keeper。
其中的clickhouse-server 跟 clickhouse-client我们从名字可以知道一个是clickhouse的服务端,而另一个则是客户端,这个合情合理,大家都能理解。
但是其他的几个包又是些什么玩意、分别起什么作用呢?看不懂啊,这些组件是必须都要部署在一台机器上呢,还是都可以根据不同角色分开部署呢?他们之间又是如何通信的呢?官网也不给个解释啥的,差评!这个只能等自己去试错了。
5. 压缩包部署方式
既然选择了压缩包部署方式,那就来吧。
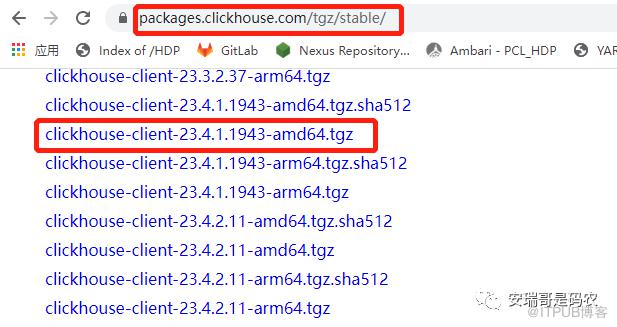
可以看到官网给我们提供了一个下载这些安装包的脚本:
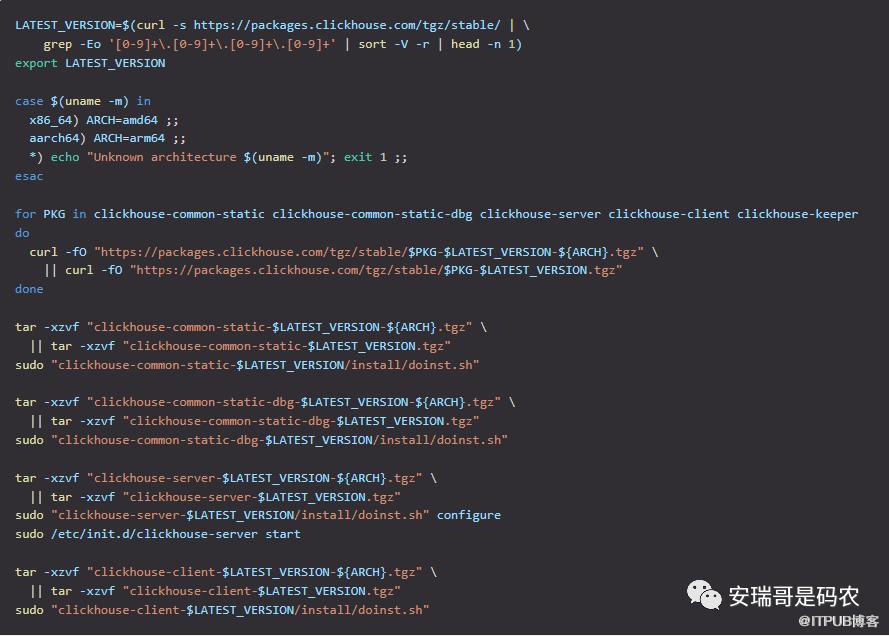
这个脚本默认会下载最新版本的这几个压缩包,但是根据我一般的习惯,我部署软件都会选择次新版(毕竟之前遇到过太多坑),于是这里我会把脚本中第一行的LATEST_VERSION这个变量给改成这样:

这样我的版本就变成了次新版了。
此外,如果你比较细心的话会发现,这里面明明下载了5个压缩包,但是在后续的解压和运行安装脚本的步骤却只有4个。
原因在于:clickhouse-server 这个压缩包中已经包含了 clickhouse-keeper 所有的功能,所以如果这两个包你部署在一台服务器上的话,就只需要安装一个就够了。

当然,如果对于一些同学来说,你的服务器无法通外网,这个脚本暂时就用不了,那就只能根据脚本上面的那个压缩包下载地址,在你的windows机器上打开,然后在本机把这些包给下载下来,然后传到目标服务器上。
6. 先安装clickhouse-common-static
当你把压缩包下载好,并且上传到服务器之后,咱就可以开始安装了。
但是一定要注意,这个安装顺序必须要跟脚本上各个不同安装包安装的顺序一致,否则容易出现命令找不到的情况。
比如我在安装时,先准备安装clickhouse-server时(以往的常规思维是先安装服务端),发现报错:

也就说,这个clickhouse-server的安装,必须要提前要求这个clickhouse命令在PATH路径下准备就绪。
于是我猜测:应该是这个安装顺序导致的问题,也就是说在同一台机器上,如果你想部署clickhouse-server,那么就必须依赖其他的模块。
带着这个想法,我就根据脚本上的顺序开始安装,然后发现果然,这个命令需要clickhouse-common-static这个包来提供。
而这个包呢,主要干的这个事情就是,把它身上的脚本给拷贝到Linux的普通PATH路径下,让Linux用户以及clickhouse的其他模块直接使用这些脚本。
可以看到,当我在clickhouse-common-static这包中执行完doinst.sh这个脚本后,这些clickhouse相关的命令就都能在PATH路径下找到了:

用tab键自动补全之后看到的命令
7. 再安装clickhouse-common-static-dbg
根据官方文档的顺序,接下来就是安装clickhouse-common-static-dbg这个模块了,而且从下载的压缩包的大小可以看出来,这个模块的包最大,接近一个G,于是为了进一步搞清楚这个包是干嘛的,我们来看一眼这个模块的安装脚本长什么样:

脚本内容很简单,就是把当前目录下的一些内容给拷贝到系统目录下,那为了搞清楚到底拷贝的是些什么玩意。
我特意在这个脚本的下面加入了一行代码(红线框出来的部分),把它拷贝的内容给打印出来,然后我再执行时就看到如下显示:

可以看到,它是把几个doc文档以及几个debug文件给拷贝到了一些系统目录下,其中我用红框表出来的那个,居然有800M+,这些文件是干嘛的,咱暂时不知道。
8. 接着安装clickhouse-server
根据顺序,接下来就是clickhouse-server的安装了,解压完这个压缩包之后呢,可以看到这个模块的目录明显要比上面两个要多,可以看到这里面有几个重要的配置文件,于是习惯性的打开看看。
其中主要的是config.xml,这个里面定义了非常多clickhouse需要配置信息,整个瞄完一遍,看得我眼都花了,发现这里面涉及到了很多关于:配置文件目录、数据存放目录、日志存放目录等重要信息。

因为考虑到这部分的安装,也一定会把这些对应的配置信息给拷贝到其他系统目录,那么我就根据我当前机器的特点,适当修改了上面几个默认的目录位置。
然后准备执行这个模块的doinst.sh脚本来开始安装,执行前呢,还是打开这个脚本瞅一眼,发现,咦... 怎么这里面的内容比之前安装的两个模块可多多了:
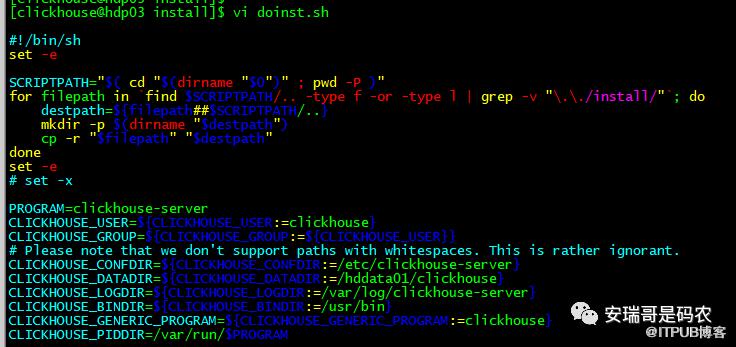
但是,发现里面居然还有一些我刚才在配置文件里改的一些目录信息,于是又把这里面的内容修改得跟刚才那个config.xml保持一致。
然后,执行doinst.sh脚本,发现它依然主要干的是一些复制文件的活,最后让我输入一个clickhouse使用时的密码,然后问我允不允许远程连接,然后就部署完成了。
9. 最后安装clickhouse-client
最后一步安装,就是clickhouse-client模块了,按理说既然是客户端,那么它应该是可以安装在其他机器上的。
但是为了简单不出错,先还是决定根据官网的要求,部署在一台机器上看看。
再解压完压缩包之后,进到目录中可以发现,这里也有个专门的客户端配置文件,也叫config.xml,只不过这个配置文件的内容相较于server模块的来说,要简单多了,里面主要就是一些跟server连接的信息:
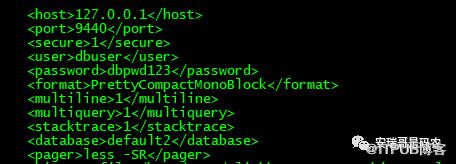
这里其实可以不用做任何更改,在client向server连接的时候在命令行指定host和password也可以。
然后就是查看这个用来安装的doinst.sh脚本,同样,为了清晰的知道在安装过程中我们干了什么,我在脚本中加入一行打印的代码:
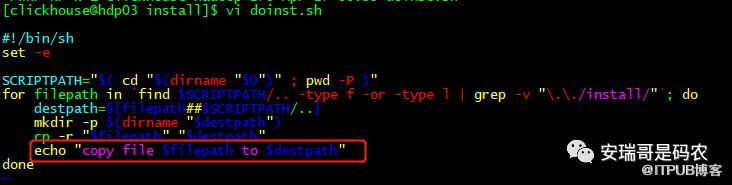
然后执行后,打印出的内容是这样的:
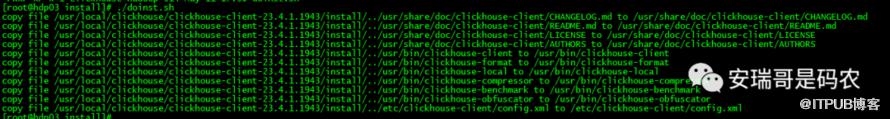
可以清楚地看到,它把哪些文件给复制到了哪里。
至此,clickhouse的单机部署就算全部完成了,咱启动验证一下:
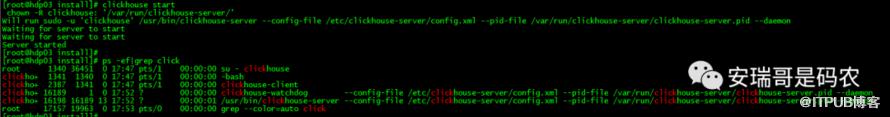
先启动server
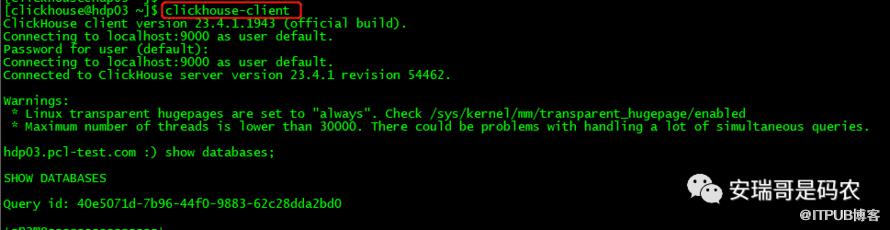
再启动client
10. 总结一下
其实通过以上的描述可以看出来,虽然是压缩包安装,但是clickhouse的软件组织方式跟以往其他软件(比如Elasticsearch)的还不一样。
普通的软件都只有一个压缩包(集多功能模块于一身),而且压缩包解压完,如果你是选择默认的一些配置,比如默认配置文件目录、默认数据文件目录等,就代表着安装已经完成。
但是clickhouse的压缩包安装显然没有按照传统的套路出牌,它分为多个模块不说,还在你每个模块安装时,它都要求把原本在目录中的所有文件(配置文件和执行脚本、命令等)都给复制到其他系统目录下去,相当于安装完成后,原本解压后的目录就没有用了。
而且,在安装过程中必须要用root,或者sudo权限执行,因为过程中涉及到非常多的命令要符号链接到我们的PATH路径下。
从以上的描述来看,好像clickhouse的安装部署并没有那么简单,但是当我们把每一个模块的每一个安装步骤都大致搞清楚之后,后续在对它进行使用时,以及后面我们要对它做分片集群时,就要简单得多。
今天这篇文章就到这里,咱下一篇继续探索...
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

