上周,有球友对于执行SQL时,针对某个表的字段,求其去重数量这个问题做了一番讨论。
说网上有些文章要求大家如果在写SQL时,遇到求某个字段的count distinct,如果执行比较慢,需要优化成group by的方式,然后扒拉扒拉了一堆理由,说这样的效率会更高。
也就是,对于某张表的某个字段,其对比的SQL分别如下:
select
count(*)
from
(select
count(column_name)
from
table_name
group by
column_name)
as t;
group by方式
select
count(distinct(column_name))
from
table_name;
count distinct方式
当时听到这个说法之后,我是本能的表示非常怀疑,因为我在我看来,不同的数据库,其执行引擎在处理数据时候的逻辑是不它一样的,所以,一定不能笼统地去下这个结论。
那么真实的情况到底是什么样的呢?咱们一起来验证看看。
0. 验证准备
为了尽可能比较充分地说明不同数据库,对于这两者的执行效率差异,我特意准备了5个不同的数据库和执行引擎,来分别做对比加以说明。
| 编号 |
执行引擎或数据库名称 |
对应版本 |
| 1 |
Spark sql |
3.2.0 |
| 2 |
Hive sql |
3.1.0 |
| 3 |
Doris |
1.2.3 |
| 4 |
Clickhouse |
23.4.1.1943 |
| 5 |
Mysql |
5.7 |
同时,为了尽可能够体现出查询效率的差距,每张目标查询表都灌入千万级、或者数亿级数据,对比都在同等集群资源条件下,以及排除其他干扰(其他进程或者额外负载的影响)情况下进行。
且每个执行引擎,或者数据库,都会进行多次查询来体现对比结果的公平公正。
1. Spark SQL的对比
这里我分别找了一个3.1G的数据文件,以及11.1G的数据文件进行测试,其中测试去重字段为client_ip。
通过group by方式的spark sql为:

通过count distinct方式的spark SQL为:
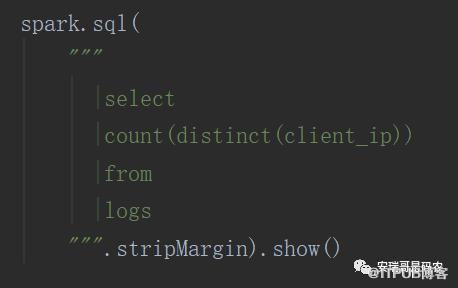
对于测试结果如下。
3.1G数据的查询时间截图
group by方式执行时间:
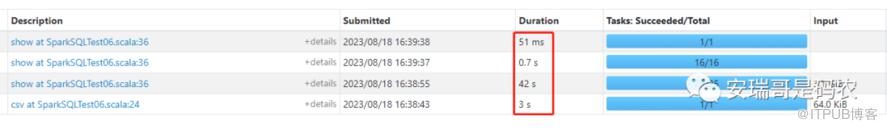
count distinct方式执行时间:
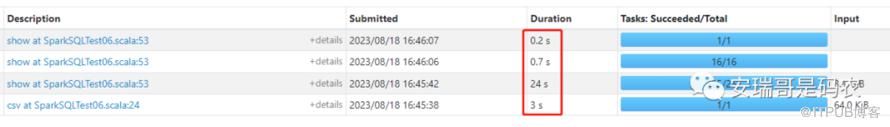
可以看出来,group by比count distinct慢18秒。
11.1G数据的查询时间截图
group by方式执行时间:
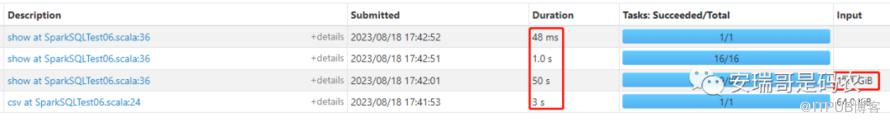
count distinct方式执行时间:

可以看出来,group by比count distinct慢15秒。
从测试结果来看(多次测试对比后),明显count distinct的方式要比group by的方式效率要高一些。
结论:group by效率要低于count distinct。
有同学可能关心测试资源问题,我这里用了3个executor,每个executor分配2G内存(以3.1G数据文件为基准),1核心CPU。
至于为什么是2G内存,这个其实是根据数据量推算出来的,因为我们知道,spark的executor默认只有60%的内存空间是用来放计算数据的,这个时候你除了需要考虑原始数据大小外,还需要考虑数据在计算过程中,可能存在中间的迭代,或者shuffle时的中间状态数据,这个时候内存的需求量是要有一定膨胀的。
2. Hive SQL的对比
接下来,再来看看,同样的查询,在hive的Tez引擎(默认引擎)下,其查询效率又当如何呢?
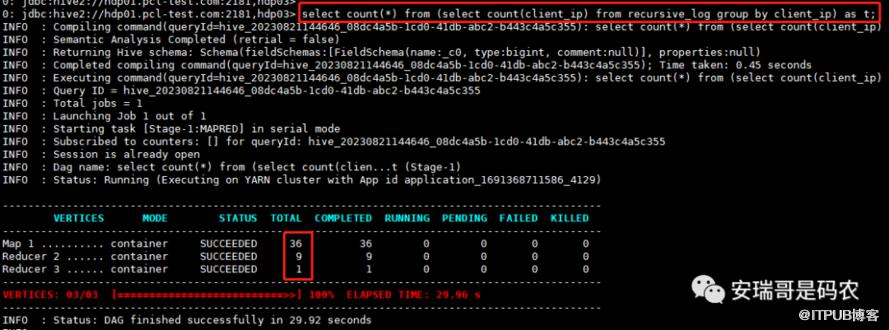
取hive中,一张存储格式为ORC,且数据量近2亿的表来做测试:

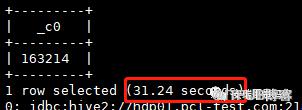
group by方式执行时间:
count distinct方式执行时间:
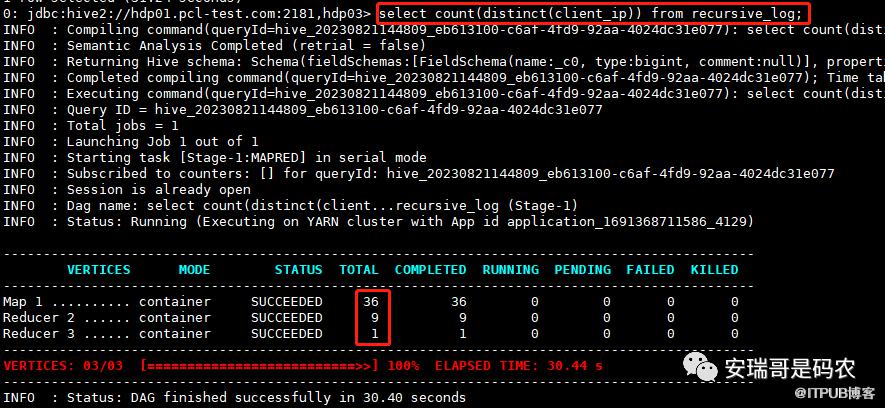
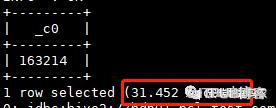
经过多次执行,发现,有时候group by的效率要比count distinct要好,而有时候则反过来,但是每次的执行时间都差不多。
结论:对于hive的tez引擎来说,group by的效率跟count distinct几乎打了个平手。
3. Doris数据库的对比
这个从Doris的原理实现来看,盲猜一定是count distinct效率要高,因为该数据库用的列储存方式,而且对于数据的行数,其元数据都会进行记录。
并且,如果你的目标表,刚好用的是去重表模型的话,那么这个count distinct无疑是100%会在毫秒之内就能得出结果,而group by无论如何都需要进行数据的聚合或者排序。
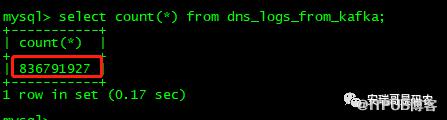
我们这里选一个普通的DUPLICATE模型表,其数据量为8亿+:
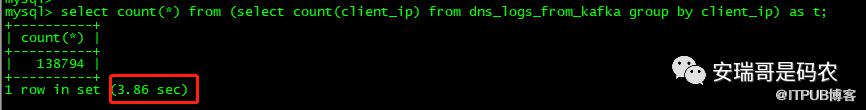
group by方式执行时间:
count distinct方式执行时间:
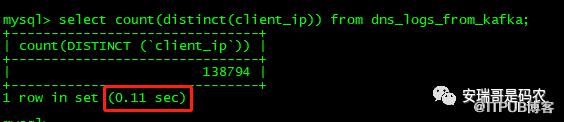
可以看到,这两个执行时间都不在一个量级上,其原因就在于client_ip这个字段,在建表时是“首个”排序字段,因此对于count distinct能带来更大的便利。
为此,为了进一步说明情况,我们换一个非排序字段看看,这里选dns_ip(无排序,无额外索引情况下),再看下效果:
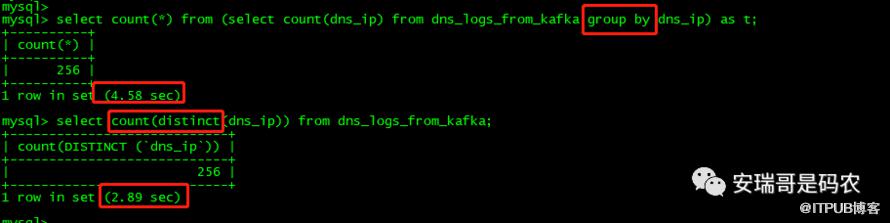
可以看到,虽然差距不再那么明显,但是经过多次查询测试后还是证明,count distinct方式效率比group by方式快。
结论:group by的效率不如count distinct。
4. Clickhouse数据库对比
这里找了一张分布式的MergeTree引擎表(本地表太大话,容易给查挂掉),本身不带任何聚合以及去重功能,数据量为50亿+。

group by方式执行时间:

count distinct方式执行时间:
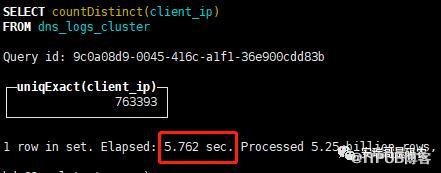
经过多次测试执行后发现,针对client_ip这个字段,每次group by的效率都要高于count distinct一点。
但是,当我更换成一个高基字段后,比如用domain字段发现,情况就发生了反转(同样多次测试后):
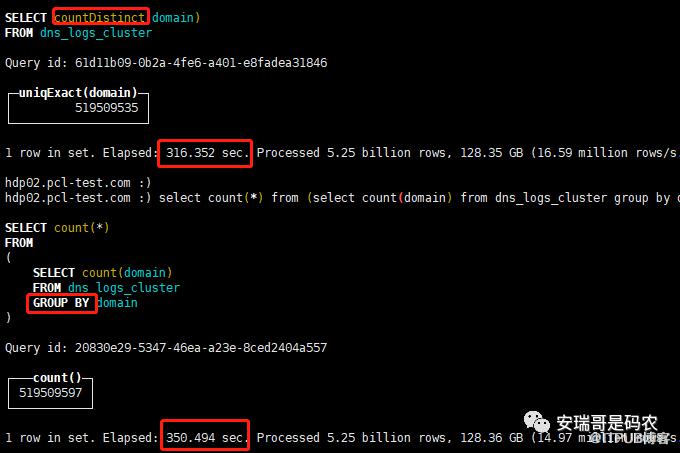
结论:如果是低基字段,group by效率比count distinct高;
而如果是针对高基字段,则count distinct的效率比group by高。
5. MySQL数据库对比
最后,咱再来看看MySQL数据库的表现如何,因为是单节点数据库,为了防止把数据库给干挂掉,因此只找了张2千万+记录的表来试试。
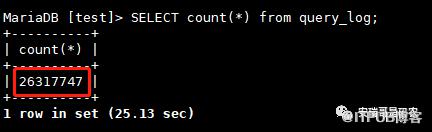
group by方式执行时间:
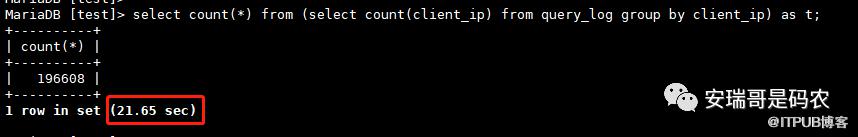
count distinct方式执行时间:
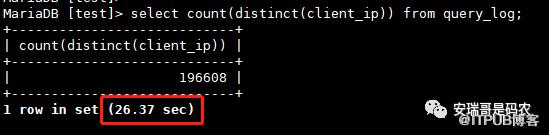
同样,也是经过多次测试对比发现,对于client_ip字段的去重数量查询,group by方式比count distinct要快一点。
结论:group by方式比count distinct快。
最后
从以上5个不同执行引擎或者数据库的测试对比结果来看,针对同一份数据集(不同数据量)的相同查询场景。
我们可以看出来,没有绝对的结论表明,group by跟count distinct谁的效率就一定高。
不同的执行引擎或者数据库,甚至在同一个数据库内部,针对不同的字段(高基和低基字段),其查询效率都可能出现不一样。
因此,还是那句话,谁的效率更高,永远都不能一概而论,除了引擎不同会有影响外,查询的字段特点不一样,同样也会带来不同的效率体验。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

