上周的一篇文章写了关于hudi的初级使用(
虽然过程中遇到了一些坑,但是通过文档+源码的解读方式,还是都可以一一解决,而且通过实践,还指出了官方文档有些描述不准确的地方,比如一些非必要配置文档给标记为必须配置等等。
但就在我认为通过spark写hudi这个动作可以翻篇时,发现我天真了,因为上次是通过我在kafka里造的数据写入的hudi,数据量有限,一些问题没有暴露出来。
当我往kafka里持续灌数据让spark消费,并写到hudi表时发现,幺蛾子出现了。
1. spark3 + Hadoop3 配合hudi出现的bug
在我持续通过spark往hudi表中写数据时,日志里便出现了这样的异常:
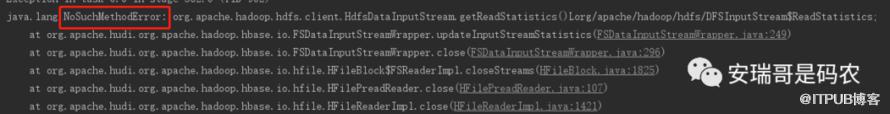
就在想,为啥刚开始数据写入好好的,怎么突然就抛出这样的异常了呢?
经过一番观察后发现,每当hudi表经历第10次commit的时候,这个错误就会被报出来,时机掐得特别准。
其实是hudi表默认在这个时候(10次commit后),便开始进行文件的合并,也就是数据在刚开始写入时,HDFS的数据文件(默认为parquet)是从0个开始慢慢增加到10个,10个之后,后面写入的数据便开始跟之前的文件合并,生成新的数据文件。
而就在这个时候,这个异常就出现了。
2. debug问题
乍一看这个问题呢,还以为是jar包冲突导致的,但是仔细观察后发现,当前软件工程中,就只有一个包hadoop-client-api提供了这个类的这个方法,想冲突都没有对象。
于是根据经验,可以排除是传统jar包冲突导致的,然后尝试了2种解决办法,均已失败告终:
1. 降低hudi跟spark组合jar包的版本(0.11,0.12都试过):无效;
2. 修改默认的表类型为MERGE_ON_READ:无效;
后面查资料发现,这是Spark3、Hadoop3、hudi这3者在团伙作案时闹出的bug。
而且这个bug在hudi的0.11版本开始就出现了,原因竟然是hudi表在进行数据的compact(合并)的时候,在其metadata中,会用hfile这种文件格式来记录相关的元数据信息。
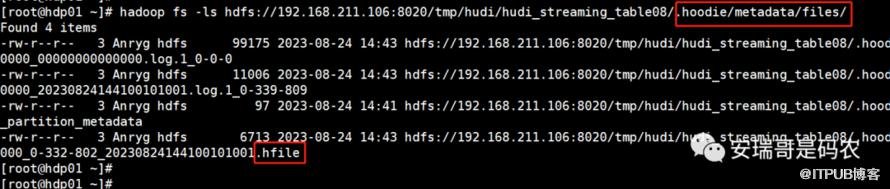
而这个hfile实现类相关的依赖,则使用的是Hadoop2,编译之后就给揉到了现在的hudi-spark组合jar包中,才导致与当前Hadoop3环境的不兼容问题。
3. 解决问题
既然问题找到了,那解决起来应该就不难。
既然依赖的hudi-spark组合jar包是根据Hadoop2的环境编译的,那么要么下载该组合jar包的源码,重新根据Hadoop3环境来编译,要么就将当前的Hadoop3环境改为Hadoop2。
显然,前者有些麻烦,后者则更麻烦且不太现实。
那有没有更简单的方式来解决呢?
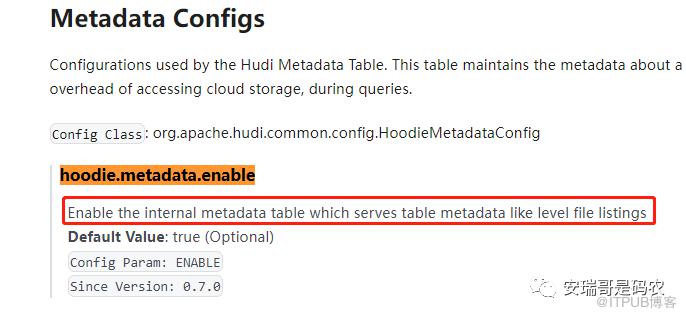
刚才分析说到,那个hudi在做文件合并时,需要用到hfile来记录相关的元数据信息,那如果我们不要它记录这个元信息,是不是就可以避免这个问题。
当然,前提是不通过这个hfile的方式来记录其元数据信息,不影响后续hudi表的其他操作,比如正常写入和查询等(事实证明确实不影响)。
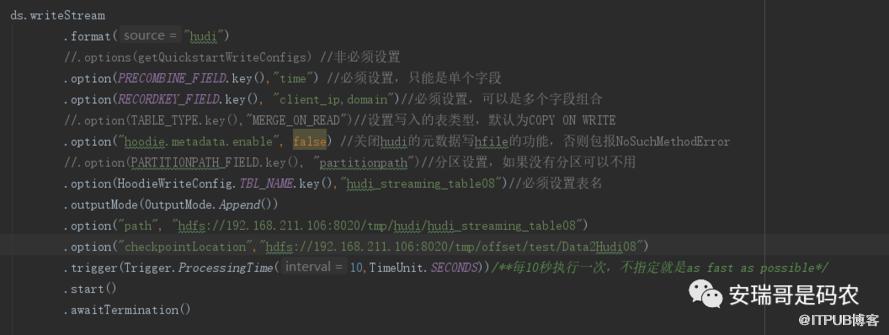
说干就干,那就把这个通过hfile来记录元数据信息的功能禁止掉(默认开启),只需要做这个设置:
option("hoodie.metadata.enable", false) //关闭hudi的元数据写hfile的功能
加入这个配置之后,其他地方不用动,直接启动原来的任务,数据就能正常持续性写入了。
4. 后续观察
这个报错问题解决后,咱可以来观察一下这个数据在持续写入时,对应HDFS上面数据文件的变化情况。
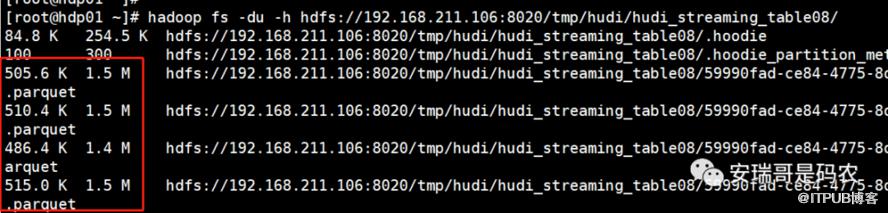
数据刚开始时,其大小是这样的:
写入一会后,数据文件会逐渐增大:
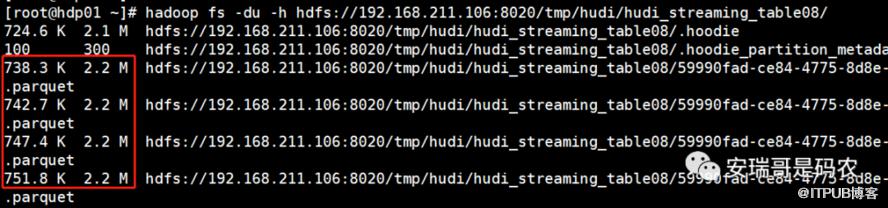
仔细观察会发现,一开始,当单个文件的大小没有达到阈值时,其文件数量一直维持在10个左右,而且每次合并,这个文件名都在发生变化,也就是不断在删除老的,生成新的。
而且这个写入hudi表的过程中,因为必须要指定两个key。
.option(PRECOMBINE_FIELD.key(),"time") //必须设置,只能是单个字段
.option(RECORDKEY_FIELD.key(), "client_ip,domain")//必须设置,可以是多个字段组合
因此写入其中的数据,是天然去重之后的。
所以hudi表相对于以往的hive表,从以上实践可以看出来,它比hive要优越的地方有:
1. 天然对小文件的合并能力;
2. 支持根据规则对数据的去重能力;
这里面的小文件合并能力比较好理解,就是让更多的数据尽可能写到一个文件中。
但是这个去重,hudi是怎么实现的呢?
5. hudi的去重原理
虽然官方文档给上面两个必须要添加的key(去重目的)设置做了说明,但是对于初次接触的同学来说,依然不够直观。
为了让你更清晰地理解这个去重的原理,我特意做了几组实验,来加以论证和解释。
先来看PRECOMBINE_FIELD.key()这个参数:
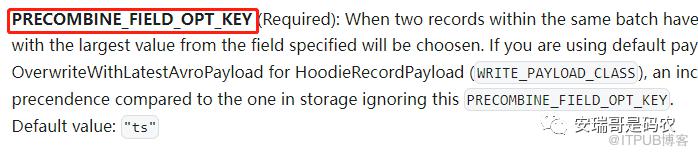
官方文档说的是:在同一批次内部,如果存在key相同的两条或者多条数据,那么就保留value更大的那条。
首先,我们要知道,这里的key是谁,value又是谁?
这里的key其实指的是这个PRECOMBINE_FIELD.key()参数对应的字段的值,默认为ts这个字段(该字段必须包含在表字段中,只能指定一个,要根据实际需要进行修改),所以这个key指的就是ts这个字段对应的值。
而value,则是ts字段之外的其他字段值的组合。
如果ts这个字段的值相同,根据文档的描述,那么就取value最大的那个。
但是官方文档这里描述的并不准确,通过我的实践,其实value默认取的是最新写入的那条记录(还有,前提是recordkey也相同的情况下),而不是比较之后的最大值。
并且,这里其实并不限定去重的数据只是针对单个批次内部,跨批次写入依然能够去重,虽然后台文件系统显示具体的文件没有合并,但是查询出来后确实是去重了的。
再来看RECORDKEY_FIELD.key()参数:
这个官方的解释是primary key,且保证分区内部唯一,默认字段为uuid(该字段必须包含在表字段中,要根据实际需要进行修改),且可以是多个字段的组合。

刚才在说PRECOMBINE_FIELD.key()约束时提到,如果遇到ts相同,但uuid不同的情况时,以uuid为准,也就是说uuid的去重优先级比ts要高。
而且实践中,建议这两个字段的选择最好不要重合,也不要是被包含的关系,比如recordkey字段中不要包含precombinekey的字段,否则这个precombinekey设置就失去了意义。
---------------------------------------------------
以上,就是我第二次对hudi的体验,虽然毛病不少,但是也确实解决了一些过往组件无法满足的痛点。
更多相关内容,咱下篇再见...
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

