上篇文章写了hudi跟Hadoop3在兼容方面的问题,以及对应可以采取的解决办法,这篇文章咱接着来聊聊Hudi的COW(copy on write)和MOR(merge on read)。
这两者是hudi支持的两种表类型,本质是指的是数据在写入hudi表时所采取的两种写入策略,代表着两种不同对数据的处理思想。
COW:
全称叫:copy on write,翻译过来叫写时拷贝。
但是根据官方文档的介绍以及我的理解呢,认为这个说的其实并不十分准确,应该叫写时合并更能体现出它的特点,也就是merge on write。
指的是数据在写入hudi表的过程中,随着数据的持续写入,写入程序会根据数据文件的大小以及个数,自动进行新、老数据的合并,去重、甚至排序、然后生成新的数据文件,并删除老的文件。
理论上,是一种典型的以牺牲写入效率来换取查询效率的方式。
MOR:
全称叫:merge on read,翻译过来叫读时合并。
这个解释相对来说比较准确,意思是数据在写入的时候,为了尽可能保证写入速度,不同步做数据的合并操作(可以异步合并),而是以append的方式将数据写入到avro格式的日志文件中,在我们读取数据时,再启动合并策略。
理论上,是一种典型的以牺牲读取效率来换取数据写入效率的方式。
COW和MOR虽然代表的是hudi表的两种表类型,但其实它也是我们在做数据库设计,或者架构设计时的一种设计思想,这种思想在我们的软件工程很多地方都得到了应用。
既然这样,那我们来测试下看看,这两种表类型在实际使用时,有没有跟官方文档描述的一样呢?
为此,我专门分别用流的方式以及批处理的方式,写入多个不同的hudi表,来观察他们的数据写入情况以及结果查询情况。
先给结论:跟官方文档的描述有出入。
1. 批处理写入hudi的情况
找来一个约3G大小的文本文件,分别测试用spark写hudi的COW表,以及MOR表。

经过了多次写入测试对比,基本上可以确定:
在以6个并行度情况下,不管是COW的写入方式还是MOR的写入方式,写入时间均在15分钟左右(跟官方文档描述不一样)。
老实说,挺惊讶的,一来惊讶于它花费的时间,二来惊讶于它消耗的硬件资源。
来看下这个任务我给的硬件资源:
--executor-cores 2
--num-executors 3
--driver-memory 1g
--executor-memory 4g
--conf spark.executor.memoryOverhead=4096
是不是有点吓人。
这个其实并不是我一开始就给的这么多,主要是一开始我抠抠搜搜1g、2g的给吧,任务启动没一会就OOM了,光这个内存参数,我就调试了至少4-5次,内存一直增加到这个数值,才让它没再失败过。
而它之所以要消耗这么多资源呢,打开它运行的Spark UI界面,看到它的DAG执行图你会发现,这批数据在写入hudi表时(cow和mor都是)有各种:分组、去重、join等操作。
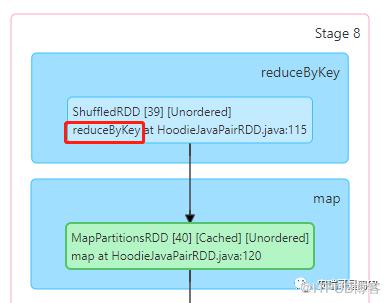
分组操作
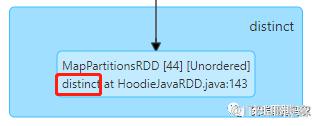
去重操作
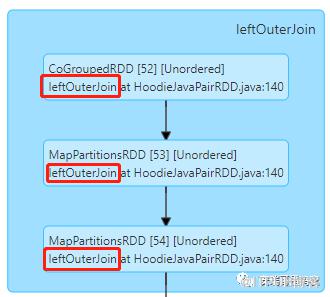
join操作
也许你就能理解,为什么它跑这么慢,且还需要这么多资源了,但至于它为什么要join,暂时没有搞懂。
2. 批处理写入时文件变化情况
官方文档的说明是,如果是cow的写入方式时,数据会在写入过程中合并,所有数据文件默认都是parquet格式。
但如果是mor的写入方式时,会是同时存在parquet格式的数据文件,以及avro格式的log文件。
然而事实情况是,批处理写入时,不管是MOR方式还是COW方式,数据写入过程我一直盯着输出目录,均没有看到这个avro格式的log文件的影子。
这就很尴尬,官网明明说的MOR写入时,其文件的合并默认是异步的,但我看到的却是同步方式。
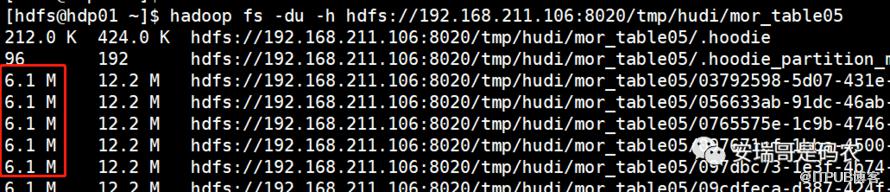
而且在通过批处理写hudi表时,无论是COW表还是MOR表,最终输出的parquet文件个数都是193个。
主要对应这个stage:
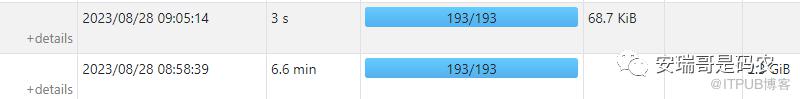
说实话,这个数字让我很迷惑,为什么是193,依据是什么(这应该涉及到写hudi表时,其内部的实现机制),而且这193个partition,就对应着193个输出文件。
关键这样一来,输出的单个文件就太小了,每个平均只有6MB:
而且,你还无法通过repartition的方式来调整这个partition大小(因为调整了也没用,它无法决定最终输出的分区数量),继续查看官方文档的配置,试了以下这些参数,发现均不行:
.option("hoodie.finalize.write.parallelism", args(3)) //不起作用
.option("hoodie.upsert.shuffle.parallelism", args(4)) //无法决定最终输出文件个数
.option("hoodie.bulkinsert.shuffle.parallelism", args(5)) //不起作用
.option("hoodie.insert.shuffle.parallelism", args(6)) //不起作用
当然,也许是我没有找到能合并的参数,又或者它确实不可以通过参数调整。
但后来通过进一步查看文档发现,像这种批处理方式写入hudi表时,可以用bluck_insert方式写入(默认为upsert)。
.option(DataSourceWriteOptions.OPERATION.key(), "bluck_insert")
这样确实可以把写入效率提高不少,实测3分钟(默认的upsert方式要15分钟)就能写完这批数据,而且写入的文件数量保持跟读取数据时的分区数量一致(24个)。
但是,这样写入的数据是没有做去重合并的,理论上跟通过spark写parquet格式到HDFS没有区别。
4. 批处理的COW与MOR查询对比
因为写的是同一份数据,所以针对同一个查询,就很容易对比出效率差异。
查询条件很简单,因为写入的是之前那份dns日志数据,那我就想看下去重后client_ip的数量:
select
count(distinct(client_ip))
from
dns_logs;
因为是通过idea用spark SQL查询的,所以这里没法贴出准确的查询时间。
大致算了下,COW表的效率还是要比MOR快一些(跑了多次后),前者花了大概150秒,后者花了约100秒。
5. 流式写MOR与COW
相比于批处理方式写入hudi表,流的写入方式则要更舒服一些,起码不用耗费太多的内存资源。
最关键的是,流方式写入数据到hudi表(MOR和COW),它没有批处理那样有那么多花活,比如上面在批处理时,DAG中可以看到的各种分组、join、去重操作,在流式写入时,一个都没有看到。
所以流方式的写入效率很高,而且写入的文件数据量和大小可以得到控制。
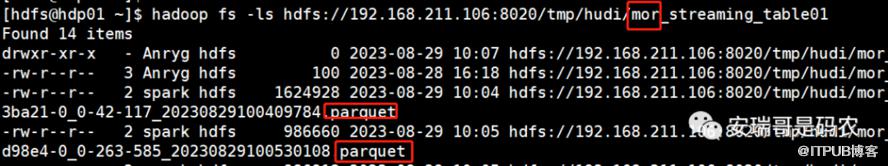
但是不管是用MOR方式写入还是COW方式写入,在后台文件数量不断增多的过程中,我始终没有看到avro格式的log文件出现过(根据官方文档描述,MOR方式是这样的),都是直接就写成了parquet文件。
最后
从这个对spark写hudi的COW和MOR表写入特性来看,无论是COW还是MOR表,对于我的这个写入场景来说,MOR表并没有出现在写入过程中文档描述的avro格式的log文件(一直盯着看呢,难道是合并的太快了吗)。
而且从写入过程中消耗的硬件资源和效率来看,批处理的写入方式很不尽如人意,相比之下,流式的写入更符合hudi表的写入特性,并且更推荐用COW。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

