上两篇文章聊了Spark用批处理和流的方式写hudi遇到的一些坑,以及分别通过COW方式和MOR方式写hudi表时,这两种不同写入方式在写入过程中所表现的差异。
如果说上次spark写hudi表遇到的是小坑的话,那么这次用flink写hudi表的坑则要属于大坑了。
这些坑具体埋在哪些地方,然后又有哪些表现呢?我们一个个来看。
0. 开发环境准备
因为要部署开发环境,所以我们要做的第一件事情,就是在软件工程中引入对应的pom依赖。
由于我当前的flink版本为1.15,因此,找到hudi官网关于flink写hudi的文档,找出跟当前hudi版本兼容的依赖。

于是在当前的flink工程的pom文件中加入这个配置,引入flink写hudi表时的依赖。
虽然从官方文档的描述来看,告诉你要在flink的服务器中添加各种关于hudi的jar包和配置,但其实你要知道,在我们的IDEA开发环境中是不需要的,只要添加上面这个pom配置,你的开发就可以开始。
对于Flink来说,常用的api有两种:一个是SQL API;另一个是DataStream API。
那为了让代码更加简洁,我这里首先选择用SQL API来进行开发,代码特别简单,如下:
package com.anryg.hudi

import java.time.Duration

import org.apache.flink.streaming.api.CheckpointingMode
import org.apache.flink.streaming.api.scala.StreamExecutionEnvironment
import org.apache.flink.table.api.bridge.scala.StreamTableEnvironment

/**
  * @DESC: Flink读取kafka数据写hudi表
  * @Auther: Anryg
  * @Date: 2023/9/1 17:31
  */
object FlinkSQLFromKafka2Hudi {

    def main(args: Array[String]): Unit = {
        /**创建flink环境对象*/
        val env = StreamExecutionEnvironment.getExecutionEnvironment

        env.enableCheckpointing(10000L)
        env.getCheckpointConfig.setCheckpointStorage("hdfs://192.168.211.106:8020/tmp/checkpoint/FlinkSQLFromKafka2Hudi01")
        env.getCheckpointConfig.setAlignedCheckpointTimeout(Duration.ofMinutes(1L))
        env.getCheckpointConfig.setCheckpointingMode(CheckpointingMode.EXACTLY_ONCE)

        /**创建flink table环境对象*/
        val tableEnv = StreamTableEnvironment.create(env)

        /**第一步:读取kafka数据源*/
        tableEnv.executeSql(
            """
             Create table dns_logs_from_kafka(
             |client_ip STRING,
             |domain STRING,
             |`time` STRING,
             |target_ip STRING,
             |rcode STRING,
             |query_type STRING,
             |authority_record STRING,
             |add_msg STRING,
             |dns_ip STRING
             |)
             |with(
             |'connector' = 'kafka',
             |'topic' = 'test',
             |'properties.bootstrap.servers' = '192.168.211.107:6667',
             |'properties.group.id' = 'FlinkSQLFromKafka2Hudi01',
             |'scan.startup.mode' = 'latest-offset',
             |'value.format'='csv',                                 //确定数据源为文本格式
             |'value.csv.field-delimiter'='|'                      //确定文本数据源的分隔符
             |)
            """.stripMargin)

        /**第二步:创建Hudi映射表*/
        tableEnv.executeSql(
            """
              |CREATE TABLE dns_logs_from_flink2hudi01 (
              |`client_ip` STRING ,
              |domain STRING,
              |`time` STRING,
              |target_ip STRING,
              |rcode STRING,
              |query_type STRING,
              |authority_record STRING,
              |add_msg STRING,
              |dns_ip STRING,
              |PRIMARY KEY(client_ip,domain) NOT ENFORCED  //确定主键字段
              |)
              //|PARTITIONED BY (`time`)  //确定分区字段
              |WITH (
              |'connector' = 'hudi',
              |'path' = 'hdfs://192.168.211.106:8020/tmp/hudi/dns_logs_from_flink2hudi01',
              |'table.type' = 'COPY_ON_WRITE'
              |)
            """.stripMargin)

        /**第三步:数据写入到Hudi表中*/
        tableEnv.executeSql(
            """
              |INSERT INTO dns_logs_from_flink2hudi01
              |select
              |*
              |from
              |dns_logs_from_kafka
            """.stripMargin)
    }
}
1. 第一个坑
运行后,很快就报错了:
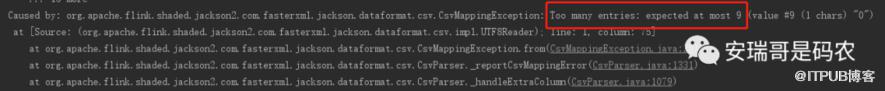
从报错提示来看呢,说是在处理数据时,遇到了太多字段数超过9的数据。
因为我们定义这个kafka的表刚好是9个字段,而我们从kafka数据源获取的数据,将其映射成9个字段表时,遇到了too many超过9字段的数据,于是就报错了。
这个锅其实是flink SQL的,原因在于我当前读取的这个topic,一开始灌入了一些其他超过9字段的数据源,而这种通过设置SQL表的读取数据源方式,没有办法提供那种更加细致的条件筛选,比如根据分隔符分割之后,取字段数量符合要求的数据,这个是当前SQL这种表达式做不到的。
既然这样,那么就只能换个topic,或者设置为消费最新的数据,老的数据就不消费了(或者用DataStream API来过滤)。
2. 第二个坑
这个坑特别有意思,同样的代码在写不同的表类型时,表现是不一样的。
2.1 写COPY ON WRITE表时
上面因为数据源字段数量问题解决后,再次启动任务,发现第二个坑又来了,具体报错如下,这个时候是一条数据都写不进去的(关键程序虽然抛异常了,但是进程根本没有停下来,不仔细看甚至都发现不了):
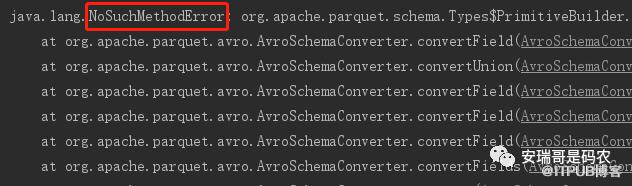
从报错类型来看,像这种NoSuchMethodError的情况,大多数情况都是因为jar包冲突导致的。
这个时候,正常的做法,就是看当前开发环境里,有多少个不同的jar包中包含了这个类(org.apache.parquet.schema.Types)。
用快捷键ctrl+shift+alt+N,弹出如下对话框,然后输入上面这个类,可以看到如下图所示:

可以看到有5个jar包都包含这个类,而其中最下面2个parquet-column是另一个module的(IDEA会默认显示所有模块包含的jar),因此不用管。
而parquet-hadoop-bundle已经被我排除掉了(具体怎么排除,可以参考我之前的文章,有篇专门写如何解决jar包冲突的)。
但是运行之后问题依旧,那么说明真正冲突的是hive-exec这个包,因为hudi-flink-bundle是刚才新加的嘛,总不能把它干掉对不对。
那这个时候,常规办法就是,干掉hive-exec这个包(在pom文件中直接注释掉)。
注释之后,COPY_ON_WRITE表正常写入(需要将之前的表文件夹和checkpoint文件夹删除掉)。
写入后,观察hudi表的数据情况发现,数据文件开始会一直增加,增加到约150个之后(150次commit),才开始合并。

合并之后:

这个默认的合并策略很明显跟之前spark structured streaming写hudi时不太一样,spark写hudi时,在数据文件写到10个之后(10次commit),就开始了合并。
2.2 写MERGE ON READ表时
刚才说到写COPY_ON_WRITE表时,抛异常是因为跟hive-exec这个包中的类冲突了,干掉hive-exec可以解决问题。
那么在写MERGE_ON_READ表时,我故意把刚才冲突的hive-exec包给放开,然后再运行程序,发现,居然全程没有报错,而且数据能写进去。
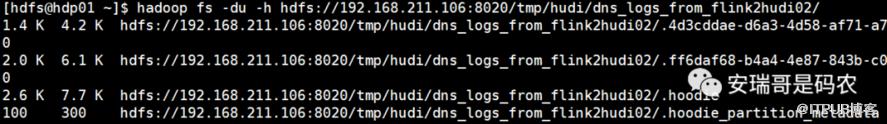
可是呢,只能写进去一小部分,然后程序就卡住不动了,也不报错。
重启,新换一张表,情况依旧,还是数据只能写进去一小部分,但是一会之后,会报出跟之前写COPY_ON_WRITE表时一样的错了(程序依然不停止),也就是说这个时候程序报错与否全凭当时的心情。
最后,还是只能把hive-exec这个包给注释掉,再运行,这个问题才算解决。
然后,也观察了下数据在写入后,数据文件的变化情况:
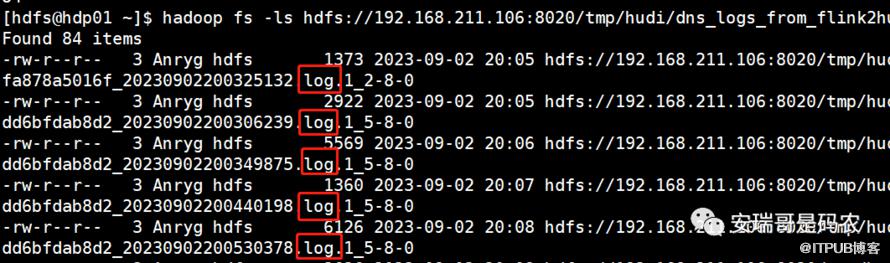
这个时候,终于看到了官网说的,MOR表的数据写入是先写log文件,再合并为parquet文件。
至于其开始合并的文件数量(阈值),观察了一下,默认大概在100左右。
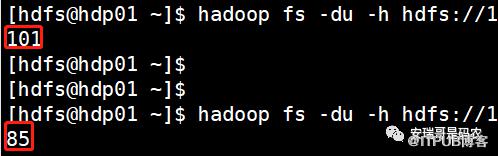
这一点,又跟spark默认的不太一样。
2.3 坑外坑
这个坑的特点就是:程序卡住不动,数据写不进去,也不报错。
主要表现在程序报错了,问题解决之后,如果继续启动程序,还是写入原来的表,还是沿用原来的checkpoint,那么就会出现这种卡住不动的情况,如果不仔细思考,你会以为问题没有解决。
所以在解决这个Flink SQL写hudi表过程中遇到的问题时,必须得各种尝试,每次修改完配置,或者解决完报错的问题后,就需要删除原来的hudi表目录,以及checkpoint目录(或者换一个全新目录),才能真正的解决问题。
原因大概是原来表目录中的元数据信息,以及checkpoint的元数据信息中,包含了之前一些无法兼容的配置导致。
此外,我还尝试了一下用Flink的DataStream API,根据官方文档的示例,一时半会没折腾出来,主要是官网没有提供将数据源的行(string),如何转化成为写入时需要的RowData格式,看源码也是一脸懵逼,下次再说吧。
3. 跟spark比
从当前的场景实现来看,相比spark,通过flink写hudi表的坑明显更多一点,解决起来成本也更高一些。
之前spark写hudi虽然也有jar包版本兼容问题,但是通过对hudi的一个元数据设置就能把问题给搞定(详见上一篇文章),而在flink写hudi的环境里,必须要排除hive-exec这个包,也就是说,flink写hudi跟flink写hive的代码无法共存。
要知道,在我的这个软件工程里,spark写hudi的环境中,也是有hive-exec这个包的,但是它们之间并没有冲突,也就是说,spark写hudi的代码是可以跟spark写hive的代码共存的。
最后,虽然这个解决方案在我看来并不十分优雅,但因为时间和水平有限,暂时也只能这样了,等有更优的方案后,咱再更新可好...

原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

