由于最近同时用Spark和Flink来进行各种组件的测试,在面对同一个任务时,分别用Spark和Flink运行,会发现这两种任务在执行理念上差别很大。
比如,都是从kafka读取数据写hudi表,在设置并行度时,比如我想设置多少个worker,然后每个worker并行处理多少个任务(线程),这些我应该是可以通过数据分区的多少来判断的。
比如,我从kafka读取某个topic,这个topic有8个partition,那么我在设置计算引擎的并行度时,要么设置8个worker,每个worker只用一个并行度(1个CPU核心)。或者我设置4个worker,每个worker2个并行度(2个CPU核心)等等,以此来达到“计算一次过”的效果。
这种并行度设置,在我以往习惯里,用spark是完全没有问题的,通过指定多少个executor,以及每个executor用多少个核心,就能解决。
比如:
--executor-cores 2
--num-executors 4
但是用flink呢,虽然在提交参数上也可以设置并行度,但是不管你怎么设置,总有那么几个参数是不生效的,就很迷。
来,看个具体的例子。
0. 准备的案例
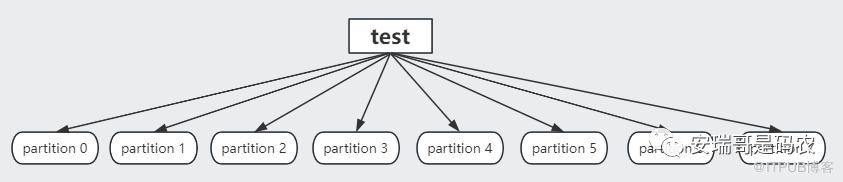
很简单,就是一个用spark以及flink读取kafka的test这个topic数据,然后写入hudi表。
这个topic一共有8个分区,按理说,如果我的并行度设置为8(通过设置worker数量,以及每个worker的并行数来确定),此时数据的读取和处理效率理论上一定是最高的。
1. Spark的运行状态
因为从Spark的UI界面,我可以非常清楚的知道数据源的分布情况:
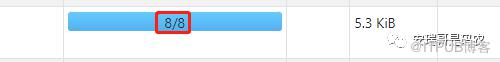
那么为了读取数据,以及后续的数据处理效率更高,于是可以设置其并行度如下:
--executor-cores 2
--num-executors 4
跑起来之后呢,查看UI界面是这样的:
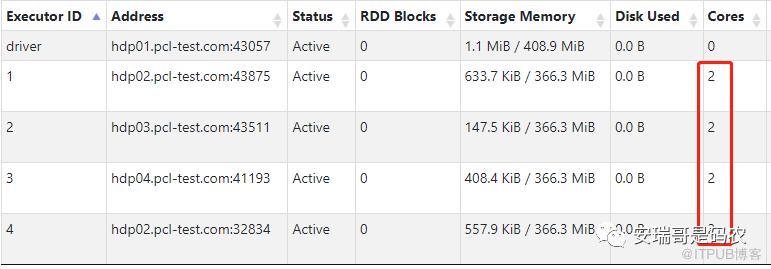
可以清楚看到,按照要求,这个任务分配了4个worker(executor),以及每台机器的并行度(线程)为2。
2. Flink的运行状态
这里主要想讨论它任务运行时跟并行度有关的参数问题,原本以为挺简单的一个事情,但是在flink的实现这里,却多少有点让人看不太懂。
官方文档列出了跟并行度有关的两个参数:
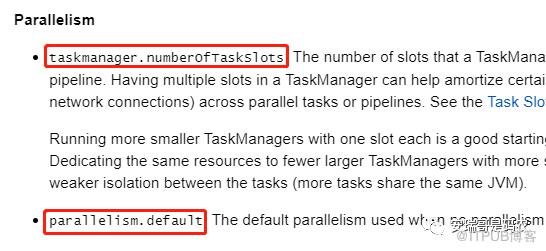
taskmanager.numberOfTaskSlots:
从它的解释,以及我的实践来看呢,这个参数应该类比spark的--executor-cores,也就是单个worker(flink叫taskmanager)执行时的并行度,或者说线程数。
从描述中可以看出来,它说你可以用少量的TaskManager配合数量多的slot,或者用数量大的TaskManager配合数量少的slot来完成相同并行度的任务。
不同点在于,前者的资源利用率更高;而后者,则任务之间的隔离性质更好,或者说可以避免复杂的计算场景时,多线程的问题(之前文章有讲这种情况下,相关的数据库连接问题)。
parallelism.default:
对于这个参数,文档描述的非常潦草,而网上的文章呢,也基本上解释的非常暧昧(其实就是没搞懂),但从我的实践来看,它指的是一个Flink任务的总并行度,也就是它的值,等于TaskManager启动的个数 * 每个TaskManager设置的slot的数量。
它跟spark启动命令中的--num-executors参数不太一样,spark的这个参数直接决定了worker数量的多少,而Flink的TaskManager启动数量,则需要被推算出来。
当参数taskmanager.numberOfTaskSlots设置为1时,parallelism.default设置的数量就是TaskManager启动的数量。
而当taskmanager.numberOfTaskSlots这个值不等于1,比如等于2,那么,parallelism.default的值除以2,才是TaskManager启动的数量。
但是,让人迷惑的是,在提交到yarn上执行时,对于这两个参数,有的能生效,而有的则不能。
2.1 先看yarn session模式
用这个模式来部署flink任务的最大特点就是,可以复用JobManager,也就是用一个共享的JobManager,可以管理多个flink任务,可以达到节省资源的目的。
先看看我只是单独启动yan-session(不指定任何额外参数),不提交任何任务其情况下,yan的资源消耗和各个角色(JobManager和TaskManager)的运行情况。
先瞅一眼YARN的资源占用:

只启动了一个container,也就是JobManager。
再瞅一眼flink的UI界面:
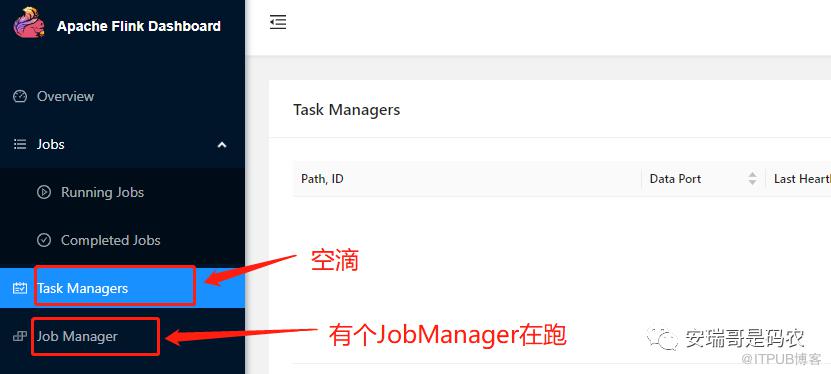
根据我的设想,我准备跟上面那个spark程序一样,设置4个worker(TaskManager),然后每个work给2个slot,这样一来它的并行度就应该为8了。
于是,我的运行任务提交参数是这样的:
flink run -d -t yarn-session \
-Dyarn.application.id=application_1691368711586_9064 \
-Dparallelism.default=8 \
-Dtaskmanager.numberOfTaskSlots=2 \
......
提交之后,再看一眼yarn的资源占用:

原来这个数字是1,也就是只运行了一个JobManager。
但是现在变成了9,也就是提交了一个flink任务之后,增加了8个container,而这8个container,就是运行的新任务的TaskManager,而新任务的JobManager复用原来那个。
如果这么来分析的话,那不对啊,不是根据上面的参数配置,说好了只会启动4个TaskManager,然后每个TaskManager启动2个slot吗?
怎么就启动了8个TaskManager呢?
带着疑问,再来看一眼flink的UI界面:
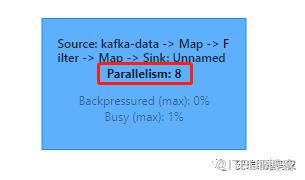
可以看到,新增了一个任务,而这个任务的并行度为8,但是这个8是怎么得来的呢?
继续看这里:
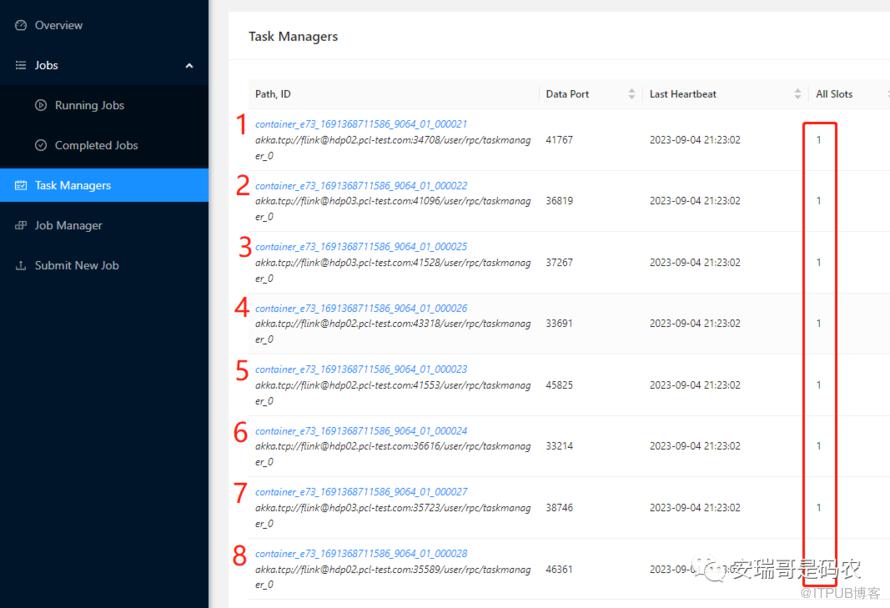
可以看到,这8个并行,是通过启动了8个container或者说8个TaskManager来实现的。
但是,从图中可以看出来,每个TaskManager却只分配了1个slot。
咦... 这是怎么回事呢?明明参数指定了这个slot数量为2啊。
参数写错了吗?
一番折腾对比,发现参数并没有写错,而是这个写在命令行里的这个指定slot的参数,确确实实没有生效。
这里比较奇葩的是,这个参数必须要在启动yarn-session这台服务中的配置文件中指定才可以(默认为1),也就是${FLINK_HOME}/conf/flink-conf.yml这个文件:
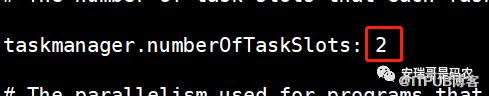
不是说好的,命令行指定的参数优先级,是要比配置文件的高吗?
这回居然在命令行中指定不生效,不知道这个情况是个案还是大家都这样,你说你丫要么就都不生效,要么就都生效,怎么还选择性生效呢?
改完之后,再启动这个任务,果然就符合预期了:
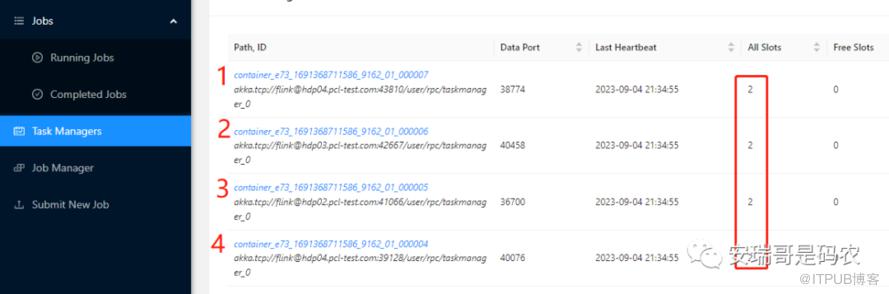
我只能说:顶你个肺!就不能让人省点心吗?
2.2 Per-Job Cluster模式
说完上面yarn session模式的奇葩之后,再来看per-job 模式的奇葩又在哪里。
来,我先把之前改过的配置文件恢复成默认的,再看我的提交命令:
flink run -m yarn-cluster \
-Dparallelism.default=8 \
-Dtaskmanager.numberOfTaskSlots=2 \
......
正常来说,应该启动4个TaskManager,然后每个TaskManager分配2个slot才对。
可是,启动后是这样的(注意这个启动方式跟yarn-session的区别)。
先看yarn的资源占用情况:

可以看到,这里面启动了2个container,一个肯定是JobManager,而另一个则只可能是TaskManager了。
从这里就可以看出来,上面命令行的参数没有生效,至少没有全部生效。
再看一眼Flink的UI界面:
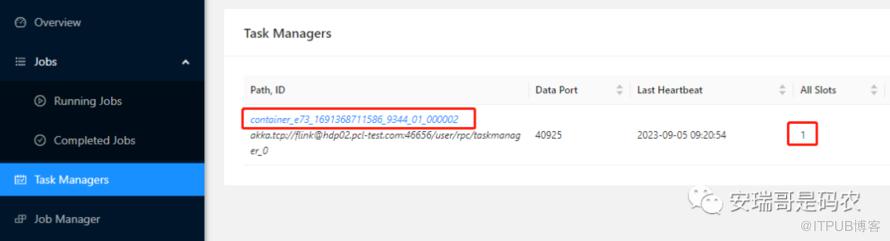
看到这就可以确定,这个Flink任务只启动了一个TaskManager,而且只分配了1个slot,也就是说,当前命令行中用来指定并行度的参数一个都没有生效。
参数既然不生效,那为啥也不报错呢?
找了一圈网上的资料,再根据flink任务提交的参数帮助命令,修改参数再试试:
flink run -m yarn-cluster \
-yn 4 \
-ys 2 \
......
其中,据说-yn是用来指定TaskManager的数量,而-ys是用来指定slot数量的。
但是,任务一提交就报错了,说-yn这个参数不存在:

那就只能去掉-yn参数了,再试。
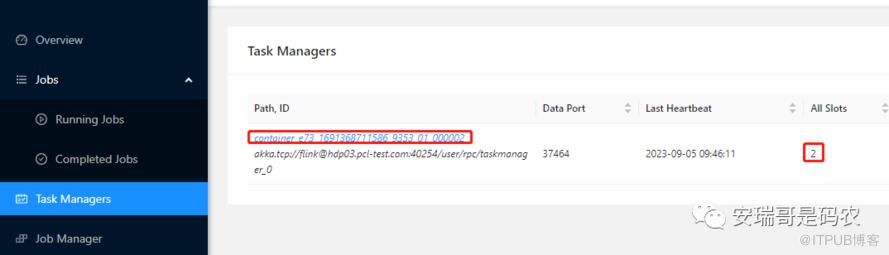
可以看到,这种在命令行的参数指定方式就只能让slot生效,而TaskManager数量却又控制不了。
那我就是想达到8的并行度,该怎么办呢?
现在就只剩一招了,修改${FLINK_HOME}/conf/flink-conf.yml这个文件里面,关于并行度的参数:
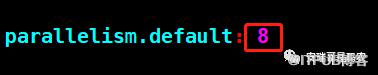
然后命令行参数不变的情况下,再提交任务,果然:

我只想说(唱):咱能不能简单点,配置的方式简单点。
通过上面的两个例子可以看出来,Flink这个并行度设置真的是谜一般存在。
对于yarn的两种不同运行方式,你得用两种不同的参数指定方式,这样程序才能识别,否则你都不知道为啥不生效。
而且即便是这样,其生效的对象,和失效的对象居然还各不相同。
如果说开发这块的人,脑子里要是没点毛病,我是万万不肯相信的。
3. 评价一下
从如上描述可以看出来,对于一个分布式(流式)任务来说,如果用spark,通过spark UI,你是可以非常直观看到它数据(在每个阶段)的并行分布情况的。
所以,你可以根据这个数据分布(分区数量)情况,再结合当前集群的资源情况,给这个任务设置合理的并行度。
但是对于Flink来说,这一点显然是办不到的,它的运行UI界面无法提供任何数据分布情况(并行度)的说明,所以,如何对一个Flink任务设置并行度,设置多少,很多时候你只能靠猜,关键就算是猜,这个设置方式估计也会让很多人一脸懵逼。
而对于这一点,Flink显然做得没有Spark好(或者说差太远)。
当然,spark也有槽点,它在每个container运行过程中,内存的分布情况,以及实时内存占用情况就没有Flink做得那么细致。
还是那句话,任何技术都有不完美的地方,就看你如何抉择。
如果是你,你选谁...

原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

