上篇文章聊了Spark跟Flink在面对一个分布式任务时,各自设置并行度的方式,并吐槽了其中Flink我个人认为不够人性化的地方。
那么这篇文章,我们再来对比一下Spark跟Flink在checkpoint这个机制上,又有哪些差异呢。
我们知道,对于一个流式任务来说,设置一个任务运行过程的检查点是非常有必要的,这样一来,就能让一个失败的流式任务,从上一个中断的状态继续完成剩下的计算,达到“断点续算”的目的。
而对于这种“断点续算”的机制,spark跟flink在实现上却有着比较大的差异,从使用体验上来说,spark的要简单很多,而Flink却用起来着实有些复杂和繁琐。
为此,咱们今天来就这个checkpoint在这两个计算引擎中的不同实现,做一番对比。
0. 对比前准备
对比的场景很简单,分别用spark的structured streaming和Flink的流式引擎对kafka的数据进行消费,然后将消费的数据写入HDFS的CSV文件。
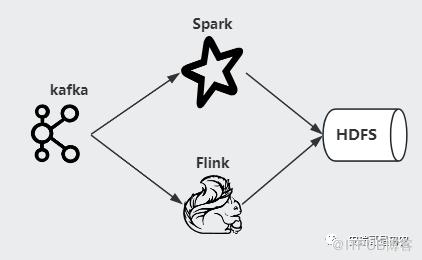
在这个过程中,会分别打开Spark和Flink的checkpoint机制,然后故意将程序停掉,然后再启动,看程序是否能根据checkpoint的记录,对kafka的数据从上次断掉的offset开始消费。
为了到达最好的演示效果,这次演示的大概顺序如下:
1. spark和flink程序分别都打开checkpoint功能,设置checkpoint间隔都为10秒,且消费kafka的模式都设置为latest模式,同时启动这2个程序;
2. 手动向kafka的topic一条条写入数据;确定spark和flink程序能正常消费到;
3. 手动停掉程序,在2个程序停止运行期间,继续向kafka推入一定数量的数据;
4. 重新启动spark和flink任务,看重新启动的程序是否都能正常消费到,程序停止期间推入到kafka的数据,也就是检验这个checkpoint是否真正发挥了作用。
1. Spark的checkpoint
从官方文档的描述来看,仅需一行代码,就能搞定。

而且呢,如果任务在运行中失败了,或者直接被kill掉,想从上次中断的地方重新接着开始,直接执行之前的任务提交命令就可以了,不用需要做任何额外的操作。
来,先瞅一眼任务启动前的数据目录和checkpoint目录:
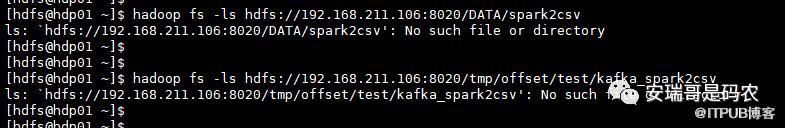
目前都为空。
1.1 启动spark程序(为一会方便停掉,用client模式提交):
spark-submit
--master yarn
--deploy-mode client
--executor-cores 2
--num-executors 2
......
启动后,暂时没有向kafka推任何数据,可以看到此时数据目录和checkpoint目录已经有了变化:
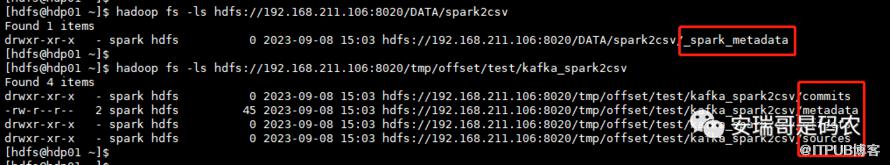
这两个目录下,分别都创建了对应的元数据信息。
其中,checkpoint目录下,有个offset的文件夹,里面清楚地记录了当前消费的topic每个partition的情况。
1.2 开始推数据
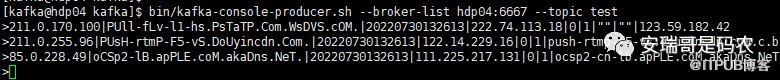
往目标topic推了3条数据,再来看数据目录的变化:

可以看到,刚才推kafka的3条数据已经写到HDFS的3个CSV文件中了。
1.3 停掉当前的spark进程
因为是用的client模式运行,因此直接在命令行CtrlC就可以停掉,然后继续向kafka推送2条数据。
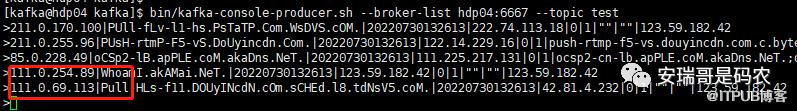
spark程序停止后,再推2条件数据
1.4 重新启动spark程序
还是用刚才一样的任务提交命令,继续启动任务:
spark-submit
--master yarn
--deploy-mode client
--executor-cores 2
--num-executors 2
......
再来看数据目录的变化:
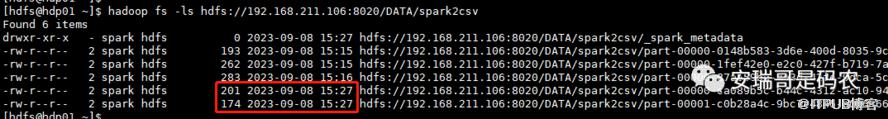
可以看到,刚才spark程序中断后,向kafka推送的2条数据,现在已经写进来了,说明此时的checkpoint发挥了作用。
因为spark的checkpoint会记录上次消费该topic每个partition的offset,如果不是,那么当前spark用的latest的消费模式,重新启动后,肯定是消费不到刚才推入的2条旧数据的。
结论:对于spark来说,想要实现“断点续算”的能力,只需要设置好checkpoint目录,任务失败后,直接重启就能做到。
2. Flink的checkpoint
相比spark,Flink的checkpoint可谓是各种花里花哨的配置拉满,表面上看,说是支持更丰富的功能,但实则大大增加了使用者的学习成本。
通过对官方文档的研读和理解,如果我想到达数据“断点续算”的效果,根据官方推荐,我得在代码这么来写(注:我的Flink版本为1.15):
val env = StreamExecutionEnvironment.getExecutionEnvironment
                .enableCheckpointing(10000, CheckpointingMode.EXACTLY_ONCE) //打开checkpoint功能
        env.setStateBackend(new EmbeddedRocksDBStateBackend(true)) //新的设置state backend的方式
        env.getCheckpointConfig.setCheckpointStorage("hdfs://192.168.211.106:8020/tmp/flink_checkpoint/FlinkDSFromKafka2HDFS") //设置checkpoint的hdfs目录
        env.getCheckpointConfig.setExternalizedCheckpointCleanup(ExternalizedCheckpointCleanup.RETAIN_ON_CANCELLATION) //设置checkpoint记录的保留策略
确保checkpoint的设置没有问题后,我们先来看一眼其对应的数据目录和checkpoint目录。
确保都是不存在的状态:
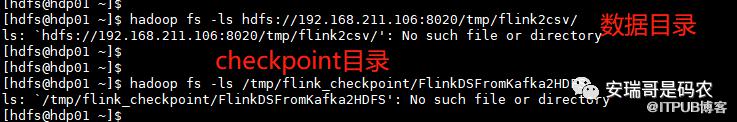
2.1 向yarn提交Flink程序
这里采用per-job cluster的方式向yarn提交flink任务:
flink run
-m yarn-cluster
-ys 2
-yjm 1000
-ytm 1200
......
任务成功提交之后,在没有向kafka推任何数据前,看一眼对应的数据目录和checkpoint目录:
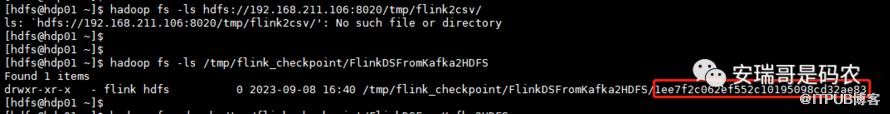
可以看到,当前数据目录因为没有数据,所以没有创建,这点跟spark有些不一样,spark则会创建。
而对于checkpoint目录,可以看到它相比spark,多了一级文件夹,而这个文件夹的命名,就是当前flink的jobID,这个是spark所没有的。
此外,在这个checkpoint目录里,目前有效的信息都在这个文件里,可以看出跟spark的不一样:

而且,这个chk文件夹,每10秒(设置的checkpoint间隔为10秒)会更新(递增)一次,即便是在没有数据的情况下。
2.2 向kafka推数据
为了跟spark一视同仁,新开一个窗口,也向其中推送3条数据:
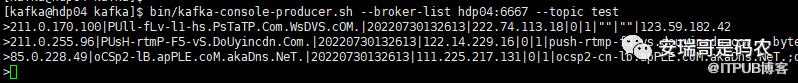
然后看数据目录的变化:
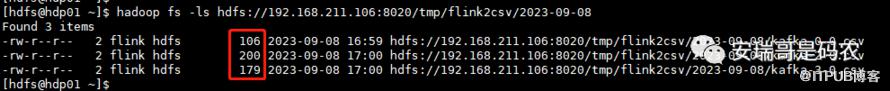
可以看到,这3条kafka的数据已经被Flink成功写入。
但是呢,虽然写成功了,却在Flink的UI界面发现一个有意思的现象,看这里:

这个进程中显示的数据量和条数居然都是0。
难道是瞧不上我只给了3条数据,四舍五入了吗?要知道,同样的界面,spark可是能够清楚地显示出来的。
2.3 停掉Flink进程
直接在Flink的UI界面cancel掉该进程,然后同样也是再向kafka推2条数据。
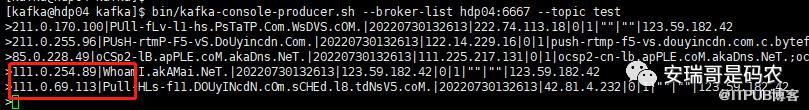
2.4 重启Flink任务
根据我以往对spark的认知,按理说既然已经设置了checkpoint,重启任务后,就应该自动会根据这个checkpoint目录中记录的元数据信息,来恢复原来的状态了。
咱们先来试一下,还是用当初启动Flink任务的命令,再次启动这个这个任务试试,看看能不能消费到刚才写入的2条数据。
flink run
-m yarn-cluster
-ys 2
-yjm 1000
-ytm 1200
......
确定任务启动成功后,先来看一眼数据目录:
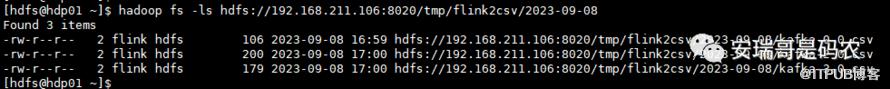
发现丝毫没有变化,数据文件还是之前的那3条。
再来看checkpoint的目录情况:

可以发现,新生成了一个子目录,而这个子目录的名称,其实就是新的jobID,跟新提交到yarn上面的UI路径保持一致。
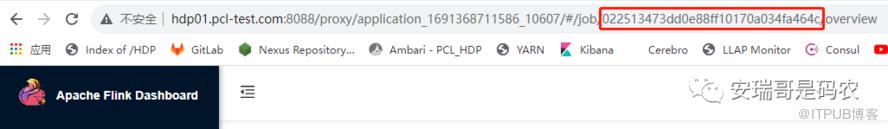
可是明明设置了checkpoint,而且checkpoint也确实记录了对应的信息,怎么就消费不到那2条数据呢?
原因只有一个:重新启动的方式不对。
通过查看Flink的官方文档描述得知,要想继续上一个任务的状态,就得用专门的恢复模式来启动:

也就是说,得加上这个额外的恢复参数才可以,另外你还得告诉flink进程,这个checkpoint目录在哪(关键我不是在代码中已经指定了吗).
我想说:不设计的这么复杂,是不是显不出你能耐?
2.5 从checkpoint恢复任务
既然Flink是这么设计的,那咱就得照做不是。
现在就只能kill掉当前的flink进程,然后找到第一次任务时对应的checkpoint目录,重新以恢复模式启动任务。
找到对应的HDFS目录后,重新提交启动命令:
flink run
-m yarn-cluster
-s hdfs://192.168.211.106:8020/tmp/flink_checkpoint/FlinkDSFromKafka2HDFS/1ee7f2c062ef552c10195098cd32ae83
-ys 2
-yjm 1000
-ytm 1200
......
可以看到,在原来提交命令的基础上,多加了个-s参数以及对应的目录。
提交之后,很快就报错了,后面发现这个-s参数要指定到具体的metadata文件,文件夹还不行,得这样:
-s hdfs://192.168.211.106:8020/tmp/flink_checkpoint/FlinkDSFromKafka2HDFS/1ee7f2c062ef552c10195098cd32ae83/chk-193/_metadata
但是呢,虽然这样之后,重新启动不报错了。
但是,那2条被遗忘的kafka数据,却还是没有恢复。
随后,我又用同样的方式尝试了大概10次,但依然没有成功,甚至我都用到了flink的savepoint功能,也通过savepoint去尝试恢复了:
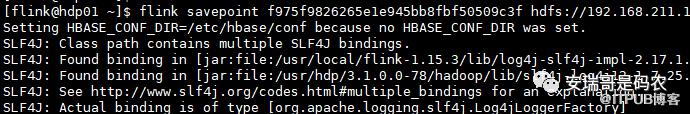
也查看了运行界面的checkpoint设置:

按道理,这个设置应该生效了呀,怎么就是识别不下那个任务失败后推进去的2条kafka数据呢?
2.6 修改exactly-once消费语义
最后我实在找不到原因了,抱着最后一试的想法,突发奇想会不会是这个“精确一次性消费”语义捣的鬼,虽然官方文档没有明确这么说。
于是,就把原本的这个“精确一次性”语义,给修改为“至少一次性”消费语义:

果然,修改完之后,就可以把任务停掉期间,推入到kafka的数据正常消费了。
但是,这样一改,也带来了一个问题,那就是数据的重复消费问题,在修改完这个“至少一次性”语义之后,重新启动程序之后,同一条数据,我明明只推了一次,任务期间也没有重启,但这条数据居然被写入了两次。

结论:想用Flink来实现这个简单场景的“断点续算”能力,真的有些麻烦,而且坑很多、且有瑕疵。
不知道Flink官方的人对此作何感想,是不是在你们眼里,即便是一个很简单的功能,只要实现的越麻烦,条件越苛刻,才能越显出你们的高水平。
最后
从这次基于当前的这个简单的需求场景来看,Spark和Flink的checkpoint功能对比测试,无论是使用的简洁程度,还是实现的完善程度,Spark绝对完胜Flink。
尽管可能Flink对外宣传在这方面的功能更加强大,但是,却不影响你拥有:使用成本高,bug多,难用的特点。
希望后续功能越来越完善,也越来越好用,别只顾一天到晚打广告,吹牛逼。

原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

