周末晚上直播的时候,演示了spark和flink面对kafka数据实时写HDFS的场景时(破站有直播回放),这两个计算引擎各自checkpoint的不同点对比,以及各自在恢复数据时的用法。
但是没想到,在演示到用Flink的checkpoint恢复数据时,翻车了,而且,翻的特别彻底。
上篇文章聊了,针对这个具体的案例,如果想要用Flink的checkpoint,来恢复程序停止期间向kafka写入的数据,除了要以恢复模式启动Flink任务外(启动命令中加入checkpoint的地址),还要确保当前的数据消费模式为“至少一次性消费”语义。
然而,本以为所有过程可以一切顺利地再来一遍的时候,却发现,当初的场景却再也复现不了,也就是无论我怎么折腾,Flink任务被kill期间,往kafka写入的这个数据,神奇般消失了。
在直播间的小伙伴看到这里,也都表示一脸懵逼,我也是第一次翻车翻地如此彻底。
后来群里有小伙伴表示不服,说你这个演示的场景角度是不是有点刁钻了,于是干脆,我又把之前写HDFS的代码,给改成了写Doris数据库,看这个丢数据的情况是不是还存在。
先给结论:涛声依旧(还是丢数据)。
0. 验证前准备
首先,版本为2.x的kafka集群,topic为test,一会手动向该topic推送数据;
然后,版本为1.15的Flink,配合版本为3.1的Hadoop集群,用Flink on yarn来消费kafka的数据;
接着,Flink对数据做简单的处理,然后写入Doris(版本为1.2.3)表,并且在写入过程中开启checkpoint。
其中doris的建表语句如下,用的非聚合功能表:
CREATE TABLE `dns_logs_from_flink01` (
  `client_ip` varchar(200) NULL,
  `domain` varchar(200) NULL,
  `time` varchar(200) NULL DEFAULT "99999",
  `target_ip` text NULL,
  `rcode` int(11) NULL DEFAULT "99",
  `query_type` int(11) NULL DEFAULT "99",
  `authority_record` varchar(500) NULL,
  `add_msg` varchar(200) NULL,
  `dns_ip` varchar(200) NULL
) ENGINE=OLAP
DUPLICATE KEY(`client_ip`, `domain`, `time`)
DISTRIBUTED BY HASH(`client_ip`) BUCKETS AUTO
为了保证验证的严谨,这里针对这个数据写入场景,分别准备了Flink的SQL API以及DataStream API。
因为Sparkd的流计算已经被验证过,只要设置了checkpoint,就不会存在“丢数据”的情况,所以,这次就不再重复验证,有兴趣的可以看上一篇文章。
1. 先看Flink的SQL API
完整代码如下:
package com.anryg.doris

import java.time.Duration

import org.apache.flink.contrib.streaming.state.EmbeddedRocksDBStateBackend
import org.apache.flink.streaming.api.CheckpointingMode
import org.apache.flink.streaming.api.environment.CheckpointConfig.ExternalizedCheckpointCleanup
import org.apache.flink.streaming.api.scala.StreamExecutionEnvironment
import org.apache.flink.table.api.bridge.scala.StreamTableEnvironment

/**
  * @DESC: 通过SQL API读取kafka数据,写入到Doris
  * @Auther: Anryg
  * @Date: 2023/9/3 11:29
  */
object FlinkSQLFromKafka2Doris {

    def main(args: Array[String]): Unit = {
        val env = StreamExecutionEnvironment.getExecutionEnvironment

        env.enableCheckpointing(10000L)/**这个必须加上,否则数据写不进Doris*/
        env.setParallelism(args(0).toInt) //设置并行度

        env.setStateBackend(new EmbeddedRocksDBStateBackend(true)) //新的设置state backend的方式
        env.getCheckpointConfig.setCheckpointStorage("hdfs://192.168.211.106:8020/tmp/flink_checkpoint/FlinkSQLFromKafka2Doris")
        env.getCheckpointConfig.setExternalizedCheckpointCleanup(ExternalizedCheckpointCleanup.RETAIN_ON_CANCELLATION) //设置checkpoint记录的保留策略
        env.getCheckpointConfig.setAlignedCheckpointTimeout(Duration.ofMinutes(1L))
        env.getCheckpointConfig.setCheckpointingMode(CheckpointingMode.AT_LEAST_ONCE)

        val tableEnv = StreamTableEnvironment.create(env)

        /**第一步:读取kafka数据源*/
        tableEnv.executeSql(
            """
             Create table dns_logs_from_kafka(
             |client_ip STRING,
             |domain STRING,
             |`time` STRING,
             |target_ip STRING,
             |rcode STRING,
             |query_type STRING,
             |authority_record STRING,
             |add_msg STRING,
             |dns_ip STRING
             |)
             |with(
             |'connector' = 'kafka',
             |'topic' = 'test',
             |'properties.bootstrap.servers' = '192.168.211.107:6667',
             |'properties.group.id' = 'FlinkSQLFromKafka2Doris',
             |'scan.startup.mode' = 'latest-offset',
             |'value.format'='csv',                                 //确定数据源为文本格式
             |'value.csv.field-delimiter'='|'                      //确定文本数据源的分隔符
             |)
            """.stripMargin)

        /**第二步:创建Doris映射表*/
        tableEnv.executeSql(
            s"""
              |CREATE TABLE dns_logs_from_flink01 (
              |`client_ip` STRING,
             |domain STRING,
             |`time` STRING,
             |target_ip STRING,
             |rcode STRING,
             |query_type STRING,
             |authority_record STRING,
             |add_msg STRING,
             |dns_ip STRING
              |)
              |    WITH (
              |      'connector' = 'doris',
              |      'fenodes' = '192.168.221.173:8030',
              |      'table.identifier' = 'example_db.dns_logs_from_flink01',
              |      'username' = 'root',
              |      'password' = '',
              |     'sink.label-prefix' = '${args(1)}'  //导入标签前缀
              |)
            """.stripMargin)

        /**第三步:数据写入到Doris表中*/
        tableEnv.executeSql(
            """
              |INSERT INTO dns_logs_from_flink01
              |select
              |*
              |from
              |dns_logs_from_kafka
            """.stripMargin)

    }
}
在启动任务前,先确保其checkpoint目录为空,以及表中没有数据:

确保checkpoint为空
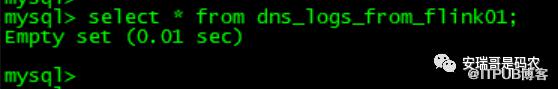
确保表中无数据
然后,启动Flink任务:
flink run
-m yarn-cluster
-ys 2
-yjm 1000
-ytm 1200
-ynm Flink2Doris
......
确保任务正常启动后,开始往kafka手动推数据,先推两条(注意思考这里的先后顺序,为什么要这样):

很快,就可以在Doris中查到这两条数据:
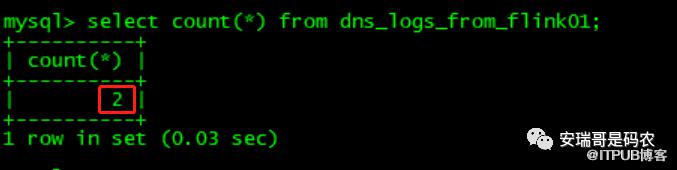
可以看到,这个时候,数据是可以正常写入到Doris表中的,说明写入数据的代码没有问题,而且对于checkpoint目录,也有记录对应的内容:

接下来,就是停掉当前Flink进程,然后再手动向kafka推入2条数据:
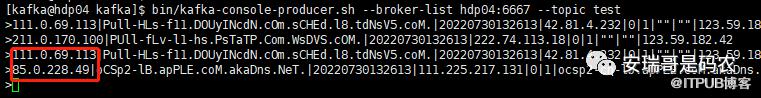
然后,根据Flink官方文档的要求,对当前任务进行恢复性启动:
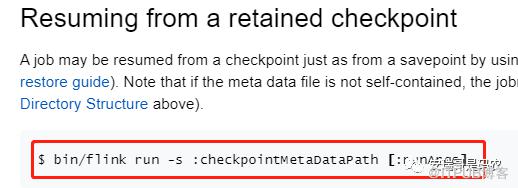
先找到对应的checkpoint元数据绝对路径:

根据该路径,执行恢复启动命令如下:
flink run
-s hdfs://192.168.211.106:8020/tmp/flink_checkpoint/FlinkSQLFromKafka2Doris/69aea640a59961021add33a5bf0350b0/chk-103/_metadata
-m yarn-cluster
-ys 2
-yjm 1000
-ytm 1200
-ynm Flink2Doris
......
执行后,很快,任务启动成功。
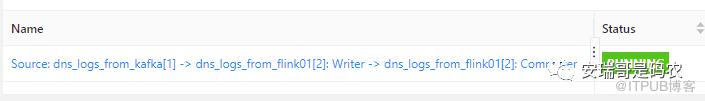
按理说,这应该是flink状态恢复的正确姿势了,那姿势正确了,刚推到kafka的那2条数据就应该会被写入到Doris表中,此时再查,就应该有4条数据了。
然鹅,事实并非如此(为了严谨,我先后查了不下10次):
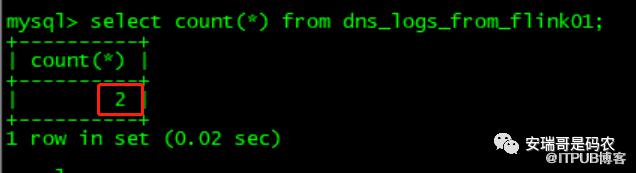
这就意味着,刚才推到kafka的2条数据,丢....了....
但是呢,我心不死,想继续用DataStream API再试一次。
2. 再看Flink的DataStream API
还是看一眼代码:
package com.anryg.doris

import java.util.Properties

import com.alibaba.fastjson.JSONObject
import org.apache.flink.api.common.serialization.SimpleStringSchema
import org.apache.flink.connector.kafka.source.KafkaSource
import org.apache.flink.connector.kafka.source.enumerator.initializer.OffsetsInitializer
import org.apache.flink.streaming.api.CheckpointingMode
import org.apache.flink.streaming.api.environment.CheckpointConfig.ExternalizedCheckpointCleanup
import org.apache.flink.streaming.api.scala.StreamExecutionEnvironment
import org.apache.doris.flink.cfg.DorisOptions
import org.apache.doris.flink.sink.DorisSink
import org.apache.doris.flink.cfg.DorisExecutionOptions
import org.apache.doris.flink.cfg.DorisReadOptions
import org.apache.doris.flink.sink.writer.{DorisRecordSerializer, SimpleStringSerializer}
import org.apache.flink.api.common.eventtime.WatermarkStrategy
import org.apache.flink.contrib.streaming.state.EmbeddedRocksDBStateBackend

/**
  * @DESC: 通过DataStream API读取kafka数据,写入到Doris
  * @Auther: Anryg
  * @Date: 2023/8/3 17:05
  */
object FlinkDSFromKafka2Doris {

    def main(args: Array[String]): Unit = {
        //获取流任务的环境变量
        val env = StreamExecutionEnvironment.getExecutionEnvironment
                .enableCheckpointing(10000, CheckpointingMode.AT_LEAST_ONCE) //打开checkpoint功能
        //env.setRuntimeMode(RuntimeExecutionMode.BATCH)

        env.setParallelism(args(0).toInt)

        env.setStateBackend(new EmbeddedRocksDBStateBackend(true)) //新的设置state backend的方式
        env.getCheckpointConfig.setCheckpointStorage("hdfs://192.168.211.106:8020/tmp/flink_checkpoint/FlinkDSFromKafka2Doris") //设置checkpoint的hdfs目录
        env.getCheckpointConfig.setExternalizedCheckpointCleanup(ExternalizedCheckpointCleanup.RETAIN_ON_CANCELLATION) //设置checkpoint记录的保留策略

        val kafkaSource = KafkaSource.builder()  //获取kafka数据源
                .setBootstrapServers("192.168.211.107:6667")
                .setTopics("test")
                .setGroupId("FlinkDSFromKafka2Doris")
                .setStartingOffsets(OffsetsInitializer.latest()) //确认消费模式为latest
                .setValueOnlyDeserializer(new SimpleStringSchema())
                .build()

        import org.apache.flink.streaming.api.scala._  //引入隐式转换函数,需要将从kafka读出来的数据做隐式转换

        /**配置Doris相关参数*/
        val dorisBuilder = DorisOptions.builder
        dorisBuilder.setFenodes("192.168.221.173:8030")
                .setTableIdentifier("example_db.dns_logs_from_flink01")
                .setUsername("root")
                .setPassword("")

        /**确定数据写入到Doris的方式,即stream load方式*/
        val executionBuilder = DorisExecutionOptions.builder
        executionBuilder.setLabelPrefix("flink-doris-label04") //streamload label prefix

        /**添加额外的数据格式设置,否则写不进去*/
        val properties = new Properties
        properties.setProperty("format", "json")
        properties.setProperty("read_json_by_line", "true")

        executionBuilder.setStreamLoadProp(properties)

        /**确定Doris的Sink数据方式*/
        val builder = DorisSink.builder[String] //注意这个数据类型String 需要加上
        builder.setDorisReadOptions(DorisReadOptions.builder.build) //确定数据读取策略
                .setDorisExecutionOptions(executionBuilder.build) //确定数据执行策略
                .setSerializer(new SimpleStringSerializer())  //确定数据数据序列化(写入)类型
                .setDorisOptions(dorisBuilder.build) //添加Doris配置

        /**读取数据源生成DataStream对象*/
        val kafkaDS = env.fromSource[String](kafkaSource, WatermarkStrategy.noWatermarks(),"kafka-data")

        /**对读取的数据进行处理*/
        val targetDS = kafkaDS.map(line => {
            val array = line.split("\\|")
            array
        }).filter(_.length == 9)
          .map(array => {
              val json = new JSONObject()  /**将数据封装为json对象*/
              json.put("client_ip",array(0))
              json.put("domain",array(1))
              json.put("time",array(2))
              json.put("target_ip",array(3))
              json.put("rcode",array(4))
              json.put("query_type",array(5))
              json.put("authority_record",array(6))
              json.put("add_msg",array(7))
              json.put("dns_ip",array(8))
              json.toJSONString /**转换为json string*/
          })

        targetDS.sinkTo(builder.build())

        env.execute("FlinkDSFromKafka2Doris")
    }
}
还是跟上面一样的步骤,停掉之前的任务,清空数据库的表,同时清除checkpoint目录。
然后启动Flink任务,接着向kafka推2条数据,确保数据成功写入Doris表,证明代码逻辑没有问题。
再停掉Flink进程,然后再向kafka推2条数据,再通过恢复模式启动当前的Flink任务,确保执行步骤跟之前的一样。
但是,然并卵。
依然消费不到后推入的那2条数据,再一次证明,在当前场景下Flink会丢数据。
3. yarn-session模式和yarn-cluster模式
为了能尽可能证明Flink的恢复数据能力,我算是各种情况都试了个遍,上面先是用yarn-cluster模式分别用Flink的SQL api以及DataStream api做了尝试。
然后我又用了yarn-session模式来提交同样的任务,以同样的流程又测试了一遍,发现,还是不行,说什么就是无法恢复那后续推入的2条数据。
而且发现一个奇怪的现象,明明是一毛一样的代码,且代码中也设置了checkpoint的相关配置,但是对于yarn-cluster模式,在其运行的UI界面里,看不到checkpoint的任何信息:

而如果是yarn-session模式呢,又是可以看到的:
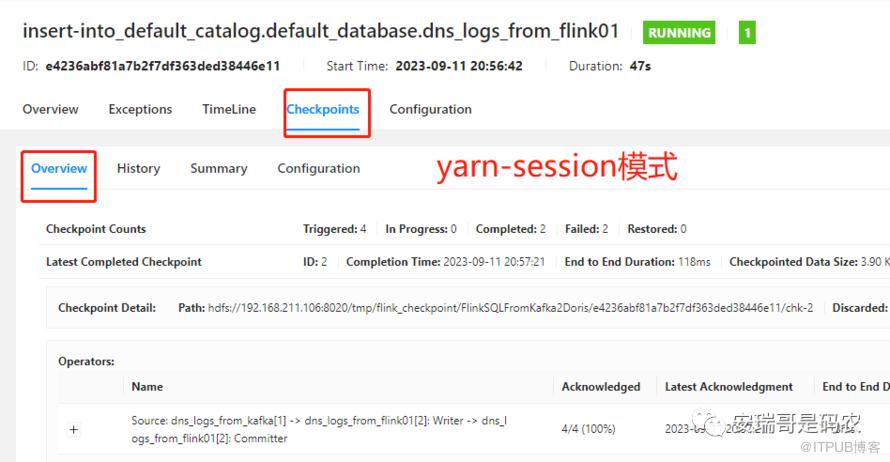
但,虽然后者可以显示出checkpoint的信息,似乎也没有什么卵用,因为它恢复不了我想要的数据。
最后
其实我还尝试了对任务设置savepoint,用savepoint的方式来恢复,虽然整个任务运行都没有异常,但就是,恢 复 不 了。
对于Flink来说,这“消失的2条kafka数据”似乎成为了一桩悬案,我暂时是破解不了了。
不知道是我恢复的方式不对呢,还是说Flink的设定就不允许我这么玩。
也许你,可以根据这个场景也来试验一把,看问题到底出在哪...
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

