上篇文章给大家掰扯了下数据湖的概念,根据自己的经验谈了下我对这个概念的理解。
以及通过对当下3个比较主流的所谓数据湖技术(hudi、iceberg、delta),根据其提供的功能,为其下了个我自认为比较贴切的定义:
介于分布式文件系统与普通数据库之间的,同时继承了文件系统中数据对使用者直接可见的优点,以及数据库对数据的schema,metadata和事务管理能力的优点。
但同时,又摒弃了文件系统存储松散,数据库技术又过于厚重缺点的,这么一个数据管理中间件。
因为必须要依附分布式文件系统而存在,且作为一个可插拔式的数据管理策略,因此它往往需要配合其他数据读写组件一起来使用,比如Spark、Flink等。
上篇文章大概描述了hudi当前最新版本(0.13.1)跟spark3.2的兼容情况。
那么这篇文章就具体来看看,用spark3.2 的structured streaming 跟hudi 0.13.1在配合时,对数据的读写兼容性到底如何,以及这过程中又会出现哪些坑呢?
本文将通过spark structured streaming读取kafka实时流数据写hudi表,以及对写入后的数据进行读取来展开说明。
0. 配置开发环境
要想把spark跟hudi一起玩起来,第一步就是配置这两者的开发环境,因为之前我的软件工程中的spark环境已经有了,此时,只需要在添加一个hudi依赖即可,于是在pom.xml文件中加入该依赖:

这一步在idea中完成,此外无需任何其他依赖。
1. spark读取kafka
上面依赖添加之后呢,就根据官网给的要求来编码,但区别在于,官网给的是生成数据写hudi的例子,而我这里,用的是dns日志数据。
其中读取kafka部分的代码如下(后面会给完整代码):

这里都是很常规的操作,没什么好说的。
但是这里需要注意我框出来的部分,这个额外配置必须加上,否则会有如下报错:
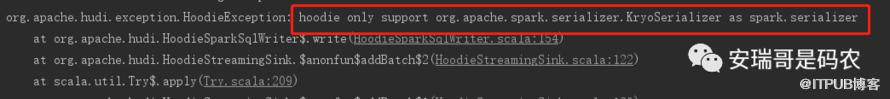
意思是在通过spark写hudi表时,目前只能支持KryoSerializer的序列化方式写入,因此必须要加上这个序列化的配置。
而且有意思的是,官网说必须要添加的另外一个配置(spark.sql.catalog.spark_catalog):
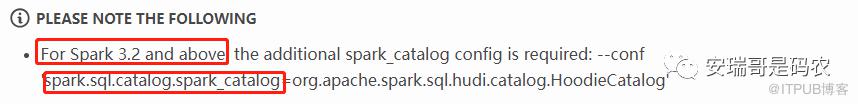
但在实际我的测试过程中,把这个配置注释掉后,数据也能正常写入到hudi表,没有影响。
2. 对读取kafka的数据格式处理
由于我没有直接找到官网中,spark写入到hudi表的数据格式要求的描述,就把原始数据给转换成为最主流的DataFrame格式(给每个字段额外添加字段名的方式)。

这个过程也简单,没什么额外值得去注意的,事实证明,这个格式,没毛病。
3. 数据写hudi表
最后一步,也是问题最多的一步,按理来说,根据官网给的这个样例来操作应该不会有多大问题呀:
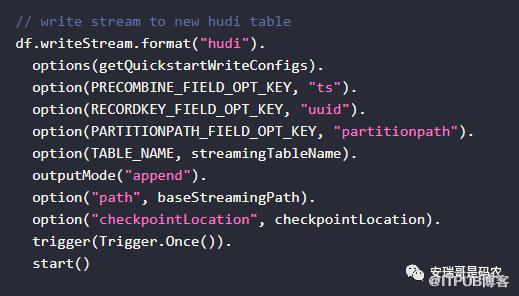
官网给的流数据写入案例
但是呢,我按照它这么来写后,代码变成了这样:
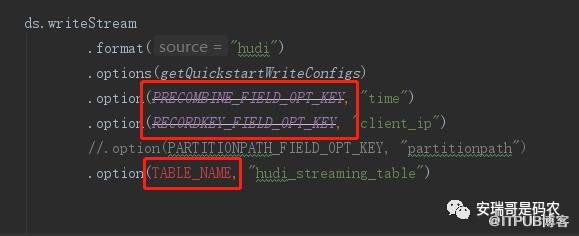
上面框框中的两个好理解,变量名被抛弃掉了,需要升级成新的变量名。
但是下面这个TABLE_NAME变量名,直接就找不到了。
可是,我已经根据官网的要求,该import的第三方引用,全都都引入了呀:

那就只能说明一个原因,官网给的样例代码根本就不是最新的(虽然它自己说是)。
其实像这种货不对版的情况,在很多开源软件的官方文档中均出现过,这个时候一般就只剩一招了,那就是看源码。
4. 读源码定位问题
前两个因为变量名在新版本已经被deprecated,抛弃不用了,那既然这样,咱必须得搞清楚最新版本的这个变量名叫啥。
先要明确一点,上面图中被我用框框出来的3个变量设置,是必须要添加的,否则数据写入hudi表会报错。
打开源码可以看到:
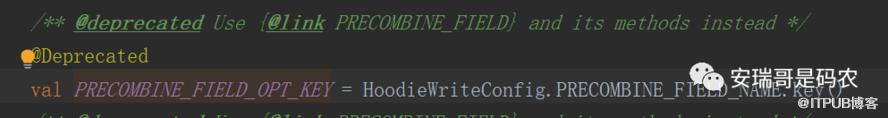
既然被新版本抛弃了,那么它就会告诉你,该去用哪个最新的变量。
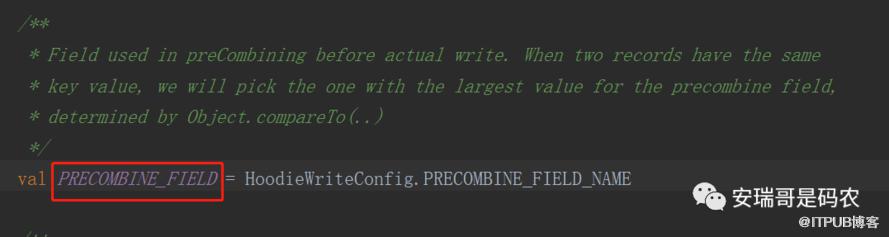
以及新的这个变量key该如何使用。
用同样的办法,把上面两个过期的变量给改成下面的写法:

但是呢,还有一个棘手的问题就是,这个TABLE_NAME变量,说它在现有的引入类中没有找到,咋办呢?
我在其中一个配置类的源码中找到了这个变量:
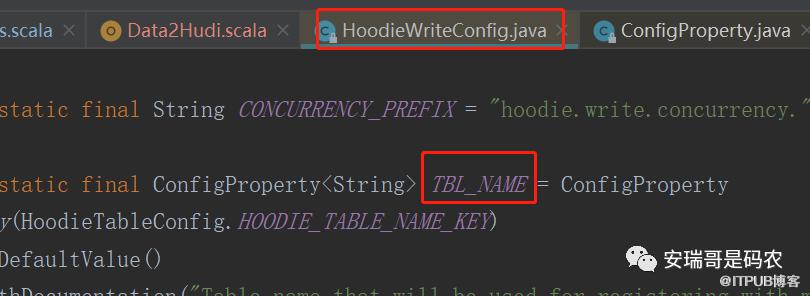
于是,就可以这么来解决:
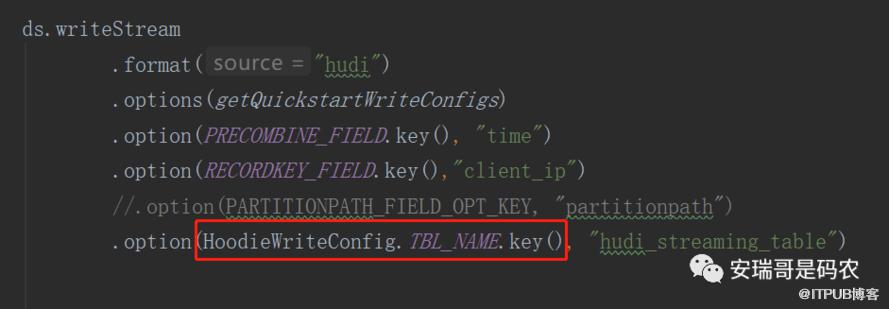
这里来解读一下这3个关键配置:
1. PRECOMBINE_FIELD.key() (必须指定): 源码给的解释是,在每个批次数据写入hudi表之前,会根据这个指定key(可指定多个字段),来比较其对应的value,只保留value最大的那条记录,类似于一些数据库的版本控制功能;
2. RECORDKEY_FIELD.key() (必须指定):类似于普通数据库表中的primary key(可指定多个字段),用来以分区为单位进行数据去重,确保该key的记录数唯一;
3. HoodieWriteConfig.TBL_NAME.key() (必须指定):指定hudi的写入表名字,虽然跟后面的存储路径有重名的地方,但还是必须指定;
4. 分区字段key (可以不用指定):跟hive一样,确定分区字段,虽然官网说这是个必须字段,但是经证实,这个可以不用指定,也可以顺利写入数据。
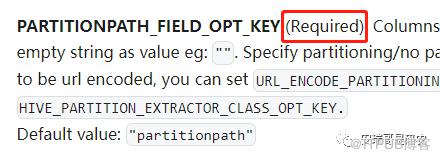
官网说必须,其实可以不用
5. 完整示例代码
以上问题解决完毕,这个示例的完整代码如下:
package com.anryg.bigdata.streaming.hudi


import org.apache.spark.SparkConf
import org.apache.spark.sql.SparkSession
import org.apache.spark.sql.streaming.OutputMode

/**
  * @DESC: structured streaming读取kafka写hudi
  * @Auther: Anryg
  * @Date: 2023/8/16 10:05
  */
object Data2Hudi {
    def main(args: Array[String]): Unit = {
        val conf = new SparkConf().setAppName("Data2Hudi").setMaster("local[*]")
        //conf.set("spark.sql.catalog.spark_catalog","org.apache.spark.sql.hudi.catalog.HoodieCatalog") //官网说spark3.2以及以上版本,这个配置必须要加上,但实际上不加也没事
        conf.set("spark.serializer","org.apache.spark.serializer.KryoSerializer")//必须加上,hudi目前只支持这种序列化方式
        //conf.set("spark.sql.extensions","org.apache.spark.sql.hudi.HoodieSparkSessionExtension") //官网案例有加这个配置,但实际测试不加也没事
        val spark = SparkSession.builder().config(conf).getOrCreate()

        val rawDF = spark.readStream //获取数据源
                .format("kafka") //确定数据源的来源格式
                .option("kafka.bootstrap.servers", "192.168.211.107:6667") //指定kafka集群的地址,理论上写一个broker就可以了
                .option("subscribe","test")  //指定topic
                //.option("group.id","test9999") /**不再用该方式来绑定offset,而是每个程序有个唯一的id,该id跟checkpointLocation绑定,虽然group.id属性在运行中依然保留,但是不再跟offset绑定*/
                .option("failOnDataLoss",false)  //如果读取数据源时,发现数据突然缺失,比如被删,则是否马上抛出异常
                .option("fetchOffset.numRetries",3)  //获取消息的偏移量时,最多进行的重试次数
                .option("maxOffsetsPerTrigger",100)/**用于限流,限定每次读取数据的最大条数,不指定则是as fast as possible,但是每次只取最新的数据,不取旧的*/
                .option("startingOffsets","earliest")  //第一次消费时,读取kafka数据的位置
                .load()

        import spark.implicits._

        val ds = rawDF.selectExpr("CAST(value AS STRING)")  //将kafka中的数据的value转为为string,原始为binary类型
                .map(row => {
                    val line = row.getAs[String]("value") //获取row对象中的field,其实也只有一个field
                    val msgArray = line.split("\\|")  //指定分隔符进行字段切分
                    msgArray
                }).filter(_.length == 9) //只留字段数为9的数据
                  .filter(_(2).length == 14) //保留时间字段合格的数据
                  .map(array => (array(0),array(1),array(2),array(3),array(4),array(5),array(6),array(7),array(8))) //将其转化成为元组,为了方便下一步赋予schema
                  .toDF("client_ip","domain","time","target_ip","rcode","query_type","authority_record","add_msg","dns_ip") //给裸数据添加字段名

        import org.apache.hudi.config.HoodieWriteConfig
        import org.apache.hudi.DataSourceWriteOptions._
        import org.apache.hudi.QuickstartUtils._

        ds.writeStream
                .format("hudi")
                //.options(getQuickstartWriteConfigs) //非必须设置
                .option(PRECOMBINE_FIELD.key(),"time") //必须设置
                .option(RECORDKEY_FIELD.key(), "client_ip")//必须设置
                //.option(PARTITIONPATH_FIELD.key(), "partitionpath")
                .option(HoodieWriteConfig.TBL_NAME.key(),"hudi_streaming_table03")//必须设置
                .outputMode(OutputMode.Append())
                .option("path", "hdfs://192.168.211.106:8020/tmp/hudi/hudi_streaming_table04")
                .option("checkpointLocation","hdfs://192.168.211.106:8020/tmp/offset/test/Data2Hudi04")
                //.trigger(Trigger.ProcessingTime(10,TimeUnit.SECONDS))/**每秒执行一次,不指定就是as fast as possible*/
                .start()
                .awaitTermination()

    }
}
这样,直接在idea上运行,就可以把数据顺利写入hudi表了。
6. 用spark读取hudi
因为写入的hudi表数据没法像一般数据库一样,通过一个查询客户端用sql来查询。
于是,还是只能用spark来验证写入的数据是否正确,spark读取hudi的简单代码:
/**
  * @DESC: spark读取hudi表
  * @Auther: Anryg
  * @Date: 2023/8/16 15:35
  */
object ReadHudi {

    def main(args: Array[String]): Unit = {
        val conf = new SparkConf().setAppName("ReadHudi").setMaster("local[*]")
        val spark = SparkSession.builder().config(conf).getOrCreate()

        val ds = spark.read
                .format("hudi")
                .load("hdfs://192.168.211.106:8020/tmp/hudi/hudi_streaming_table03") //指定hudi的数据路径

        ds.show(10)
        ds.printSchema()
    }
}
跑出来的结果是这样式的:
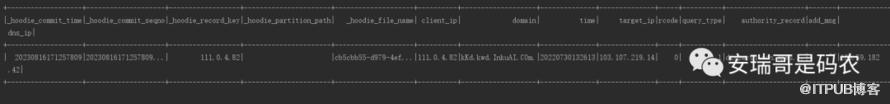
可以看出来通过以上方式,就可以轻松把写入的数据读取出来。
最后
从以上步骤来看,通过spark写入hudi表的过程依然没有想象中那么简单,依然要经历一些坎坷。
但是通过这一过程,也算大致摸清楚了这玩意的玩法跟套路,从目前表现来看,跟ORC或者parquet的数据写入方式非常的相似。
至于它还能在哪些地方体现出它的优越性或者缺陷,咱下一篇接着聊...
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

